融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


爲什麼「數據可用性」對區塊鏈擴容來說至關重要?
原文標題:《 WTF is Data Availability? 》
原文來源:Blockchain Capital Blog
原文作者:Yuan Han Li
原文編譯:Kxp,律動 BlockBeats
你可能聽說了,Ethereum 的分片路線圖已經基本上取消了執行分片,如今只專注於數據分片,從而使 Ethereum 的數據空間吞吐量最大化。
你可能也看到了最近關於模塊化區塊鏈的討論,深入地研究了 Rollup,瞭解了 volitions 與 validiums,然後也聽說了「數據可用性解決方案」。
但是,在這個過程中你可能也會產生一個疑問:「到底什麼是數據可用性?」。
在我們開始解釋這個問題之前,我們可以先來回顧一下大多數區塊鏈的工作原理。
交易、節點與惡名昭著的區塊鏈三難困境問題
當你遇到了一個新的 OHM 分叉,如果它有着高得驚人的年利率,那你肯定會毫不猶豫的按爆「質押」那個按鈕。但是,當你在上 Metamask 提交交易時會發生什麼?
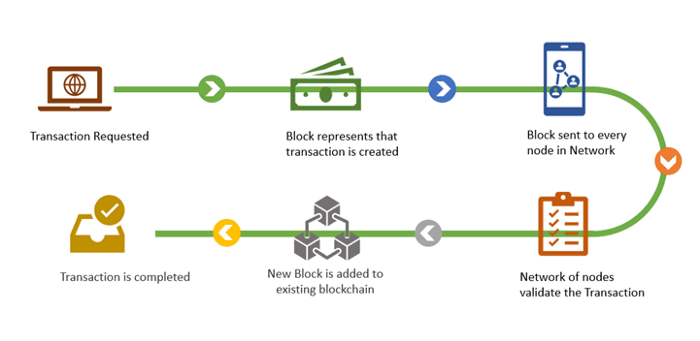
簡單來說,你的交易會進入到內存池當中,假設你給礦工或驗證者的賄賂足夠高,你的交易會被放入到下一個區塊中,並被添加到區塊鏈上供後人查閱。然後,這個包含着你交易的區塊會被髮送到區塊鏈的節點網絡中。之後,全節點將下載這個新的區塊,執行並計算這個區塊中包含的每一筆交易(其中當然也包括你的那筆交易),同時確保這些交易都是有效交易。比如,在你的交易中,這些全節點可能會驗證你是否有從其他人那裏竊取資金,以及你是否有足夠的 ETH 來支付 Gas 費等等。因此,全節點的重要任務便是對礦工和驗證者執行區塊鏈的各項規則。
正是因爲這一機制,傳統區塊鏈便出現了擴容的問題。由於全節點會檢查每筆交易以驗證它們是否遵循區塊鏈的規則,因此區塊鏈無法在不提高硬件水平的情況下每秒鐘處理更多的交易(更好的硬件會強化全節點的功能,而更強大的全節點可以驗證更多交易,這樣就能有更多可以包含大量交易的區塊了)。但是,如果運行全節點的硬件要求提高了,那麼全節點的數量就會變少,而去中心化的進程也會受到影響——如果能夠確保礦工/驗證者遵守規則的人少了的話,那情況就相當危險了(因爲信任假設數量就會增加)。
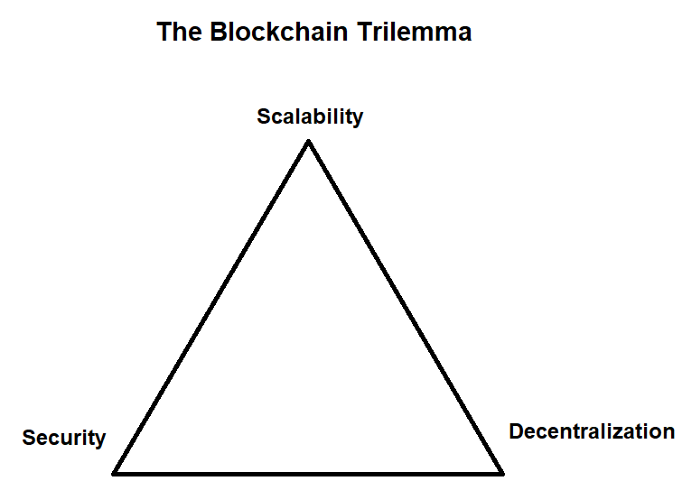
數據的可用性是我們不能同時擁有擴容、安全與去中心化的主要原因之一
這種機制也說明了在傳統單片式區塊鏈中保證數據可用性的重要性:區塊生產者(礦工/驗證者)必須公佈並提供他們生產區塊的交易數據,以便全節點來檢查他們的工作。如果區塊生產者不提供這些數據的話,全節點就無法檢查他們的工作,而且也就無法確保他們有在遵守區塊鏈規則。
現在你應該理解了爲什麼數據可用性在傳統單片式區塊鏈中非常重要了,接下來讓我們來探討一下它在人見人愛的可擴展性解決方案——Rollup 中扮演着怎樣的角色。
在 Rollup 背景下,數據可用性發揮着怎樣的重要性
讓我們先來重溫一下 Rollup 是如何解決可擴展性問題的:與其提高運行全節點的硬件要求,爲什麼我們不去減少全節點需要驗證有效性的交易數量?我們可以將交易的計算和執行工作從全節點交由給一個更強大的計算機(也被稱爲序列器)來完成。
但這是否也意味着我們必須信任序列器?如果全節點的硬件要求要保持在較低水平,那麼在檢查工作時,它們的速度肯定會慢於序列器。那麼,我們如何確保這個序列器提出的新區塊是有效的呢(也就是說,要保證該序列器並沒有在竊取大家的資金)。鑑於這個問題一直被反覆提及,我相信你已經知道了這個問題的答案,但也請你繼續耐心讀完接下來的內容(如果你想不起來了,不妨讀讀Benjamin Simon和Vitalik的這兩篇文章來重溫一下):
對於 Optimistic Rollup,我們可以靠欺詐證明來維持序列器的可靠性(除非有人提交了欺詐證明,表明序列器中包含有一個無效或惡意的交易,我們一般都默認序列器能夠可靠運作)。但是,如果我們想讓其他人也能計算欺詐證明,那麼他們便會需要序列器所執行的交易數據,以便提交欺詐證明。換句話說,序列器必須提供交易數據,否則沒人能保證 Optimistic Rollup 序列器的可靠性。
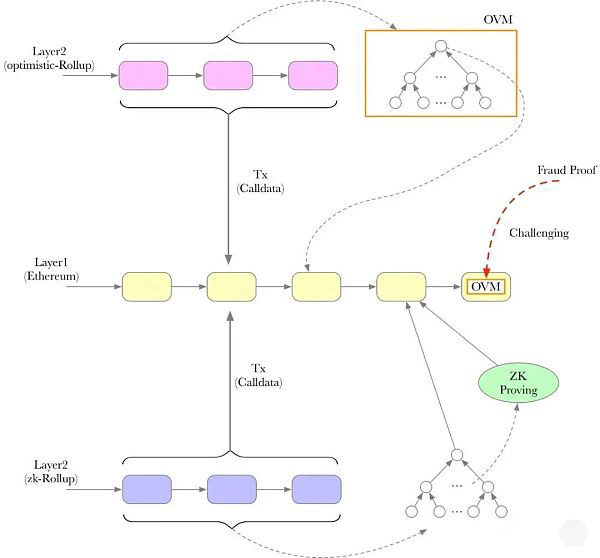
有了 ZK Rollup,保證序列器的可靠性就變得簡單多了——序列器在執行一批交易時必須提交有效性證明(ZK-SNARK 或 ZK-STARK),而這個有效性證明便可以保證序列器中不會出現無效或惡意交易。此外,任何人(甚至是智能合約)都可以輕易地驗證這些證明。但對於 ZK-Rollup 的序列器來說,數據可用性依然是舉足輕重,這是因爲我們作爲 Rollup 的用戶,如果想快速投資於 Shitcoin 的話,就需要知道我們在 Rollup 上有多少賬戶餘額。但如果交易數據不可用的話,我們就無法知道我們的賬戶餘額,也就無法再與 Rollup 進行互動。
上文讓我們明白了,人們一直以來推崇 Rollup 的原因。鑑於全節點不一定要能跟上序列器的速度,那我們爲什麼不直接把它變成一臺功能強大的計算機?這一改變將讓序列器每秒執行大量的交易,從而降低了 Gas 費,並令所有人都感到滿意。但是,序列器還是需要提供交易數據,也就是說,即使序列器是一臺真正的超級計算機,它實際能計算的每秒交易數量仍將受到它所使用的底層數據可用性解決方案或數據可用性層的數據吞吐量的限制。
簡而言之,如果 Rollup 所使用的數據可用性解決方案或數據可用性層無法儲存 Rollup 序列器想要轉儲的數據量,那麼序列器(以及 Rollup)即使想處理更多的交易,也都無能爲力了。與此同時,這也會讓 Ethereum 上的 Gas 費用升高。
這正是數據可用性之所以極其重要的原因——如果數據可用性得到了保證,我們就可以規範 Rollup 序列器的行爲,而如果 Rollup 準備最大化其交易吞吐量,數據可用性解決方案或數據可用性層數據空間吞吐量的最大化也將變得至關重要。
但你可能已經意識到,我們尚未完全解決序列器能否正常運作的問題。如果 Rollup 主鏈全節點的計算速度不需要跟上序列器的話,序列器就可以扣留很大一部分的交易數據。問題在於,主鏈節點如何才能強制序列器將數據轉儲到數據可用性層之上?而如果節點不能做到這一點的話,我們就根本不會在可擴展性方面取得任何進展,因爲這樣的話我們就不得不去信任序列器或自己出資購買超級計算機了。
上述問題也被稱爲「數據可用性問題」。
「數據可用性問題」的解決方案
數據可用性問題最直接的解決方案是,強制全節點下載由序列器轉儲的所有數據到數據可用性層或解決方案上。但與此同時,我們也清楚這對我們並無幫助,因爲這需要全節點跟上序列器的交易計算速度,並提高運行全節點的硬件要求,最終會阻礙去中心化的發展。
因此很明顯,我們需要一個更好的解決方案來解決這個問題,而且幸運的是,我們碰巧就有一個。
數據可用性證明
每當序列器轉儲一個新的交易數據塊時,節點可以通過數據可用性證明來進行數據「採樣」,以確保這些數據確實是由序列器所提供的。
雖然數據可用性證明的工作原理涉及大量數學計算以及技術術語,但我還是會盡力向大家解釋清楚(參見John Adler)。
我們首先可以要求由序列器轉儲的交易數據塊進行擦除編碼處理,而這也就意味着原始數據的規模將變大一倍,之後新的以及額外的數據則被編碼爲冗餘數據(這就是我們所說的擦除代碼)。擦除數據編碼之後,我們便可以用任意 50% 擦除編碼的數據來恢復原始數據的全部內容。
擦除代碼技術和遊戲《堡壘之夜》中能讓你在那次嚇到貓以後繼續欺負你那個討人厭的表弟和他的朋友,使用的是一個技術。
不過請注意,交易數據塊進行了擦除編碼處理以後,序列器要想做出不當行爲必須扣留該區塊 50% 以上的數據。但如果該區塊沒有被擦除編碼的話,那麼序列器只留存 1% 的數據就可以做出不當行爲了。所以說,通過對數據進行擦除編碼處理,全節點就更能確保序列器能夠實現數據可用性了。
儘管如此,我們也想盡可能確保序列器能提供全部數據。在理想情況下,我們希望序列器能達到的可靠性與我們直接下載整個交易數據塊一樣高,而事實上,這是完全可以實現的:全節點可以隨機從該區塊下載一些數據。如果序列器行爲不端,全節點將有小於 50% 的機率被欺騙,即在序列器試圖扣留數據時隨機下載一部分數據。這是因爲,如果序列器意圖行爲不當、扣留數據,那麼它們必須扣留大於 50% 擦除編碼的數據才行。
與此同時,這也就意味着,如果全節點可以兩次進行該操作的話,就可以大幅降低被欺騙的可能性。全節點通過隨機選擇另一塊數據進行第二次下載,就可以把被欺騙的概率降到 25% 以下。事實上,全節點第七次隨機下載數據時,其未能檢測到序列器扣留數據的機率將小於 1%。
這一過程被稱爲使用數據可用性證明的抽樣,或者也可以直接稱爲數據可用性抽樣。它的效率非常高,因爲該抽樣可以讓節點在只下載序列器於主鏈上發佈的一小部分數據的情況下,就可以保證其效果與下載並檢查整個區塊相一致(節點可以使用主鏈上的 merkle 根來找到要採樣的內容和區域)。爲了讓大家有一個更直觀的感受,你可以想象一下,如果你在小區散步 10 分鐘就能消耗和跑步 10 公里一同樣多的熱量,是不是就能感受到數據可用性抽樣的強大了。
如果主鏈全節點可以進行數據可用性採樣的話,我們就能確保 Rollup 序列器不出現錯誤行爲。我們現在都應該感到高興,因爲我們已經可以確信 Rollup 的確能夠擴展我們最喜愛的區塊鏈。但在你想退出這個網頁之前,是否還記得我們仍需要找到一種方法來擴展數據可用性本身?如果我們想讓世界上所有人都加入到區塊鏈當中,從而掙到更多的錢,那我們就需要建設 Rollup;如果我們想用 Rollup 來擴展區塊鏈,那我們不僅需要限制序列器做出不當行爲,而且我們還必須擴展數據空間的吞吐量,從而降低序列器轉儲交易數據的成本。
數據可用性證明也是擴展數據空間吞吐量的關鍵
近期,一個有着專注於擴展數據空間吞吐量路線圖的 layer 1 便是 Ethereum 了。它希望通過數據分片來擴展數據空間的吞吐量,這也就意味着不是每個驗證器都會像目前的節點那樣繼續下載相同的交易數據(驗證器也能運行節點)。相反,Ethereum 將從本質上把它的驗證器網絡分爲不同的分區,該操作也被稱爲「分片」。假設你有 1000 個驗證器,並且它們都用來存儲相同的數據,那麼如果你把它們分成 4 組,每組 250 個驗證器,你一瞬間就將 Rollup 轉儲數據的空間增加了 4 倍。這看起來很簡單,對嗎?
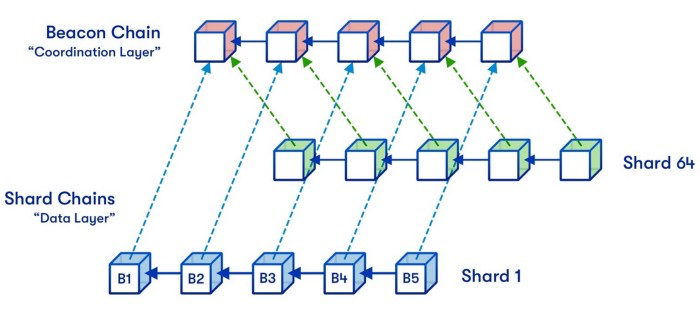
Ethereum 在其「近期」數據分片路線圖中正嘗試設置 64 個數據分片
然而,問題是,一個分片內的驗證器只能下載被轉儲到他們分片上的交易數據。而且這意味着一個分片內的驗證器不能保證序列器轉儲的全部數據都可用——它們只能保證轉儲到他們分片的數據是可用的,但不能保證其他分片的數據可用。
因爲,我們可能會遇到這樣的情況:一個分片中的驗證器不能確定序列器是否發生了錯誤行爲,因爲他們不知道其他分片中發生了什麼,而這一問題也可以用數據可用性抽樣來解決。如果你是一個分片中的驗證者,那麼你就可以使用其他每一個分片中的數據可用性證明進行數據抽樣。這樣一來,你就相當於是每個分片的驗證者了,數據可用性也就因此得到了保證,而 Ethereum 也可以安全地進行數據分片了。
其他一些區塊鏈,也就是 Celestia 和 Polygon Avail 也想大規模擴展其數據空間吞吐量。與其他大多數區塊鏈不同的是,Celestia 和 Polygon Avail 都只做兩件事:下單區塊與交易,以及成爲數據可用性層。這意味着,爲了保證 Celestia 與 Polygon Avail 驗證者的可靠,我們非常需要一個去中心化的節點網絡,以確保其驗證者有在正確存儲和訂購交易數據。但是,由於這些數據不需要做任何處理(即執行或計算),你就並不需要使用全節點來保證他們的可靠性了。相反,能夠完成數據可用性採樣的輕節點將也可以完成全節點的工作,而如果有很多輕節點都可以用數據可用性證明進行採樣的話,就足以讓驗證者在保證數據可用性方面負起責任了。也就是說,只要有足夠的節點使用數據可用性證明進行數據可用性採樣(鑑於數據可用性證明甚至可以用手機來計算,想做到這一點相當容易),你就可以擴大區塊,提升驗證者的硬件要求,從而提高數據空間的吞吐量。
現在讓我們來回顧一下:數據可用性問題也許是區塊鏈三難困境的關鍵,對我們所有在擴展方面的努力都造成了影響。幸運的是,我們能夠利用數據可用性證明這一核心技術來解決數據可用性問題。這讓我們得以大規模擴展數據空間的吞吐量,降低了 Rollup 轉儲大量交易數據的成本,以便其處理足夠多的交易,從而讓全世界的人都能參與進來。此外,數據可用性證明也讓我們可以在無需信任 Rollup 序列器的情況下,就可以保證它的可靠性。希望這篇文章能讓你理解爲什麼要想充分發揮 Rollup 的全部潛力,數據可用性是如此的重要了。
原文鏈接
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章