融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


Anthropic股東最新報告,曝光企業市場最吸金中國模型
原文標題:《Anthropic股東最新報告,曝光企業市場最吸金中國模型》
原文作者:動察Beating
11 月 3 日,矽谷老牌風投 Menlo Ventures 發布了今年的《企業 AI 現狀報告》。
為了摸清企業今年到底花了多少錢,Menlo 委託 Morning Consult 在 9 月問了近 400 家美國企業的 AI 決策者,這些人經手的 AI 開支超過 40 億美元。按 Menlo 的測算,截至今年 9 月,美國企業花在 AI 部署上的錢已經到了 1768 億美元,是一年前 330 億美元的 5.4 倍。
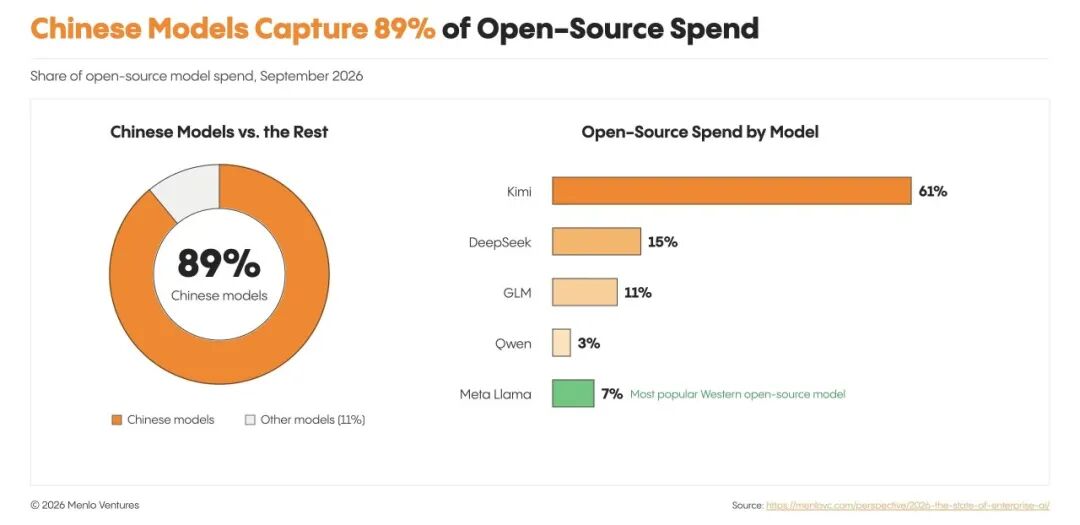
2026年9月,中國模型占美國企業開源模型支出的89%
其中Kimi以61%的份額居首
圖源:Menlo Ventures
在這份寫給矽谷看的報告裡,有一組數字。美國企業花在開源模型上的生產開支,中國模型占了近九成。其中 Kimi 一家 61%,後面是 DeepSeek 15%、GLM 11%、Qwen 3%。西方開源模型裡排第一的 Meta Llama,只有 7%。
寫報告的 Menlo Ventures,是 Anthropic 的重要股東,2024 年領投了它 7.5 億美元的 D 輪。
除此之外,把 Kimi 託管在伺服器上賣給美國企業、今年年化收入剛剛突破 10 億美元的头号推理雲 Fireworks AI,是 Menlo 投的;每週處理 160 萬億 token 的模型路由平台 OpenRouter,是 Menlo 投的;報告專門點名、在 Kimi K2.5 上訓出 Composer 2 的 Cursor,也是 Menlo 投的。
如果只看報告數據,你會覺得閉源巨頭和開源陣營早該拼個你死我活,太平洋兩岸的模型也該涇渭分明,但大人看利弊,小孩才分陣營。
除了這些數據、利益關係,動察 Beating 更想弄明白的是,為什麼偏偏是 Kimi,成了美國企業在閉源旗艦之外最捨得掏錢的那個選項?
返工的價錢
要看懂 Kimi 的這個「61%」,得先了解今年美國企業在 AI 上花錢的怪癖,越便宜的模型,越沒人用了。
過去兩年,行業裡最流行的判斷是推理成本每年降九成,企業遲早會把工作流切到便宜的小模型上。各家實驗室也確實把小模型越賣越便宜。
結果恰恰相反。
從 2025 年三季度到 2026 年三季度,Haiku、Luna 這類小型閉源模型在企業市場的 token 份額從 29% 掉到 13%,跌去一半還多。單價最貴的前沿旗艦,token 份額從 18% 漲到 42%,支出份額從 35% 漲到 63%。
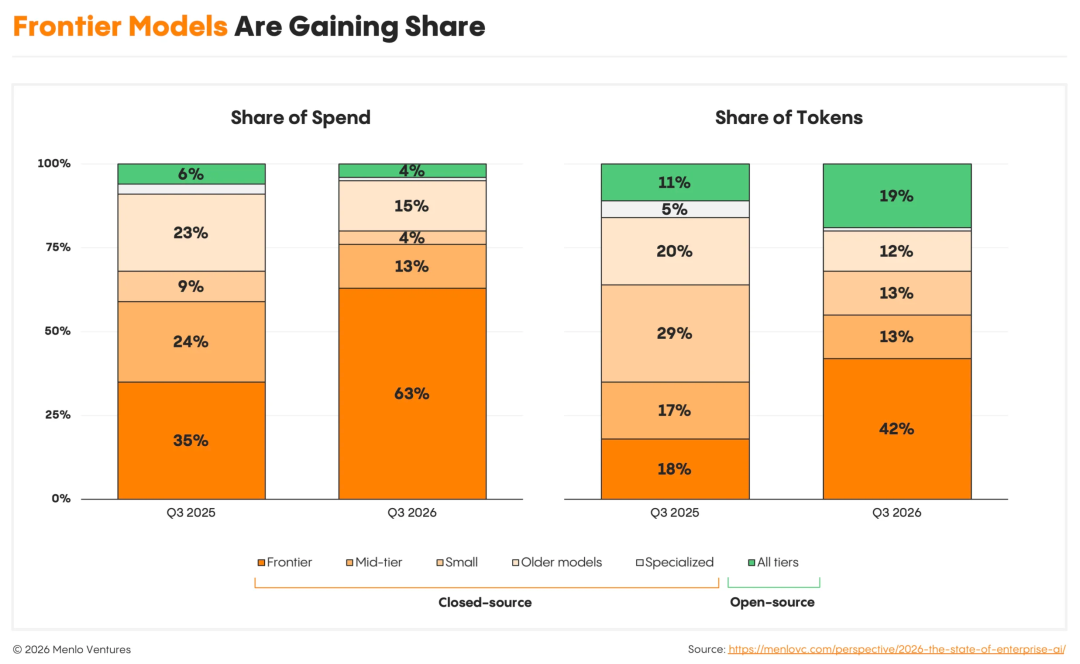
前沿模型在企業 AI 支出與 token 用量中的份額同步上升
圖源:Menlo Ventures
一年前,美國企業最常用的主力還是輸入 3 美元、輸出 15 美元(每百萬 token,下同)的 Claude Sonnet 4.5,和 1.25 美元、10 美元的 GPT-5。到了今年秋天,大家卻排著隊換成了更貴的旗艦模型。
精明的美國公司,為什麼突然不圖便宜了?
原因很簡單,用模型幹活的,從人變成了 Agent。
今年 2 月,OpenRouter 上由 Agent 發起的流量正式超過了人類;到 9 月底,平台上 80% 的 token 都是 Agent 在後台自己跑出來的,半年多漲了 37 倍。在 773 億美元的企業 AI 應用支出裡,76% 集中在編程和企業 Agent 上。
Agent 幹活和人類使用 AI 不是一個邏輯。
一個編程 Agent 接下任務,往往要在代碼庫、終端和沙盒之間連跑四五十個回合:讀文件、調工具、跑測試、看報錯、再改代碼。
長鏈條任務中,錯誤的代價是按乘法累積的。單步準確率 99% 的模型連跑 50 步,順利交差的機率大約六成;換成單步 95% 的模型,50 步跑完不翻車的機率不到 8%。
於是企業很快就明白了,現在買模型看的不應該只是價目表上的掛牌單價了,更要看把事情一次辦妥的總花銷。
想通這一點,開源模型今年的處境也就好理解了。
過去一年,開源模型的 token 份額從 11% 漲到 19%,調用量是一年前的 22.5 倍;拿到的支出份額卻從 6% 掉到 4%。原因是大多數開源模型捲進了價格戰,平均單價跌到原來的三分之一不到,只剩每百萬 token 0.13 美元,不到閉源模型綜合均價的五分之一。
開源模型幹了近五分之一的活,只從桌上分走了二十五分之一的錢。
Kimi 的 61%,恰恰是因為它沒跳進 0.13 美元的陷阱裡。
標準件
今年 7 月 16 日,月之暗面發布 2.8 萬億參數的 Kimi K3,官方 API 定價是輸入 3 美元、輸出 15 美元,和一年前的閉源旗艦 Sonnet 4.5 同價,也是上一代 K2.6 的三倍多。10 月 23 日推出的 K3.1 Pro 降到了 2 美元和 10 美元,仍然在旗艦檔位。
在一個均價 0.13 美元的開源市場裡按旗艦標價,底氣首先來自模型本身在長上下文、原生多模態和編程上的成績。
但光有跑分不夠。
開源模型的權重是公開的,在推理雲的下拉菜單裡換一個模型,只需要改一行配置。美國企業的採購憑什麼為它多付錢?
這裡藏著開源模型走出實驗室後最令人頭疼的一個工程問題。
為了數據合規和延遲,大多數美國企業不會把代碼和文檔直接發往海外伺服器,而是去買 Fireworks、Together 或亞馬遜 Bedrock 這類本土雲的託管服務。但在過去一年裡,矽谷的工程團隊頻繁發現,某款開源模型在官方演示裡聰明絕頂,可一旦接進自家的生產環境、走第三方推理雲的接口調用,它在幾十輪連續工具調用後就會莫名其妙地變笨。
原因就在於,推理雲是一門極講究顯卡週轉率的生意。一張卡同一秒鐘能塞進多少個請求,直接決定了雲廠商當季的毛利。為了省顯存、搶吞吐速度,不同平台往往會在後台對萬億參數的 MoE 模型做不同的量化壓縮,或者簡化工具調用的解析模板。
平時聊天,這點精度縮水看不出來;放進幾十步環環相扣的 Agent 循環,偏差就足夠讓模型選錯專家、寫壞格式,把整條工作流跑崩。
客戶衝著模型的招牌買單,然後任務翻車,黑鍋最後還得原廠來背。
Kimi 很聰明,它沒有發聲明去跟哪家雲廠商掰扯,而是直接開源並持續運營一套供應商精度核驗工具。
早在 K2 時期,它就開源了 K2 Vendor Verifier,用同一套測試去比對各家推理雲和官方 API 在工具調用上的表現。今年 4 月發布 K2.6 時,這套工具升級為 KVV(Kimi Vendor Verifier),測試項包括長上下文下的工具調用回歸樣本、JSON schema 校驗、對畸形調用的拒絕、百萬 token 級的長記憶測試,以及 113 個編程 Agent 任務。各家推理雲跑出來的成績,以表格形式掛在 GitHub 上。
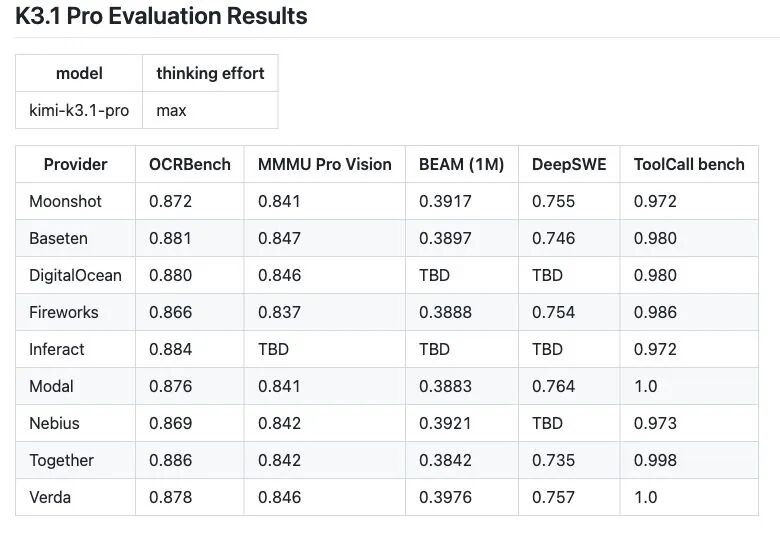
Kimi Vendor Verifier 公開對照不同供應商的
K3.1 Pro 部署表現
圖源:Moonshot AI / GitHub
哪家雲廠商為了省機器偷偷降了精度,開發者在看板上一眼就能看出來。
為了把 KVV 的分數對齊到 Kimi 官方 API 的水平,矽谷的推理雲廠商不得不反過來找 Kimi 的工程師一起捉蟲。
Fireworks AI 的工程團隊後來專門發文復盤,講他們如何聯合 Kimi 團隊修補底層解碼護欄、清理多輪對話裡的冗餘字段,最終把託管接口的工具調用表現打磨到了原廠水平。
大多數團隊做開源,是把權重往網上一放,剩下的看造化。月之暗面卻把嚴苛的品控手腕搬到了開源世界裡,我不收你的門票,但我得管著你怎麼把菜端上桌。
這一下打在了企業採購最敏感的神經上。對矽谷的技術負責人來說,KVV 把散落在各家機房裡的非標品,重新校準成了原廠認證的標準件。
四分之三
如果只有託管質量,Kimi 充其量是個好用的外援。報告裡點到的另一個名字,揭開了它在海外的第二層價值,它就是 Cursor。
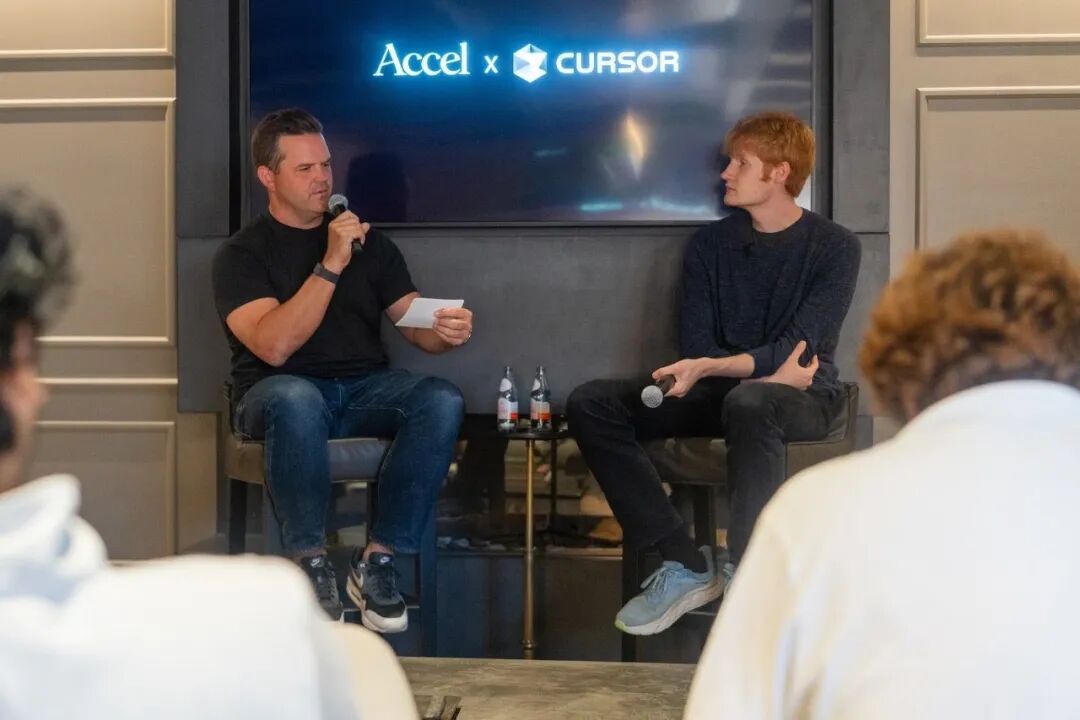
Cursor 與投資方 Accel 的現場交流活動
圖源:Accel
Menlo 寫到,今年做後訓練的 AI 開發者比例從 6% 漲到了 10%。最典型的案例,就是 Cursor 在 Kimi K2.5 上訓出了 Composer 2,由 Fireworks 提供強化學習階段的推理。
Menlo 的數據把獨立應用公司的處境照得一清二楚,今年 1768 億美元的企業 AI 支出裡,Anthropic、OpenAI 和 Google 三家實驗室拿走 1227 億美元,佔 69%,一年前是 50%。其中,實驗室自家的應用就拿走了 400 億美元。
單看 340 億美元的編程賽道,Claude Code 和 Codex 兩款產品吃下 240 億美元,佔了 70%。
應用公司越成功,越能幫上游證明這個市場足夠大,而市場一旦被證明足夠大,握著模型和算力的上游就越有理由親自下場。繼續只當二道販子,遲早要被上游壓死。
今年 1 月初,Cursor 內部開了一場被稱為「War Time」,創始人 Michael Truell 要求全員加速自研模型。
可應用公司想往上走談何容易,Cursor 手裡有幾百萬程序員每天寫代碼、改文件、跑終端的真實交互軌跡,這是做強化學習最好的燃料,但它手裡只有幾萬張 GPU,沒有百萬張卡,也沒時間從頭花大半年去訓一個萬億參數的預訓練底座。
除此之外,Cursor 開內部會的幾天後,Anthropic 就收緊了規則,不再允許第三方編程工具用個人訂閱帳號登入調用。
唯一的活路,是去開源世界裡借一副好身板,把好鋼全部用在後半程的強化學習上。
3 月 19 日,Cursor 發布 Composer 2,定價輸入 0.5 美元、輸出 2.5 美元,正好是當時 Claude Opus 4.6 的十分之一。Cursor 的 Lee Robinson 後來説,最終模型消耗的算力裡,只有約四分之一來自基座,剩下的都花在 Cursor 自己的訓練上。
這改寫了應用公司挑開源模型的標準。
以前大家挑開源模型,像挑一件買回家直接穿的成衣,誰在公開榜單上多考兩分就選誰。但在 Cursor 隨後公開的 46 頁技術報告附錄裡,研究團隊寫道,他們在評估候選基座時,團隊有意不看編程 Agent 類的跑分,理由是這類榜單對最終效果的預測力更弱,因為 Agent 和長程任務能力會在強化學習階段被大幅改變。
不少模型為了發榜當天好看,在出廠前就已經塞滿了針對特定題庫的精調,權重空間被擠得像一塊吸飽了水的海綿;外人看着分數高,可是買回來想往裡再灌三倍的強化學習算力,模型很快就會出現能力坍塌。
Cursor 直接把候選模型拉到自家工地上試工。
他們只測三件事,底層的編碼知識儲備、一個文件被連續修改幾十次之後的狀態追蹤能力,以及模型在 Cursor 私有大型代碼庫上的 perplexity。
測試之後 Kimi K2.5 留了下來。報告給的理由是綜合表現強,以及在 Cursor 自己的基礎設施上跑得夠高效。經過持續預訓練和強化學習,Composer 2 在 Cursor 自家的評測集 CursorBench 上從基座的 36.0 漲到 61.3,超過了 Claude Opus 4.6 的 58.2。
5 月,Cursor 又在同一個 K2.5 基座上推出了 Composer 2.5。
這段從春到夏的突圍,給矽谷留下了一個樣本,對最頂尖的應用公司來説,開放權重模型不再是省錢的平替,而是少數能拿過來、在上面繼續砸錢訓練自有資產的起點。
茶水錢
Cursor 把基於 K2.5 訓出的 Composer 2 推給自己的用戶,美國企業在生產環境裡調用 Kimi,接住這些流量的,主要是 Fireworks、Together 這樣的美國推理雲。
把 Kimi、Fireworks 和 Cursor 擺在一起,能看到一種很有分寸感的分工。
換一家急於證明商業化能力的公司,看到自己的模型在矽谷受歡迎,第一反應往往是去舊金山租辦公室,高薪挖一批企業銷售,直接去敲美國大客戶的門,把中間的差價全揣進自己兜裡。
月之暗面沒有這麼幹。
2025 年 7 月,Menlo 在年中報告裡也寫過,美國企業不願意直接調用中國公司的 API,是開源模型份額停滯的原因之一。這道合規與信任的門檻,靠銷售飛去加州磨破嘴皮子是跨不過去的。
與其硬撞那堵牆,不如把前面的肉讓給美國本土的合作夥伴。Kimi 的工程團隊在模型上線前後配合 Fireworks 等平台把推理引擎調順,美國企業把合同簽給美國雲廠商,數據留在美國機房。
微軟位於美國華盛頓州昆西的數據中心服務器機櫃
圖源:John Brecher / Microsoft
正因為月之暗面沒有伸手去做生意,Fireworks 才願意賣力推 Kimi,Cursor 的工程師也才敢把當家產品建在 K2.5 的權重上。大家都有錢賺的時候,這事兒才能成氣候。
至於月之暗面自己的收入問題,它把規矩寫在了 K3.1 Pro 的許可證裡。
企業內部部署、做研究,或者拿去微調做自己的產品,都不用打招呼。要坐下來談的只有兩種情況,一是拿它做模型託管,對外提供推理或微調服務,連續 12 個月收入超過 2000 萬美元的,得先和月之暗面另簽協議;二是終端產品月活過億或月收入超過 2000 萬美元,要在界面上明顯地標出模型名。通過月之暗面官方產品或認證推理夥伴使用的,不受這兩條約束。
8 月,路透社報導,月之暗面正在和微軟、亞馬遜、谷歌商談 K3 相關服務的收入分成,要價最高 30%。
不到一個月,美國時間 9 月 18 日,亞馬遜把 K3 放上了 Bedrock。全球標準檔的價格和月之暗面官方一樣,3 美元、15 美元,分成比例沒有公開。
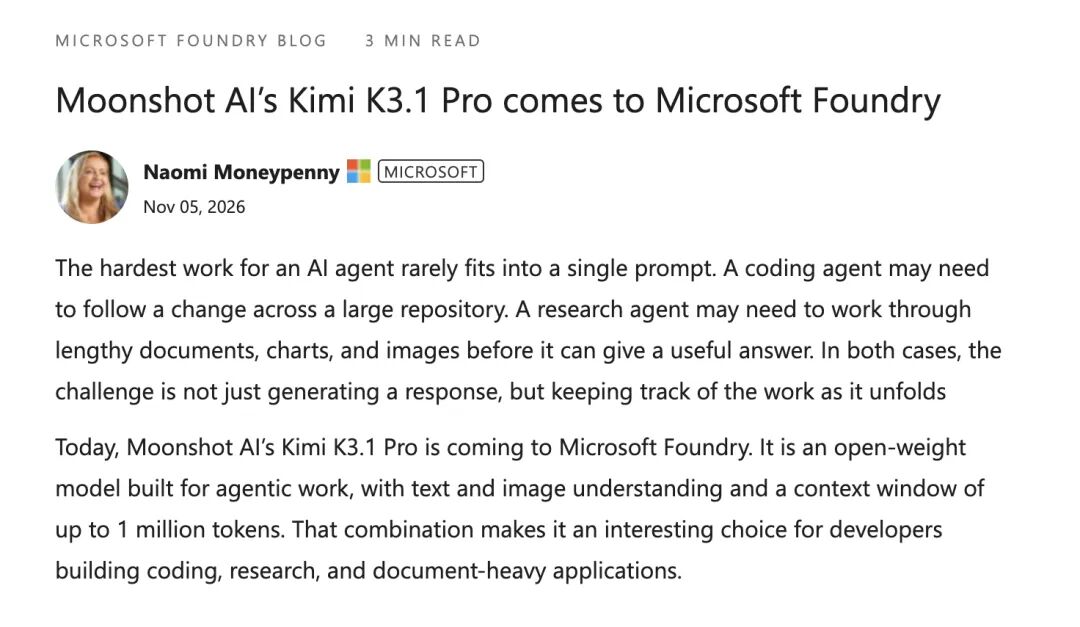
微軟的路徑繞一些。K3 在 7 月底就進了 Microsoft Foundry,但當時是 Fireworks 在背後跑推理,Foundry 只負責接入。美國時間 11 月 5 日,微軟在自家部落格上宣布 K3.1 Pro 正式上架 Foundry。
用老輩生意人的話講,這叫小路隨便走,大路交茶水錢。一百家裡有九十九家還在試錯的初創公司,Kimi 不收一分錢;等誰真跑成了一年幾千萬美元的大買賣,再按規矩坐下來談。
清楚哪部分錢眼下不該自己賺,有時候比知道怎麼賺錢更考驗定力。
黑貓白貓
把視線從這 61% 的切面拉遠一點,今年秋天的這組數據之所以耐人尋味,是因為它呈現了大模型產業在磨合三年之後,自然生長出的一種新關係。
兩年前,矽谷關於行業終局的爭論非黑即白,一派認為閉源旗艦會通吃一切,應用公司遲早淪為薄薄一層介面;另一派相信開源會把智能變成免費的自來水,讓所有模型公司都賺不到錢。
到了 2026 年,兩幅圖景都沒有成真。
Anthropic 和 OpenAI 依然拿走了美國企業大模型 API 支出的 86%。華爾街投行審一份跨國併購合同,藥企做一次零容錯的文獻排查,依然會毫不猶豫地為最貴的閉源旗艦付費。流向開源的預算,也沒有變成廉價算力的比拼場,反而向 Kimi 這樣接近前沿的模型聚攏。
開源與閉源之間,不再是一道非此即彼的戰壕。在複雜任務的催化下,兩者之間長出了一片寬闊的交界地帶。
在這片交界地帶裡,許多重度使用 Kimi 的矽谷公司,同時也是 Anthropic 和 OpenAI 的大客戶。產品早期,它們用最強的閉源模型跑通形態、驗證需求;等某條長鏈條工作流被驗證成立、調用量開始指數級放大,或者像 Cursor 那樣攢夠了獨有的交互數據、要把行業經驗訓進權重裡時,它們就會轉身去找那個離前沿最近、又允許自己深度改造的開放基座。
過去,模型公司和應用公司之間,一個賣 API,一個買 API 模型公司一旦自己做應用,雙方立刻變成零和博弈的對手。
而現在,應用公司在開放模型上投入四分之三的算力繼續訓練,成了「半個模型公司」;模型開發者的影響力,也不再只看賣出了多少 token,還要看有多少別人的核心產品,是從它的權重裡長出來的。
Kimi K3.1 Pro 官方發布主視覺
圖源:月之暗面
Menlo 報告發布的第二天,11 月 4 日,月之暗面按時在 Hugging Face 放出了 Kimi K3.1 Pro 的完整權重。按月之暗面自己公布的成績,它在衡量編程 Agent 實戰能力的 Terminal-Bench 4.0 上拿到 65.7%,高於 GPT-6 Astra 的 58.2%,離 Claude Opus 5.5 的 66.4% 只差 0.7 個百分點。
對把產品管線押在開源基座上的美國團隊來說,這 0.7 個點,以及從 K2、K2.5、K2.6 到 K3、K3.1 Pro 每隔幾個月就往前挪一步的節奏,比任何開源口號都讓人安心。後訓練出來的專用模型,每隔幾個月就得跟著前沿重訓一次。選一個基座,等於同時選了這家公司未來一年的迭代速度。
在舊金山,大概沒有哪家創業公司會在路演 PPT 第一頁寫「我們的底座來自中國」,大模型的原產地依然是個敏感詞。
可只要回到每天都在運轉的伺服器機房裡,回到工程師盯著螢幕等 50 輪 Agent 循環跑通的深夜,所有的口號都會讓位給實用主義。誰能抓到耗子,誰就是好貓。
當大洋彼岸的應用公司真正需要一個經得起折騰的夥伴時,抬起頭,就能看見它早就站在那裡。
原文連結
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章