

 融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


中國大模型的斬殺線,被斬殺了
原文標題:《中國大模型的斬殺線,被斬殺了》
原文作者:Sleepy
10 月 8 日,Anthropic 發布 Haiku 5.5。對於不超過 10 萬 token 的短請求,每百萬 token 輸入收 0.1 美元、輸出收 0.5 美元,只有上一代 Haiku 4.5 的十分之一。
當天上午,Dragonfly 管理合夥人 Haseeb Qureshi 在 X 上貼出兩張 Artificial Analysis 的散點圖,配了一句:
「If you want the cheapest LLMs, you should now buy American.」
(想要最便宜的大模型,現在該買美國貨了。)
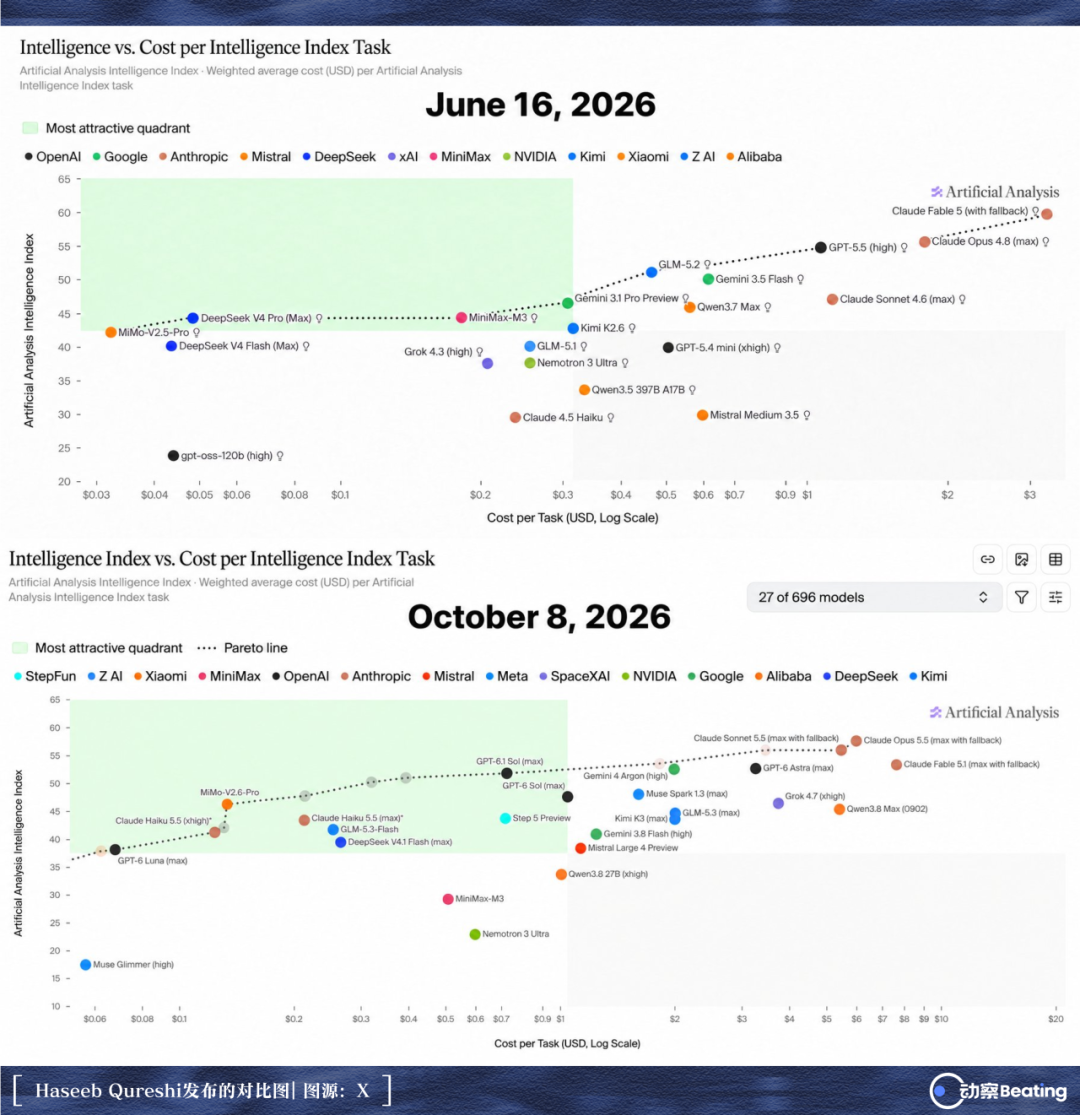
散點圖的橫軸是完成一次基準任務要花的錢,縱軸是得分。連接所有最優解的那條虛線,在微觀經濟學裡叫帕累托前沿,線上每一個點都意味著,在同等成本下你找不到更聰明的模型。
6 月那張圖上,虛線最便宜的那一端,是小米 MiMo、DeepSeek V4 Pro、MiniMax-M3 和智譜 GLM-5.2,幾乎全是中國大模型的名字。
到了 10 月 8 日,整條線被 Anthropic 和 OpenAI 接管。中國模型只剩下一個 MiMo 還勉強掛在邊緣,智譜 GLM-5.3-Flash 和 DeepSeek V4.1 Flash 則被一掌推到了 Haiku 5.5 的右下方,意味著相比之下它們花得更多,得分更低。
當天港股開盤,大模型概念股應聲下挫。上午 10 點 26 分,MiniMax 跌幅擴大至 10%,智譜跌 5.6%。午盤恒生科技指數跌 1.93%,兩家大模型新貴跑輸大盤近五倍。
過去兩年,中國開源與高性價比模型,給全球大模型市場焊死了一條斬殺線。只要把價格壓進泥地,海外走量檔的閉源模型就難以為繼。矽谷明星公司排著隊把底層管道換成中國開源大模型。
如今,牌桌被掀了。
斬殺線,被斬殺了。
斬殺線的形成
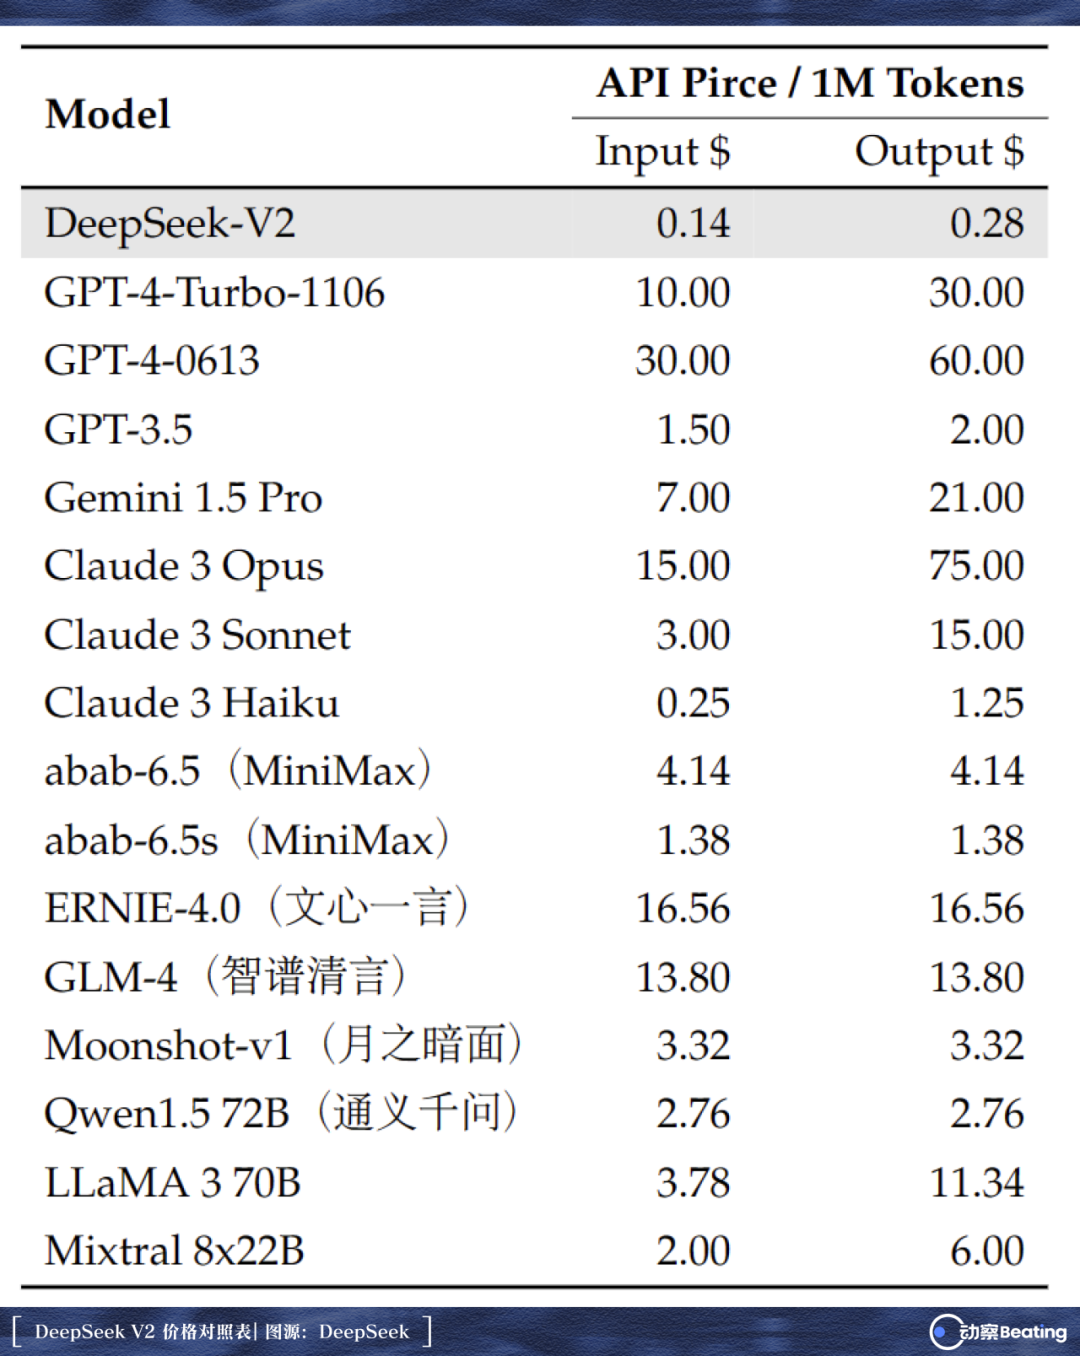
2023 年 3 月 GPT-4 剛上線時,8K 上下文版本的官方報價是每百萬輸入 30 美元、輸出 60 美元。
智能極度稀缺,供給由極少數矽谷寡頭壟斷,價格完全是賣方市場。那是一個相信「智力可以單獨溢價」的蜜月期。
打破這一神話的,是一家由中國量化對沖基金孵化的技術團隊。2024 年 5 月 6 日,DeepSeek 推出 V2。2360 億總參數,每個 token 僅激活 210 億;依靠 MLA 架構與極致的工程剪裁,團隊將 KV cache 砍掉了 93.3%,吞吐量拉升至 5.76 倍。省下來的算力直接折現為商業定價,每百萬輸入 1 元人民幣,輸出 2 元。
國內大廠幾乎是被生拉硬拽拖進價格戰的。
5 月 15 日,字節跳動火山引擎發布豆包,主力模型給出 0.0008 元/千 token 的企業價,宣稱比行業均價便宜 99.3%。5 月 21 日,阿里雲宣布通義千問系列斷崖式降價,Qwen-Long 輸入端折合每百萬 token 僅收 0.5 元;數小時後,百度文心兩款主力模型直接宣布免費。
到了 8 月,DeepSeek 進一步引入硬盤緩存技術,緩存命中的輸入 token 每百萬僅收 0.1 元。
當時的大洋彼岸,巨頭們並未全盤跟進。2024 年 7 月 OpenAI 發布 GPT-4o mini,輸入輸出降至 0.15 美元與 0.6 美元;但四個月後 Anthropic 推出 Claude 3.5 Haiku,標價反而是上一代的四倍。Dario Amodei 當時的邏輯是,模型更聰明了,定價必須體現智力進階。
真正讓矽谷感受到徹骨寒意的,是 2025 年 1 月。
DeepSeek-R1 橫空出世,推理表現直逼 OpenAI o1,而輸出每百萬 token 僅需 2.19 美元,而那時 o1 的報價是 60 美元。
1 月 27 日,輝達單日市值蒸發近 5890 億美元,創下美股歷史紀錄。Marc Andreessen 將其稱為 AI 領域的斯普特尼克時刻,微軟 CEO Satya Nadella 在社交平台上感慨說,傑文斯悖論又靈驗了。
斬殺線自此成形。
開放權重讓這柄利刃更加鋒利。面對閉源模型,客戶只能在幾份壟斷價目表間做算術;而權重一旦開放,開發者既能在自己的集群上私有部署,也可以在任何一家第三方推理雲上跑起同樣的模型。同一個模型有了多家供應商,客戶也多了自行部署的選擇,模型提供方維持高溢價的空間隨之縮小。
一批美國本土公司率先過了河。
2025 年 10 月,Airbnb 首席執行官 Brian Chesky 公開表示,公司的智能客服 Agent 極度依賴阿里千問,整個系統調度了 13 個模型,雖然也接入了 OpenAI 最新的旗艦,但在生產流水線裡極少被調用,因為有更具性價比的替代品。
同月,Cognition 推出 SWE-1.5,宣稱構建在「某個行業領先的開源基座」之上,智譜隨後證實,該底座正是 GLM-4.6。
緊接著,a16z 合夥人 Martin Casado 對《經濟學人》透露,帶著開源模型架構來路演的美國 AI 初創企業中,大約八成用的是中國基座。
今年 3 月,代碼編輯器 Cursor 發布 Composer 2,定價每百萬輸入 0.5 美元、輸出 2.5 美元,團隊最終承認基座調優自月之暗面的 Kimi K2.5。
開發者在用代碼與預算投票。Mozilla 發布的報告顯示,中國開放權重模型在 OpenRouter 上的 token 份額,從 2024 年底的不足 2%,升至 2026 年 4 月的超過 45%。
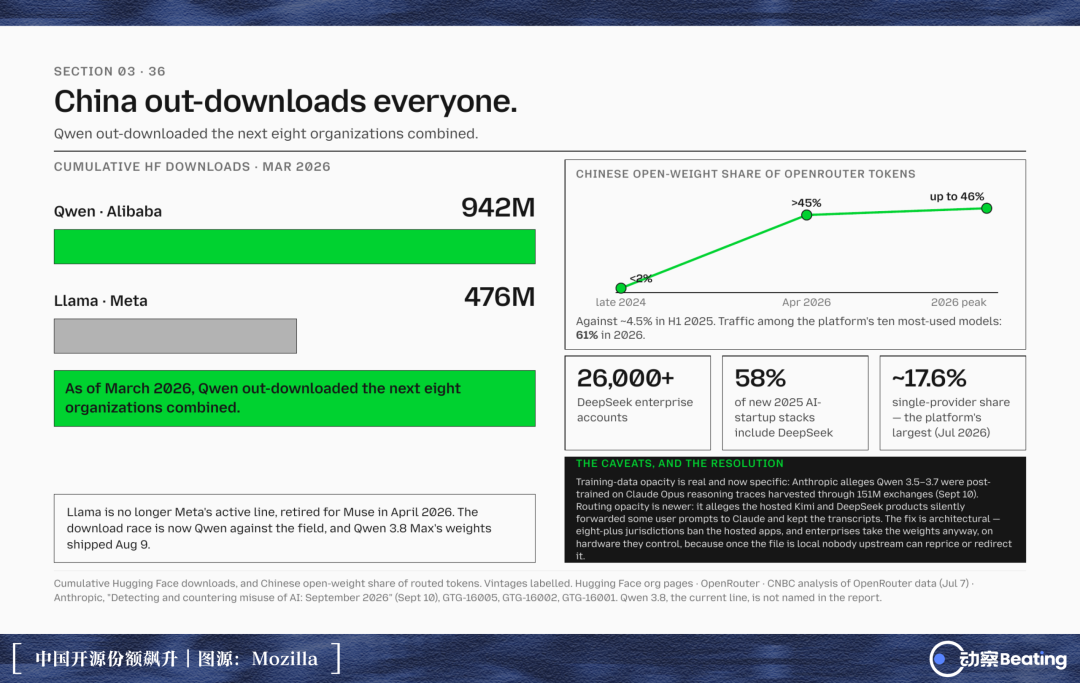
在走量與結構化調用的生態位上,高傲的閉源模型一度毫無還手之力。
代價
斬殺對手,並不必然意味著自己活得體面。
Mozilla 的同一份報告裡,還有一組對照數據。2025 年 5 月至 9 月,開放模型約占 OpenRouter 平台兩成的模型使用量,卻只獲得約 4% 的模型層收入。這是一個平台在特定時期的樣本,不能代表全球市場,但使用份額與收入份額之間的落差已經十分明顯。
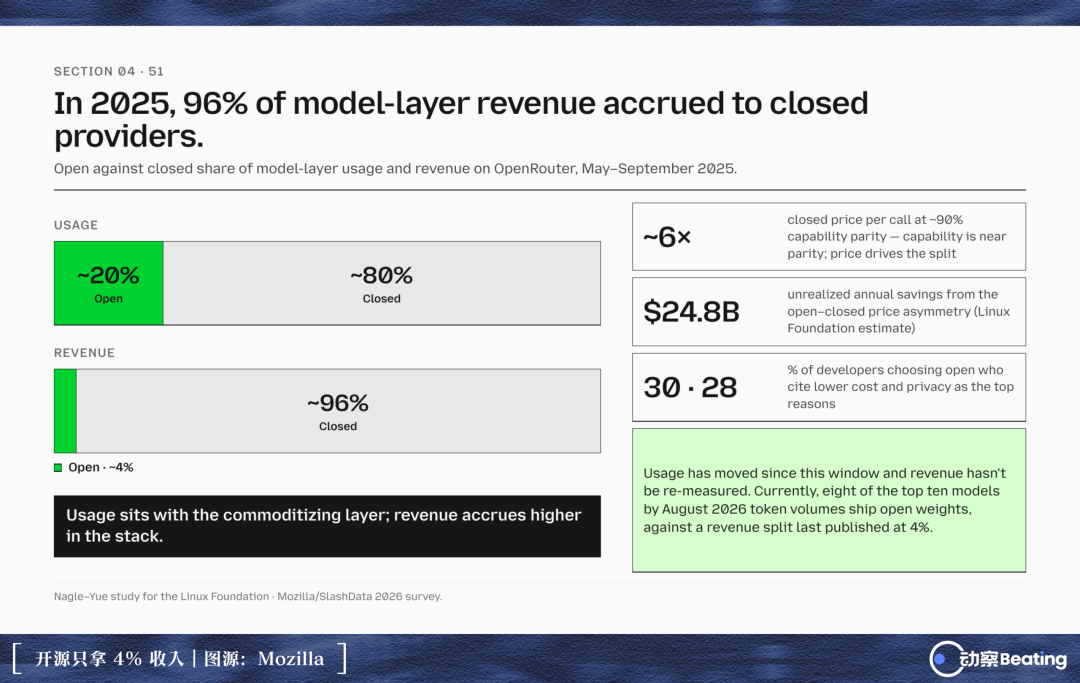
創造價值,從來不等於捕獲價值。
今年 1 月,智譜與 MiniMax 相繼敲鐘。隨後披露的中期業績,讓外界得以看清收入增長背後的成本與虧損。
智譜上半年收入 9.54 億元,其中開放平台及 API 業務收入 8.25 億元,占比達到 86.5%。這項業務的毛利率已經由負轉正,升至 24.6%;但公司整體仍錄得約 20.72 億元淨虧損,同比收窄 12.1%。賣出更多 token 開始產生毛利,但是距離覆蓋公司的全部開支,還有一段距離。
MiniMax 上半年營收約 1.17 億美元,同比增長 283.1%;淨虧損約 3.58 億美元,同比收窄 11%。剔除股份支付、金融負債公允價值變動及上市費用後,經調整淨虧損約 2.93 億美元,同比擴大 111.2%。
上市之後,低價帶來的增長需要接受另一重檢驗。每一次調用究竟能留下多少毛利,這些毛利又能覆蓋多少研發與運營開支。收入增長很快,距離公司整體盈利仍然很遠。
今年春末,Agent 浪潮將算力消耗推向了臨界點。
開源項目 OpenClaw 席捲全球開發者社區,至 3 月初在 OpenRouter 上的累計 token 消耗突破 8.52 萬億,雄踞榜首。3 月中旬的一週內,中國模型單週跑出了 7.36 萬億 token,環比激增 56.9%。
2 月 12 日上線的 GLM-5 一度登頂調用榜,洶湧的需求在瞬間擊穿了基礎設施配額。海外與國內開發者開始密集抱怨 GLM Coding Plan 出現秒級延遲和高頻限流,這是中國頭部 AI 團隊首次公開告急求算力。
2 月 23 日,智譜單日股價暴跌近 23%,一日之內蒸發逾 700 億港元市值。
接踵而至的,是一輪防禦性漲價。
智譜在 GLM-5 推出時上調資費,3 月的 GLM-5-Turbo 價格再度上浮 20%,整體較上一代規格平均貴了 83%。
DeepSeek 在 4 月 24 日發布的 V4-Pro 擁有 1.6 萬億總參數,上線即給予 75% 峰值折扣。這把火先燒向了同行,MiniMax 兩個交易日連續下挫約 9% 和 10%。
但到了 8 月中旬,DeepSeek 亦轉入分時計費策略,V4-Pro 高峰期輸出每百萬 token 攀升至 3.96 美元,緩存命中成本上漲超 12 倍。
7 月,月之暗面發布 Kimi K3,API 標價推升至每百萬輸入 3 美元、輸出 15 美元,比 K2.6 整整貴出三倍多。
不過,令人意外的是,漲價並未引發劇烈的客戶流失。
智譜 CEO 張鵬公開透露,一季度調價 83% 後,API 調用規模反而激增了 400%。至 8 月底,智譜 MaaS 平台的年化收入摸高到 16 億美元,API 業務毛利率奇蹟般轉正至 24.6%。
在算力供不應求的數月窗口期內,中國模型團隊第一次觸摸到了難能可貴的定價權。
然而,那條曾讓海外巨頭寢食難安的斬殺線,也在不知不覺間,被它們自己推高了。
閃電戰
大洋彼岸在夏天完成了戰略調頭。
6 月底,Anthropic 發布 Sonnet 5,標出每百萬輸入 2 美元、輸出 10 美元的首發促銷價,原本明確聲明 9 月將恢復至 3 美元和 15 美元。
而到了 7 月,OpenAI 推出 GPT-5.6 系列,三週後突然發動閃電戰,Luna 價格降低 80%,輸入端跌至 0.2 美元,輸出端降至 1.2 美元。
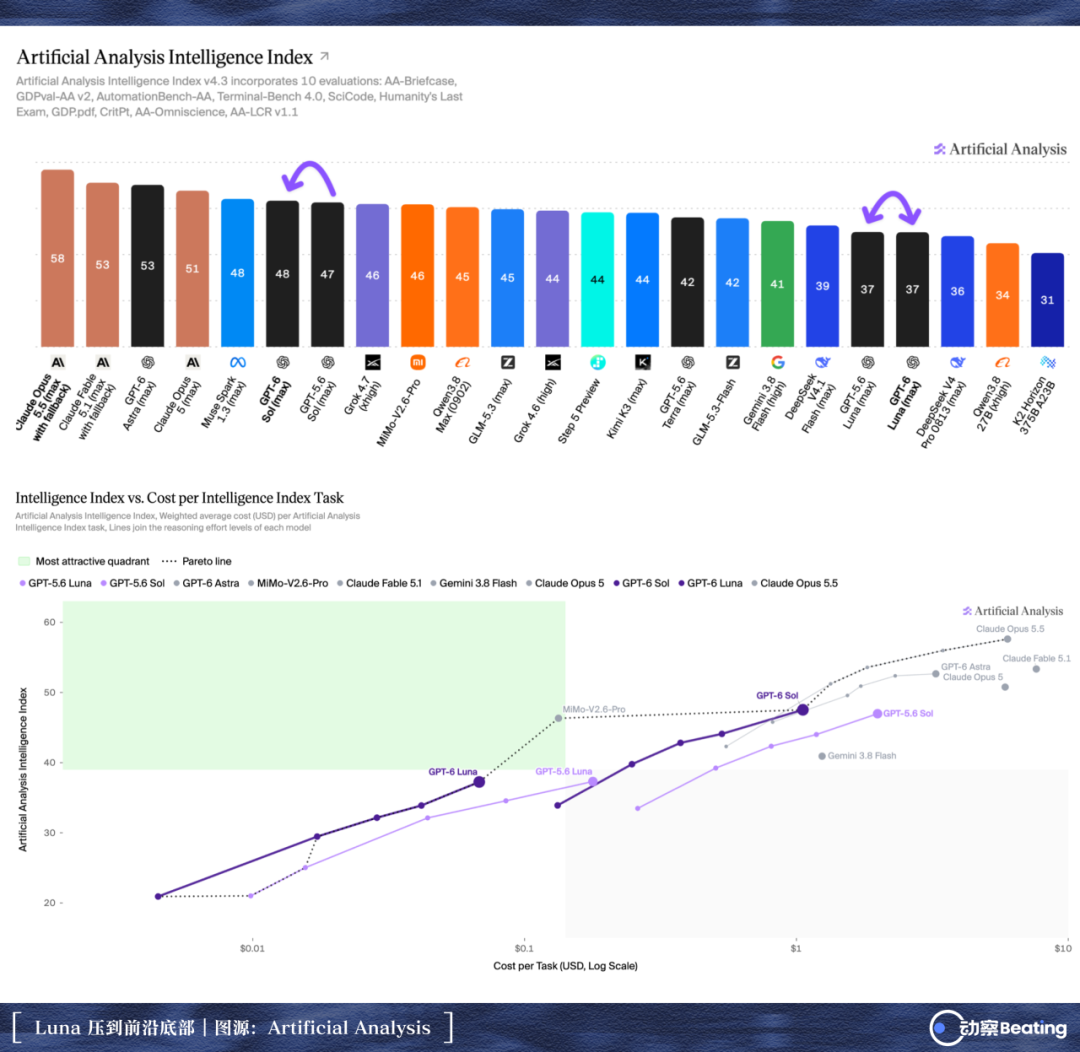
OpenAI 將這次降價歸功於純粹的底層工程重構,重寫的 GPU kernel 將端到端服務成本壓低了約 20%,重新訓練的投機解碼草稿模型令生成吞吐提速 15% 以上。
8 月 10 日,Anthropic 撤回漲價通告,宣布 Sonnet 5 永久鎖定低價。
9 月 22 日,Anthropic 掏出 Opus 5.5,綜合使用成本下調 40%;同日 OpenAI 推出 GPT-6 Sol 與 Luna,Luna 將入門價鎖死在輸入 0.1 美元、輸出 0.5 美元。隨後登場的,便是 Haiku 5.5。
兩年前堅信「智能必須享有單獨溢價」的 Anthropic,親手撕掉了自己的標籤。
現在大模型發布時的話術也變了。不再是純粹羅列 MMLU 的微弱勝出,他們開始反覆強調單位美元產出、延遲與每一步推理消耗的工程效率。
並且,在 Haiku 5.5 亮相同時,Anthropic 宣布向訂閱用戶全面配發 API 額度,Max 級別每月贈送 100 至 200 美元,企業 Team 用戶最高可享 500 美元抵扣。
這招直切腹地。價目表上的折扣只影響單次調用決策,但一旦客戶的代碼工程與 Agent 編排完成適配,撬動遷移的壁壘將高如城牆。
美國巨頭敢於發起這場價格戰,靠的是深不可測的資金池與供應鏈特權。
Anthropic 的年化營運收入,從 2025 年底的約 90 億美元,狂飆至今年 7 月底的超 650 億美元。5 月完成的那筆高達 650 億美元的融資,直接將其估值推上 9650 億美元。
在算力層面,Anthropic 於 4 月宣布擴大與 Google、博通的合作,獲得多吉瓦級的下一代 TPU 算力容量,預計從 2027 年起陸續上線。
與之對照,智譜年內通過配售及可轉債艱難籌集 700 餘億港元,折合美元,不及 Anthropic 單輪彈藥的七分之一。
出得起錢的,依然只有超級巨頭。
二級市場的清算向來不留情面。
智譜於 1 月 8 日登陸港股,發行價 116.2 港元。春季的算力荒未能阻擋多頭的狂熱,6 月 22 日其股價衝至 2980 港元,市值一度觸碰 1.33 萬億港元天花板。
隨後是漫長的下跌。
7 月限售股解禁,兩輪配售將定增價從 1588 港元一路砸至 714 港元。7 月 16 日 Kimi K3 登場次日,智譜全天下挫 28.48%。9 月 22 日 Opus 5.5 與 GPT-6 聯袂出擊,智譜跌幅再度超過 10%。
9 月 25 日,智譜盤中探底至 610.5 港元,總市值縮水至 3000 億港元附近,自歷史高點回撤近八成。
MiniMax 的軌跡同樣慘烈。自 1330 港元峰值下墜,解禁當日重挫 17.98%,7 月中旬收於 216 港元。其上半年近六成收入仰賴海外客戶,而海外,正是美國巨頭降價風暴首當其衝的戰場。
估值口徑也開始收緊。據媒體轉述,傑富瑞在 9 月的研報中,將智譜雲業務對應的 2026 年預測年化收入估值倍數,從 50 倍下調至 30 倍,降幅為 40%。
中國模型曾經憑藉極致性價比從巨頭口中虎口奪食,而如今,這條路在大洋彼岸也走通了。開發者因便宜而來,自然會因更便宜而去。
0.1 美元的幽靈
2006 年 8 月 25 日,Jeff Barr 在墨西哥卡波聖盧卡斯一片燥熱的海灘邊,敲下了介紹 Amazon EC2 測試版的文章。
在技術說明的末尾,他寫下了一個註定載入商業史的數字,開發者租用一台虛擬計算實例,每小時收費 0.1 美元。
其後的故事眾人皆知。AWS 在接下來的十餘年裡主動下調價格逾百次,2014 年僅 S3 存儲費率便腰斬 51%。
雲計算從未靠著將同等算力越賣越貴來成就霸業。規模、底層自研晶片與極致運維壓榨出的每一分邊際利潤,被源源不斷地回饋給終端市場,進而吸引更多開發者。持續降價的 AWS 最終成長為年營收近 1300 億美元、營業利潤率高達 35.4% 的現金奶牛。
價格戰,是規模壟斷者最後的圍剿戰術。
今天能夠把模型價格壓到一折、發布即刻鋪滿全球三大公有雲貨架的人,不僅在販賣 token,更在消化 token。Anthropic 一邊血洗 API 價格,一邊用龐大的推理算力反哺 Claude Code、Cowork 與自身的端到端 Agent 產品。
中國大模型團隊依然沒有放下武器。9 月 DeepSeek 再度下調 Flash 系列資費,小米將 MiMo-Flash 推向 1 元/百萬 token 的極限,智譜亦將 GLM-5.3-Flash 定價死磕在微利區間。但牌桌上的籌碼規則已經改寫。
低價本身,已經不再是一張具備排他性的護城河牌。
在那張由 Artificial Analysis 實時更新的散點圖上,中國公司的名字一家都沒有缺席。GLM、DeepSeek、Kimi、千問、MiniMax 依然都在。
只是,它們現在已經劃不出那條斬殺線了。
原文連結
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia






