融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


英偉達力推的 800V 電壓標準,利好哪些基建廠商?

總結:
· NVIDIA 正在推動 800VDC(800 伏直流電),旨在讓下一代高功率 AI 機櫃持續堆算力。
· 市場要看的不只是 GPU,還包括供電、液冷、連接器、功率器件和整櫃測試能力。
· 關聯標的:NVIDIA、維特科技、施耐德電氣、台達電、戴爾、維穎、維創、英飛凌、意法半導體。
過去幾年,AI 基礎設施的主角一直是 GPU。誰拿到更多 H100、B200,誰就有更強的算力供給。但進入 Rubin 和後續平台,投資者需要多看一層:GPU 能不能裝進機櫃,機櫃能不能穩定供電,熱量能不能帶走,出廠前能不能滿載測試。
800VDC 開始被市場討論,原因就在這裡。NVIDIA 自 2025 年以來持續公開推動 800VDC 架構,並把它放進下一代 AI factory 和高功率機櫃的設計方向裡。表面看,這是電壓規格從傳統低壓向高壓直流遷移。往裡看,AI 伺服器不再只是板卡和晶片的組裝,越來越像一項電力工程。
普通投資者可以這樣理解:一整櫃 AI 伺服器就像一棟用電極高的小樓。過去的供電方式還能支撐幾十千瓦、上百千瓦的機櫃,但當功率繼續上升,問題就不只是「買多少 GPU」,而是電怎麼送進去、熱怎麼散出去、機器出廠前怎麼連續滿載跑起來。
高功率機櫃正在逼近低壓供電邊界
這一輪變化的起點,是 AI 機櫃功率上升太快。傳統伺服器機櫃可能只有幾千瓦到十幾千瓦,到了 NVIDIA GB200、GB300 一代,整櫃功率已經進入百千瓦級別。據 Tom’s Hardware 報道,GB200/GB300 NVL72 約為 120-140kW。
Rubin 之後,功率密度還可能繼續抬升。部分供應鏈和行業測算認為,Rubin NVL72 可能進一步來到約 180-220kW。這個區間並非 NVIDIA 官方確認口徑,仍應視作第三方估算,但方向已經清楚:前沿 AI 機櫃正在變成更高密度的用電單元。
電力問題可以用一個公式解釋:功率等於電壓乘以電流。同樣要送 600kW 的電,如果電壓較低,就必須使用更大的電流。電流越大,線纜和銅排越粗,發熱越嚴重,電能在線路裡的損耗也越高。
傳統低壓供電像是用很粗的水管慢慢送大量水。能送,但管子越來越粗、越來越重、越來越佔空間。機櫃空間本來應該留給 GPU、內存、網路和散熱結構,卻被電源架、線纜、銅排擠佔。到數百千瓦乃至更高功率級別,繼續堆低壓大電流會變得越來越不經濟。
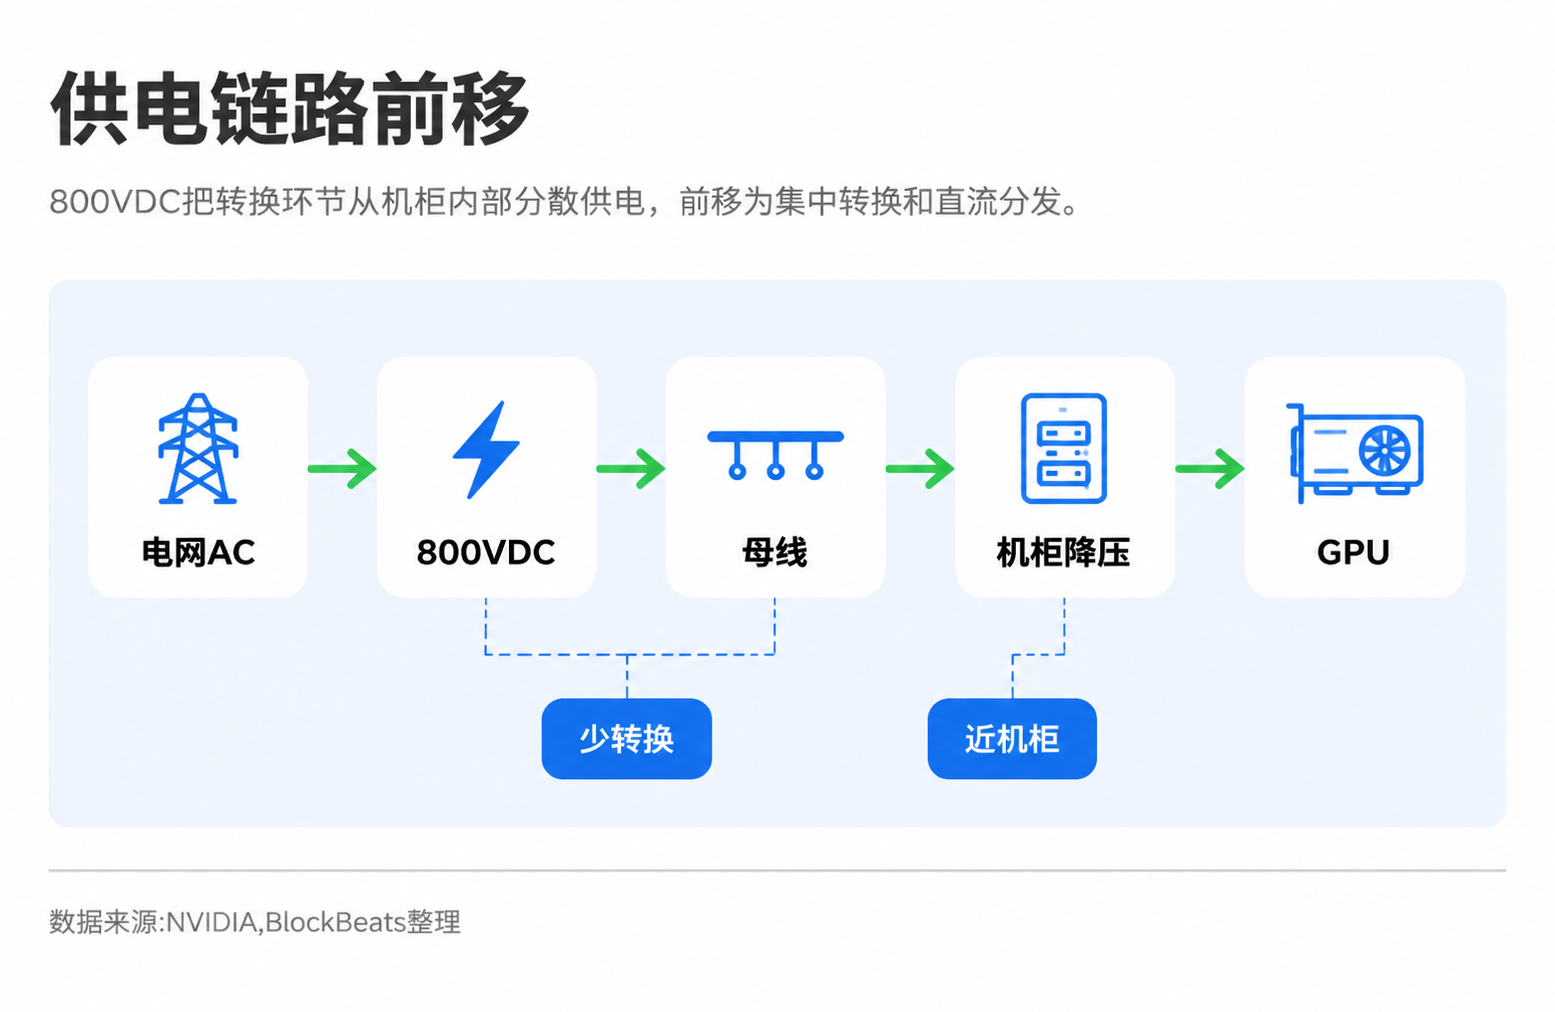
800VDC 的思路是提高電壓,把電更高效地送到機櫃附近,再在本地降壓給 GPU 使用。它像是把水壓提高,用更細的管道輸送同樣多的水。英偉達官方資料稱,800VDC 可以減少電流、銅用量、線纜體積和轉換環節,效率最高提升 5%,TCO 最高改善 30%。部分第三方和夥伴測算還提到,銅用量可能下降約 45%,實際收益取決於數據中心和機櫃集成方式。
這不是單純為了省銅。對英偉達來說,800VDC 的核心價值是讓下一代 AI 機櫃還能繼續增加計算密度。低壓系統不是不能用,但在最高密度的 AI factory 裡,它開始接近工程邊界。
英偉達用參考架構重劃基礎設施分工
英偉達重要的地方,不只是提出一個電壓方案,而是用參考架構重新定義生態分工。自 2025 年起,英偉達多次公開介紹 800VDC 架構,並在技術博客和 OCP 等場合展示面向 Rubin、Kyber rack 等高功率系統的設計方向。
據英偉達官方博客,其 800VDC 生態夥伴包括台達電、施耐德電氣、Vertiv、英飛凌、意法半導體等,也包括 ABB、伊頓、GE Vernova、Hitachi Energy、西門子、Navitas、德州儀器等公司。這裡更準確的說法是生態合作和適配,不能直接理解成訂單已經落地。
800VDC 涉及的不是單個零部件升級,而是從數據中心配電、機櫃電源、備用電池、功率器件、連接器到整柜集成的一整條鏈路變化。過去電力轉換可能分散在 UPS、PDU、伺服器電源、主板供電等多個環節。高壓直流架構下,電力更接近機櫃,再由機櫃內或 GPU 附近的模組降壓。
價值鏈裡的權重也會隨之變化。傳統伺服器時代,投資者更關注 GPU、CPU、內存和整機代工。高功率 AI 機櫃時代,電源架、母線、連接器、功率半導體、液冷系統和整櫃驗證能力,都開始變成交付能力的一部分。
邊界也要說清楚。800VDC 更像是前沿高密度 AI factory 的重要參考架構,不是所有數據中心馬上統一切換的標準。大量既有數據中心仍會繼續使用傳統交流或混合架構,新建項目也會根據功率密度、成本、業主改造意願和安全規範分層採用。市場真正交易的,不是今年全部換成 800V,而是 2027 年以後最高密度 AI 機櫃的基礎設施規則正在變化。
電源、連接、液冷和整櫃測試被推到台前
從投資角度看,800VDC 最直接的影響,是讓原本偏後台的基礎設施環節走到台前。
第一類是電源基礎設施公司,例如 Vertiv、施耐德電氣、台達電,以及部分韓國和中國台灣電力設備廠商。它們不只是賣傳統機房電力設備,而是要參與新一代 AI factory 的配電、機櫃供電、備用電池和高壓直流系統設計。據 Asia Business Daily 報導,英偉達與 LS Electric、HD Hyundai Electric、Hyosung 等韓國電力設備公司圍繞 800VDC 數據中心基礎設施進行溝通。該報導基於業內人士信息,不能等同於訂單落地,但能說明電力設備商正在被納入 AI factory 生態。
第二類是功率器件,也就是 SiC/GaN(碳化矽/氮化鎵)等新一代電力開關。它們比傳統矽器件更適合高壓、高頻、高效率場景,過去常被放在電動車、充電樁、工業電源的框架下討論,如今正在外溢到 AI 數據中心。英飛凌、意法半導體等公司因此進入投資者視野。但功率半導體的受益還取決於具體設計、供應份額、價格和良率,不能簡單等同於「800VDC 概念股」。
第三類是連接和機械結構,包括銅排、母線、高壓連接器、高端背板和部分厚銅、高層 PCB。電壓升高後,電流下降,銅耗壓力緩解,但絕緣、安全、連接可靠性和結構設計的要求更高。低端銅材並不天然受益,真正有價值的是能適配高功率、高可靠性機櫃的連接與供電材料。
第四類是液冷和整櫃 ODM。功率上升後,散熱不再是附屬問題。伺服器要在客戶機房穩定運行,必須在出廠前完成整櫃級測試,包括供電、散熱、網路和 GPU 滿載穩定性。戴爾、Wiwynn、緯創等整櫃交付方,競爭的不只是組裝效率,還包括是否有足夠電力、場地、液冷測試和系統調校能力。
設計方向清楚,交付能力還要實測
英偉達已經給出清晰的技術方向,但供應鏈執行不會自動順滑。這裡的張力,正是投資者需要跟蹤的地方。
獨立供應鏈分析師 Dan Nystedt 近期多次轉述中國台灣媒體和產業資訊:AI 伺服器 ODM 營收強勁,Rubin 相關生產準備推進,但零部件、電力基礎設施和整櫃 burn-in 測試(滿載老化測試)正在成為現實約束。所謂 burn-in,可以理解為伺服器出廠前的壓力測試。整櫃 GPU 長時間滿載運行,供電、散熱和系統穩定性都要一起過關。
單櫃如果需要 100-200kW 級別持續供電,測試工廠本身就要具備接近小型資料中心的電力和冷卻能力。這類供應鏈信號不能寫成行業已經普遍自備發電,也不能直接推導為供電已經取代 GPU 成為最大瓶頸。它更像一個提醒:Rubin 時代的交付,不只是 GPU 到貨和主板組裝,而是電力、液冷、測試和整櫃穩定性一起到位。
部分 ODM、電力設備和液冷公司被重新定價,邏輯也在這裡。它們的價值不只來自參與 AI 伺服器,而來自能否把高功率機櫃可靠地交付給雲廠商。未來如果同樣拿到英偉達參考設計,真正拉開差距的可能是測試場地、電力容量、液冷調試經驗和交付良率。
對 CoreWeave、Nebius 等 AI 雲廠商來說,800VDC 不是直接的零部件受益邏輯,而是資本開支效率和上線速度的變量。高密度機櫃能否按時部署,會影響算力交付、折舊節奏和收入兌現。Marvell、Lumentum 等高速互連或光模組鏈條,則更多屬於 AI 集群擴張的並行邏輯,不宜和 800VDC 直接受益混在一起。
2027 年看 Kyber 機櫃和訂單兌現
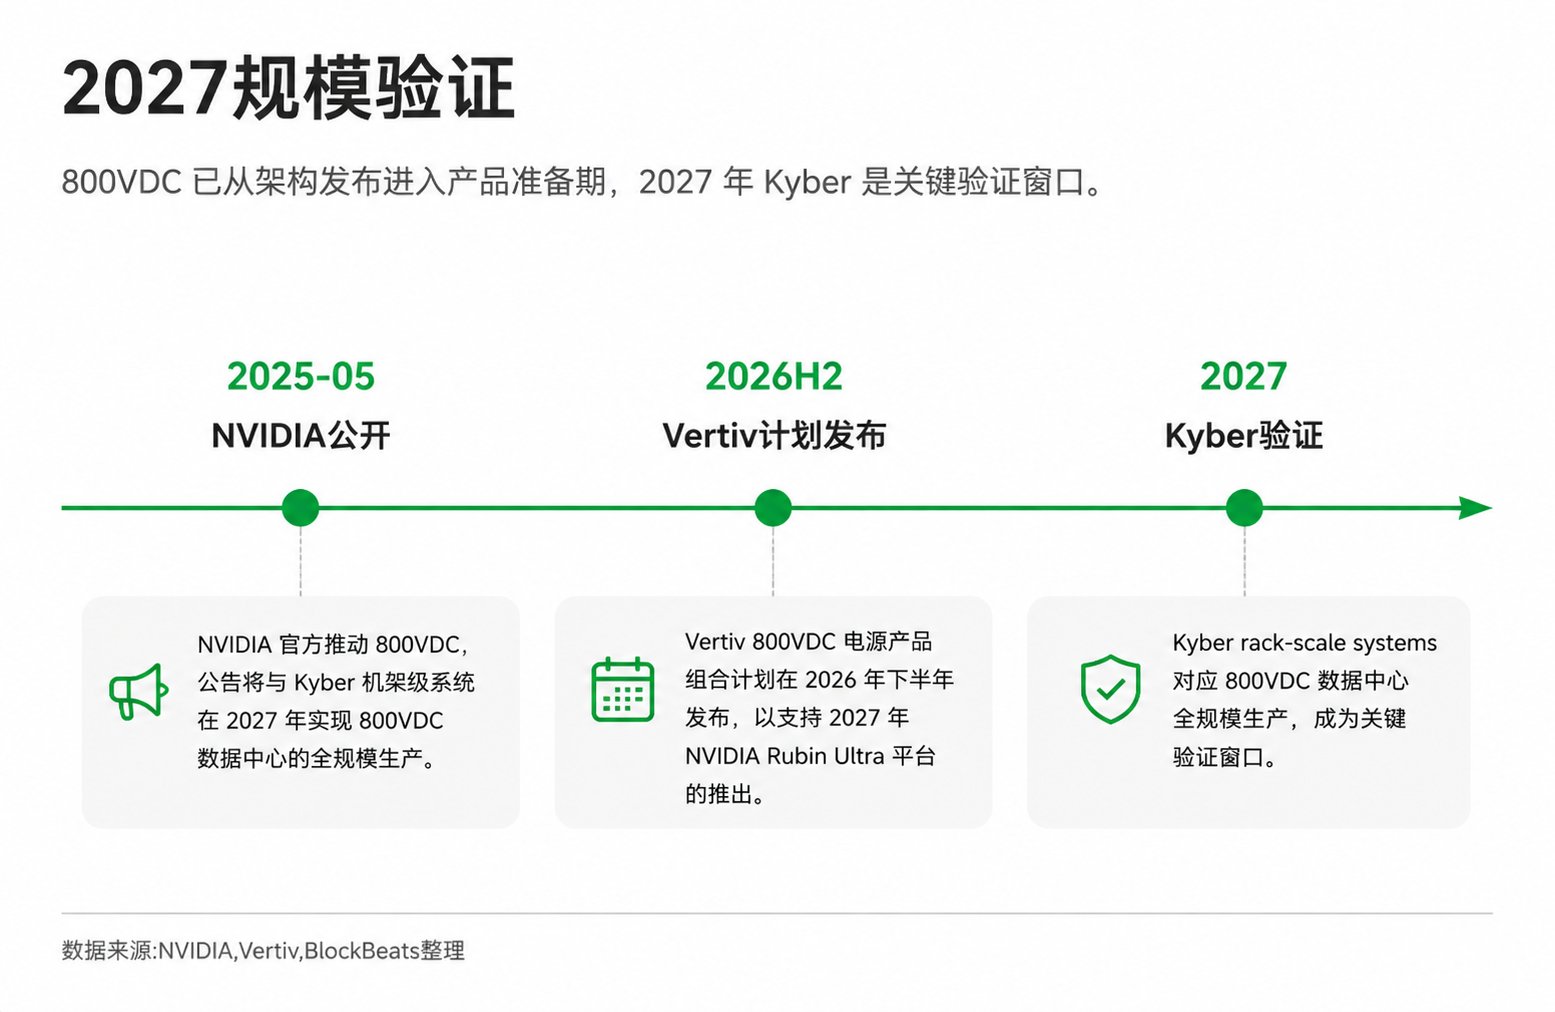
800VDC 的方向已經比一年前清楚得多:英偉達官方推動,夥伴生態適配,物理約束存在,前沿高密度 AI factory 需要更高效的供電方式。但它現在仍處於準備和早期部署窗口。英偉達官方稱,800VDC 全規模生產將與 2027 年 Kyber rack-scale 系統對應,真正驗證還要看後續產品和客戶專案能否落地。
接下來最值得觀看的,不是某家公司是否在公告中提到「AI 電力」,而是有沒有明確進入 800VDC 相關產品、客戶驗證和訂單交付。ODM 是否披露更強的整櫃測試能力,液冷系統在長時間滿載下的可靠性如何,資料中心業主是否願意為高壓直流架構改造配電和安全規範,都會影響這筆交易的節奏。
如果 Rubin 相關機櫃順利爬坡,且 800VDC 元件訂單從樣品、驗證走向規模採購,市場會繼續提高供電、液冷、連接器和整櫃交付能力的權重。反之,如果功耗配置低於預期,客戶採用更保守的混合架構,或者測試電力與液冷可靠性拖慢交付,800VDC 交易也會從方向判斷回到訂單和節奏驗證。GPU 仍是核心,但在 Rubin 之後,能不能把一整櫃高功率系統穩定交付,已經開始變成資產定價變數。
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章