融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


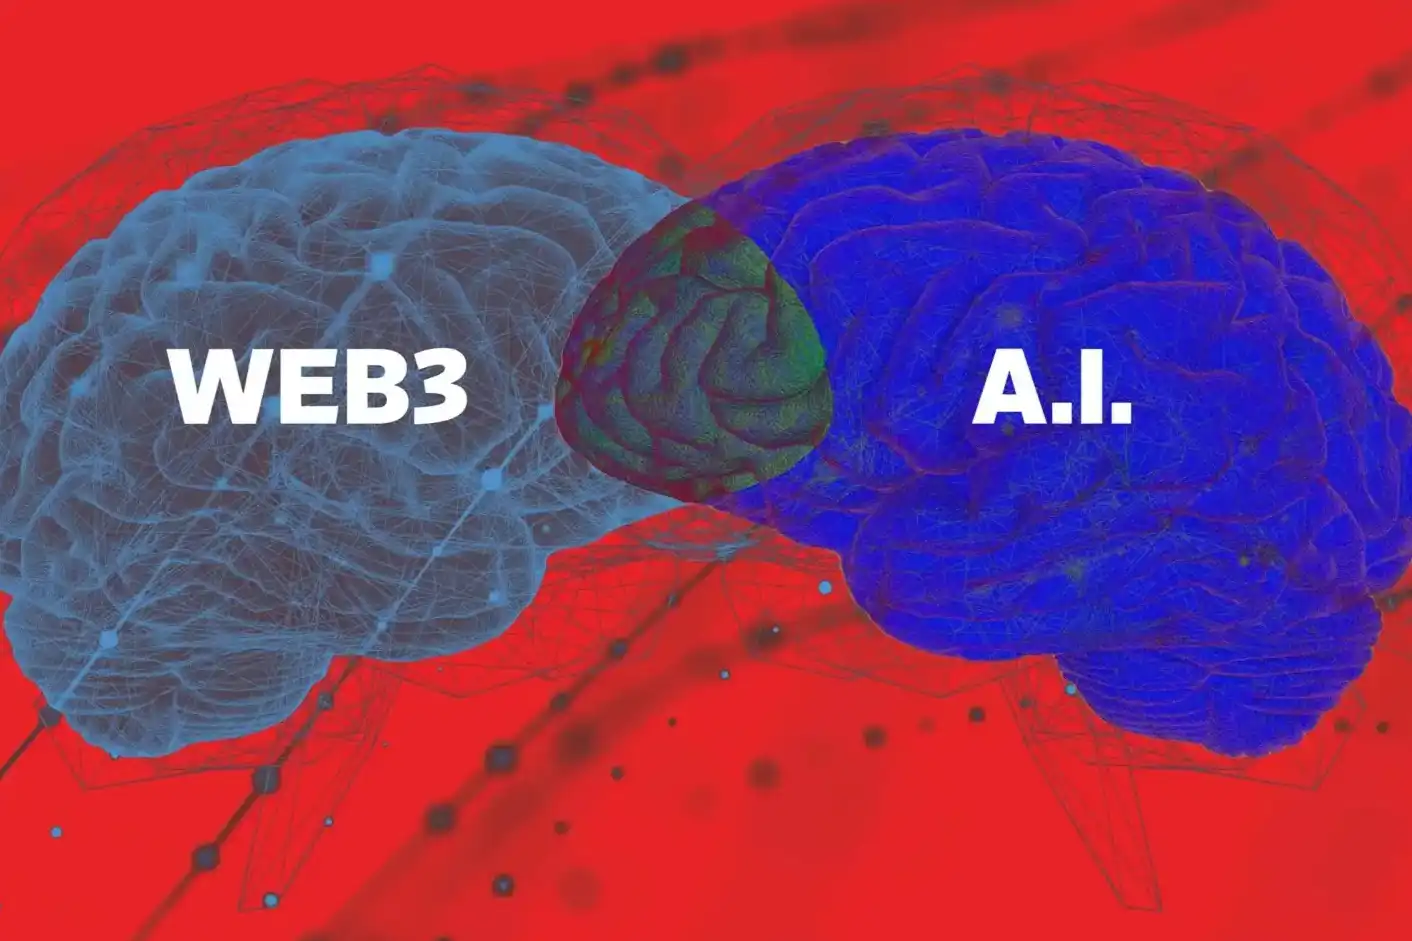
建構由人工智慧與加密貨幣驅動的去中心化大腦
原文來源:GraphProtocol中文'
概述:
· 對於目前快速發展的AI,為了防止科技巨頭對於科技的集中控制,迫切需要去中心化的解決方案。將 AI 和區塊鏈結合起來,是確保資料開放性和可驗證性的最佳途徑。
· 知識圖譜具有卓越的資料組織與檢索能力。檢索增強生成(RAG)和知識圖譜透過提供與上下文相關的最新訊息,提高了大語言模型的準確性。
· 去中心化知識圖譜是下一個重大典範轉移。它可以利用區塊鏈技術確保對資訊的開放訪問,同時透過可驗證性和透明治理來增強信任。
· Geo 是一個開創性的去中心化知識圖譜,即將在 The Graph 上推出。 Geo 將區塊鏈技術和 AI 完美整合,以創建更容易存取、更可靠、真正由用戶治理的互聯網。
· 借助人工參與驗證和AI 驅動的內容生成,資訊將以指數級的速度產生和組織,在確保信任和透明度的同時,也保持人性化的觸感。
我們已經見證了大語言模型(LLM)在主流領域的迅猛普及,以及有關這項技術可能帶來的風險的熱烈討論。很明顯,AI 將對文化、政治和真相追求產生深遠的影響。因此,我們作為一個全球化的社區,不能讓少數科技巨頭透過資料護城河壟斷人工智慧,而應共同努力,建構去中心化的替代方案。
透過確保資料保持開放和公共性,我們可以建立一個信任層,以一種在大型科技公司控制下的商業環境中無法實現的方式,來驗證數據的準確性。我們不應該受少數大型公司的偏見、假設和意見的影響,而是必須共同努力,建構一個真正可訪問、由所有人擁有的去中心化大腦。 AI 技術本身,以及 AI 技術與我們日常生活的融合,應該從一開始就被設計為公共產品,而不是在封閉的環境內,由個別科技巨頭向大眾提供。

擷取增強產生(RAG )的作用
在討論大語言模型和資訊檢索時,我們可以用人腦作為類比,來了解我們如何透過工作記憶和顯性記憶與人工智能互動。 大語言模型擅長顯性記憶。 在模型的訓練階段,大語言模型使用權重編碼數據,以便解析大量內容,並且很好的記憶這些資訊。不過,這種方式並非沒有缺點。由於大語言模型無法實際儲存所有訓練資料(因為資料量呈指數級增長),這就導致人所共知的大語言模型的「幻覺」現象,也就是大語言模型對看似簡單的某些問題,卻給了令人發笑的猜測。並且,由於無法持續進行訓練,大語言模型也就無法吸收最新的訊息,也就是說,它們對於最新創新和發現是一無所知的。這也是檢索增強生成(RAG)技術能夠成為大語言模型完美補充的原因。
RAG 是一個過程,它要求首先參考大語言模型訓練知識以外的資料集,以便為大語言模型提供新資訊和上下文。 RAG 可以被視為人工智慧大腦的工作記憶。 RAG 透過使用外部知識庫和向量資料庫來整合最新知識,提高 AI 生成內容的準確性和相關性。然而,如果過度依賴非結構化訊息,可能會導致提取資料的過程變得非常複雜,帶來資訊冗餘,還不能確保在回答的時候使用了正確的上下文資訊。
知識圖譜:超越向量資料庫
知識圖譜可以大幅增強大語言模型中RAG的能力。與向量資料庫相比,知識圖譜具有語意分析層次更深、資料檢索效率更高、可驗證性更強等多方面優勢。知識圖譜與人類認知非常相似,擅長理解自然語言的複雜性,也能細緻入微的洞察資料之間的相互關係。這種語意深度可以確保大語言模型獲得與上下文相關的準確資訊,顯著提高生成內容的品質。與此相反,向量資料庫依賴文件分塊方法,要麼忽視上下文訊息,要麼依靠無關訊息,這些都會導致大語言模型的「幻覺」現象。 只有透過知識圖譜,大語言模型才可以快速找到相關實體,並遍歷圖譜來獲取所有上下文資訊。
此外,即使在資料集不斷被追加的情況下,知識圖譜具有的結構化性質,也非常適合組織大量資料。這種結構優勢會使得檢索過程更加精確,為任何給定查詢提供最相關的數據,提高 RAG 應用程式的效能和效率。這項表現的提高,再結合從大語言模型的「顯性記憶」中找到的訊息,可以讓大語言模型的提示詞業務從兩個「記憶桶」中獲得服務,因為每個記憶桶都有其獨特風格與優勢,所以能提供更準確、更切合實際的回應。
去中心化知識圖譜:一種範式轉移
我們相信,去中心化知識圖譜可以實現區塊鏈和AI 最完美的結合——也就是說,這個解決方案可以連接世界上的所有數據,並透過深思熟慮的創造、策展、組織和組合,以易於探索的方式將它們連接起來。以前,知識圖譜通常由公司或具有獨特知識庫的群體,以集中化的方式進行構建,並持續更新。雖然這是一個很棒的解決方案,能滿足特定的需求,但它不符合我們對這項技術未來的期望:成為未來網路的基礎。
在區塊鏈和AI 技術結合方面,有別於其他的炒作和宣傳,我們認為,在重要性、範式轉移潛力和文化相關性等方面,去中心化知識圖譜是其他解決方案無法比擬的。
Geo 是建構在The Graph(世界領先、用於索引和查詢區塊鏈資料的去中心化協議)之上的去中心化知識圖譜,我們對Geo 所做的工作感到非常興奮。 Geo 開創瞭如何在真正的 web3 精神引領下,從頭開始構建這種技術的方式—讓所有人都能公開獲取所有知識,而無需守門人。
Geo:開創去中心化知識網
Geo 的目標不僅僅是將全球的資料組織成一個可搜尋的資料庫,還包括確保這些資料無與倫比的可組合性。與百科全書類似,問題的關鍵是必須有一種簡單的方式來檢索所需資訊。我們可以設想這樣一個未來世界,你可以透過「代理」與 Geo 互動。使用者直接向這些代理提出問題,然後知識圖譜檢索相關的內容、資料庫或 API,即時提供給大語言模型(LLM)使用。與目前逐一查看搜尋結果的模式不同,代理程式會在載入與你查詢相關的所有資訊後,直接給出針對你的問題的答案。
當然,輸入到代理程式中的資訊品質至關重要,而這正是區塊鏈技術的優勢所在:身分和信譽。透過對每個資訊進行原作者認證,確保作者身分可追蹤、可驗證,可以有效保障資訊來源的屬性和品質。此外,由於所有內容都是高度可組合的,我們可以在不影響原始數據的情況下,根據自身的興趣和需求,定制與這些資訊的互動方式。
透過The Graph 建構去中心化腦
我們的整體願景是建構一個去中心化大腦,儲存來自各種資料來源的訊息,然後由人類將其整理成若干個稱為“Spaces”的獨立社群。這個共享的大腦能夠利用結構化的資訊進行推理,以確保 AI 做出明智的決策。去中心化的大腦一旦誕生,就可以透過 API 連接到現實世界,成為真正自主的智慧代理,為使用者執行任務,自動化處理日常瑣事,讓人類可以專注於更有意義的工作。同時,相互關聯的知識圖譜,能夠從多個動態資料來源中提取數據,以確保資料的多樣性。
一個新的資料貢獻與驗證生態系
在全球資料服務領域中,The Graph 依托新開發的互聯資料圖譜,處於實施此架構的最佳位置。在現有眾多服務的基礎上,The Graph 將增加對大語言模型資料服務的支持,也就是說,索引者將提供開源的模型推理服務。這些模型能夠直接訪問,或透過便捷的開發者工具調用,經過互聯資料圖譜驗證的資料。有史以來第一次,開發者可以使用一個開放、可組合、低延遲、完全整合的技術棧,建立比以往更強大的人工智慧代理。
從資訊檢索到知識創造:大語言模型和人類的角色
我們必須採用與眾不同的方法來建立未來的去中心化大腦,以增強人工智慧系統的彈性和可靠性,確保大語言模型提供有意義的回應,並簡化檢索增強生成技術(RAG)。在 The Graph 新紀元的設計和架構中,我們可以看到精心構建的知識圖譜,如何幫助我們建立更美好的未來。
1、只有經過加密驗證、信譽可追蹤的貢獻者,才能將資訊加入到互聯圖譜中(因此也加入Geo 空間)
2、或者,資訊也可以從可驗證的第三方資料來源聚合得來
3.大語言模型在工作記憶中已儲存的資料與新加入的資訊之間建立邏輯連結。此後,Geo 中的人類再對這些資訊進行驗證
4、智慧代理從人類接收到提示詞,並使用RAG 從互聯圖譜中檢索最相關的資訊
5、那些希望向Geo 空間貢獻內容的用戶,因為能夠直接存取相關數據,獲得更全面的信息,所以能夠創建更高品質的內容
6、智慧型代理本身可以作為使用者互動介面存在。透過代理,使用者可以要求訊息,自己創作並提交新內容。智慧型代理可以幫助使用者編輯、新增、存取和連結其他相關資訊
7、為了更好的完成整個知識循環過程,還可以引入策展人角色。透過引入可信賴的人類參與標記訊息,知識圖譜可以快速確定哪些數據最有價值。我們將重新設計 The Graph 中策展人的角色定位,並利用 GRT 激勵他們。
不難想像,未來大語言模型將在人類的幫助下自主擴展知識圖譜,而不是人類利用大語言模型來檢索資訊。大語言模型可以產生訊息,並將訊息提交給可信賴的人類進行驗證。這將大大加快資訊聚合的速度,同時保留人類對資料的驗證,更重要的是,保留了人類對資料的接觸。我們可以禁止大語言模型直接添加數據,從而過濾掉潛在的幻覺訊息,同時在大語言模型的幫助下處理日常任務。
去中心化知識圖譜中的信任與透明度
將區塊鏈技術與知識圖譜結合,可以為資料驗證提供額外的信任層。每條數據都可以歸因於可驗證的來源,並保持有關數據來源、修改記錄以及相關人員的清晰記錄。這種透明性增強了資料的可信度,並為資料使用創造了安全的環境,確保去中心化知識圖譜成為推進大語言模型中 RAG 技術使用的最佳選擇。

透過Geo 瀏覽器,我們可以便捷的獲取全球信息,這使得處於新紀元的The Graph 在這一激動人心的互聯網革命中處於獨特的前沿位置。一個真正開放的、去中心化的人工智慧大腦需要開放透明的治理,而這一點在中心化的架構下是無法實現的。所以,The Graph 不僅滿足了世界對去中心化知識圖譜的需求,也讓全球使用者群體都能參與如此重要工具的治理。
讓我們砥礪前進。
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
 相關文章