融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


SemiAnalysis研報:為什麼下調晶片需求預期,並大幅下修輝達收入預期?
原文標題:Revising Down Accelerator Demand and Shipment Outlook; NvidiaBears the Brunt
原文作者:Myron Xie and Ivan Chiam
編者按:一顆英偉達 Feynman Ultra,在 SemiAnalysis 的兩版模型裡,平均售價相差約 7.7 萬美元。11 月 13 日,這家半導體研究機構把這款晶片的平均售價預測從約 17.5 萬美元降至 9.8 萬美元,降幅約 44%。高頻寬記憶體(HBM)成本回落解釋了其中一部分,剩下的調整則反映了分析師對英偉達定價能力的新判斷。隨著大客戶手裡的替代方案增多,英偉達下一代晶片能收取的溢價可能低於此前預期。
這輪調整遠不止英偉達。SemiAnalysis 將 2028 年全球 AI 加速器支出預測從 1.054 萬億美元下調至 7,580 億美元,少了近 3,000 億美元。按新版模型,到 2030 年,年度支出仍將超過 9,000 億美元,是 2026 年的兩倍以上。增量依然可觀,但前沿 AI 實驗室第三季度淨新增年化經常性收入放緩,投資者也收緊了對資料中心的融資。缺少大客戶採購承諾的項目,往往要先解決誰來出錢建機房、接電、買設備,晶片訂單才有望兌現。
英偉達面對的壓力來自兩類客戶。Anthropic 可以在谷歌 TPU、亞馬遜 Trainium 和兩家 GPU 廠商之間分配算力。OpenAI 既在推進自研晶片,也能從與 AMD 的認股權證交易中獲得潛在收益。與此同時,英偉達在各家晶片供應商中對新興雲服務商的敞口最大。這些客戶需要先籌資買下 GPU,再靠出租算力回收投入。頭部買家有更多選擇,依靠融資擴張的買家又更難下單。兩股壓力疊加,SemiAnalysis 將英偉達 2030 年出貨對應的算力產品收入預測下調了 66%。
博通和聯發科的對比,則揭示了這輪競爭裡容易被忽略的一筆賬。兩家都參與 TPU 項目,聯發科能提供更低的系統成本,博通卻有能力為土地、電力、機房和設備的融資安排提供支持。對資金吃緊的買家而言,一套系統最終花多少錢,和今天要拿出多少現金,是兩道不同的採購門檻。當晶片競爭延伸到整個資料中心,能幫客戶把項目建起來的供應商,也更有機會拿到訂單。
以下為原文:
TL;DR
·SemiAnalysis 將 2028 年加速器支出預測從 1.054 萬億美元下調至 7,580 億美元,2030 年預測較舊版低約 40%。
·前沿 AI 實驗室第三季度淨新增年化經常性收入放緩,債權和股權投資者也收緊了對 AI 基礎設施的融資,缺少大雲廠商採購承諾的項目尤為脆弱。
·高帶寬內存(HBM)價格假設下修,是加速器支出預期下降的主要原因之一。新模型下,以比特計的 HBM 需求仍逐年增長。
·英偉達的數量和價格假設雙雙下調。按出貨對應的算力產品收入衡量,2027 至 2030 年預測分別下調 22%、39%、56% 和 66%。
·博通 2026 至 2030 年定製芯片累計收入預測下調 11%,主要來自 HBM 降價。聯發科為 Anthropic 設計的 Triggerfish,全生命周期出貨量預測下調 42%。
·AMD 遠期支出預測同樣下修,但認股權證交易增強了其對 Meta 和 OpenAI 的吸引力。亞馬遜 Trainium 的 2027 年和 2028 年出貨預測維持原水平。
需求預測調整
我們下調了整個預測期內 AI 芯片與服務器的出貨量、支出和電力需求預測,其中 2028 至 2030 年的預測受影響更大。這次下調反映了三方面的調整,即出貨量減少、價格下降,以及對 2029 年和 2030 年未來加速器項目採用更低的單芯片功耗假設。
總體而言,我們調整預測的原因如下。
1、我們重新評估了整個生態系統的 token 總收入預期,特別是考慮到各家前沿 AI 實驗室第三季度的淨新增年化經常性收入(ARR)放緩。因此,我們下調了對新增供給的估計,使收入能夠更持續地覆蓋整體算力成本,正如我們在近期報告中指出的那樣。我們對這些實驗室的收入仍比市場共識更樂觀,也看到許多可以部署前沿 AI 能力並獲得高投資回報的領域。不過,基礎設施建設能否獲得融資,取決於資本市場參與者的整體預期,這就引出了下一點。
2、資本市場已經收緊,債權和股權投資者都更不願意為 AI 基礎設施建設相關的資本支出出資,尤其是沒有超大規模雲廠商承諾採購的項目。我們在融資框架報告中討論過這個問題。這將減少數據中心的土地開發、電力配套及主體建築建設,受影響的項目將更多集中在缺乏超大規模雲廠商支持的項目上,可用於部署系統的電力也將隨之減少。
3、美國中期選舉的結果導致原計劃於 2027 年下半年和 2028 年上半年投用的 5.8 GW 美國數據中心容量推遲。監管因素造成的進一步延期也在壓低 2028 年的數據中心總容量。我們在分析中也考慮了這一因素,它確實導致近期算力設備出貨量有所減少,但我們強調,前面兩項因素更為重要。
下調幅度在各晶片平台和供應商之間並不一致。按照我們的分析框架,客戶仍會優先選擇單位總擁有成本性能(perf/TCO)和單位功耗性能(perf/W)最好的晶片,並在此基礎上考慮融資條件。在這些指標上排名最靠後的平台,削減幅度將更大。結果是,英偉達受到的衝擊最大,支出削減的大部分集中在英偉達。除此之外,在 ASIC 項目中,我們預計聯發科的 TPU 項目也會受到影響,因為它的融資能力弱於博通。下圖總結了加速器與 HBM 相關總支出的變化。
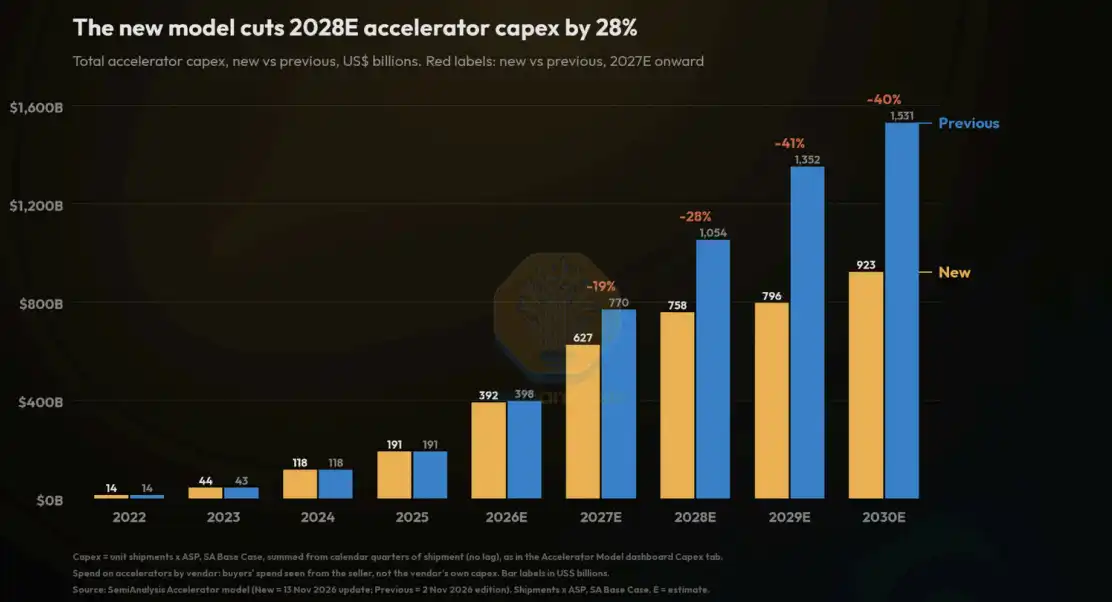
新模型將 2028 年加速器資本支出預測下調 28%。加速器資本支出總額,新舊模型對比,單位為十億美元。自 2027 年預測值起,紅色數字標示新模型相較舊模型的變動。黃色為新版,藍色為舊版。
總支出的下降主要由價格走低推動。隨著出貨量預測下調,HBM 的供需關係更加平衡,因此我們也下調了 HBM 的價格假設。更多詳情見同期發布的內存模型更新。為此,我們把 HBM 價格的變化計入各款晶片的預測,以反映物料清單成本(BOM)的變化。對於從 Feynman 開始的英偉達未來各款產品,平均售價(ASP)的下調還反映了較低的加價幅度,以及 HBM 成本的變化。這反映出 AI 硬件市場的競爭已經顯著加劇。
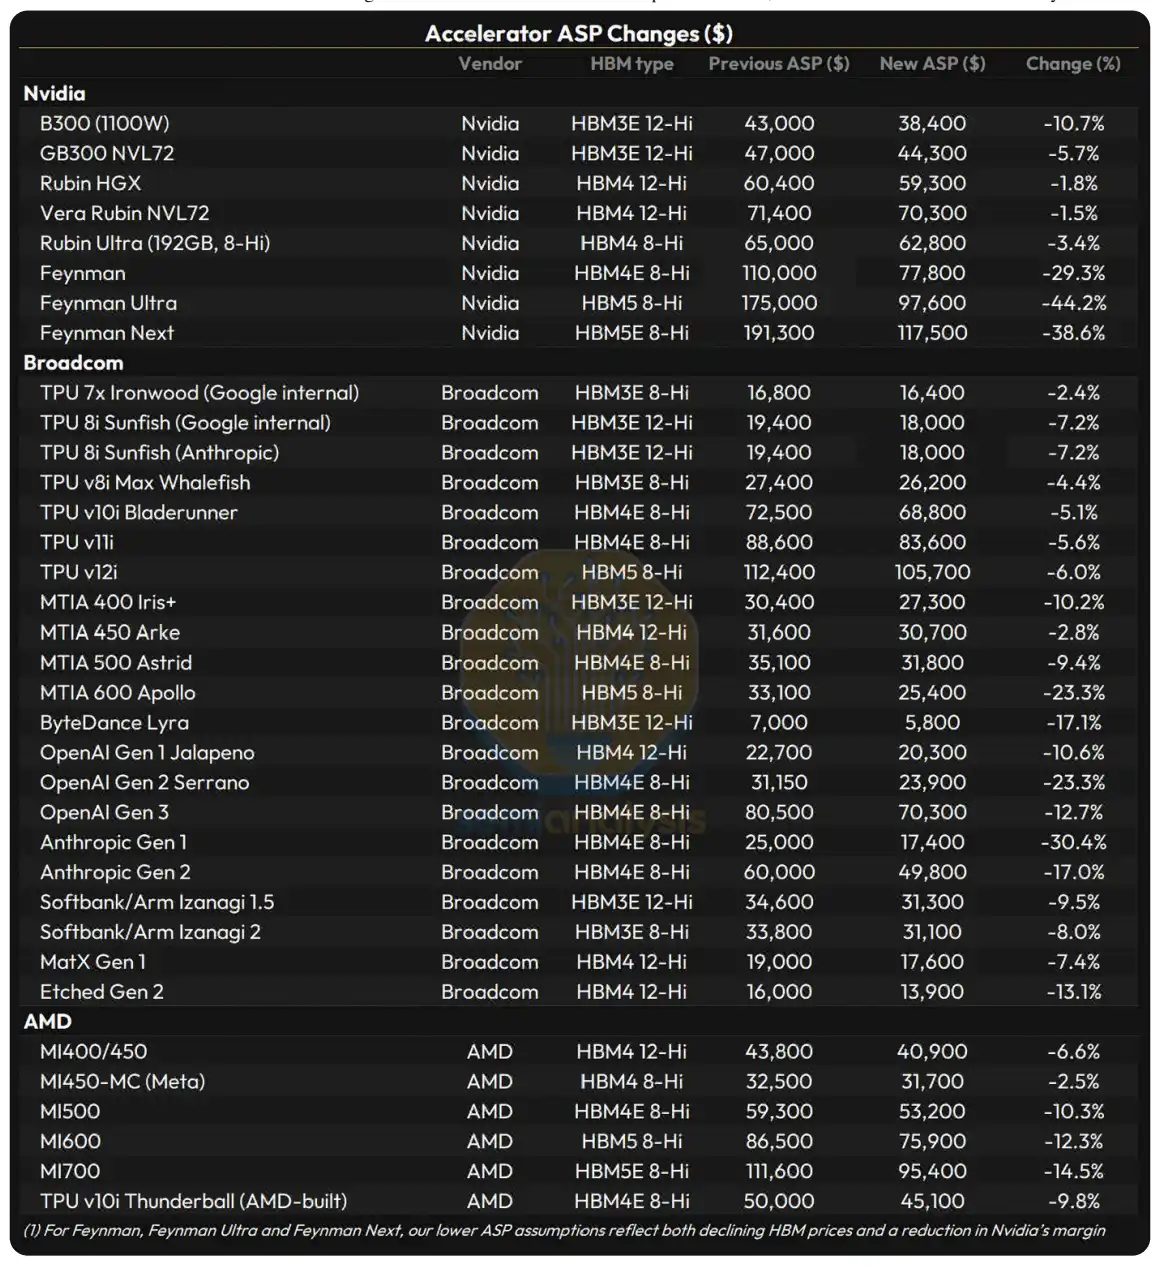
加速器平均售價(ASP)調整,單位為美元。產品型號、供應商、HBM 類型、舊模型平均售價、新模型平均售價、變動幅度(%)。來源:SemiAnalysis。
此前預測的 2027 年支出增量中,相當一部分來自價格上漲,尤其是記憶體漲價。因此,隨後的價格回落意味著供應鏈恢復到更為「正常」的狀態。
價格變化也解釋了為什麼出貨對應的矽面積和以位元計的 HBM 需求仍在上升,且增長快於名義支出。
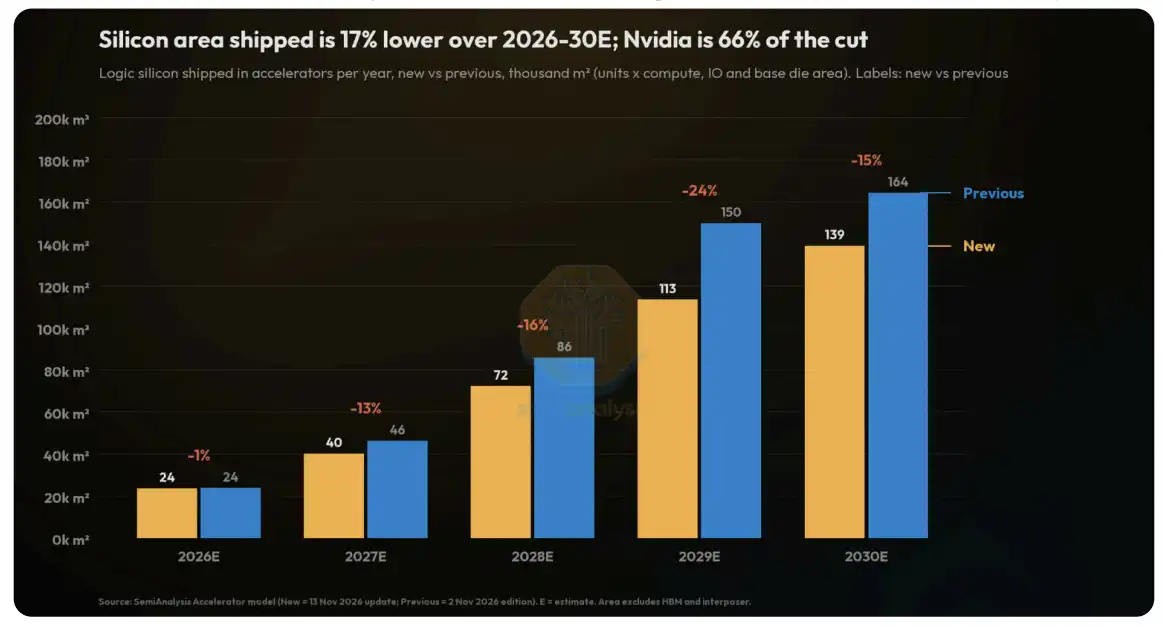
2026 至 2030 年預測出貨的矽面積合計下調 17%,輝達佔下調量的 66%。
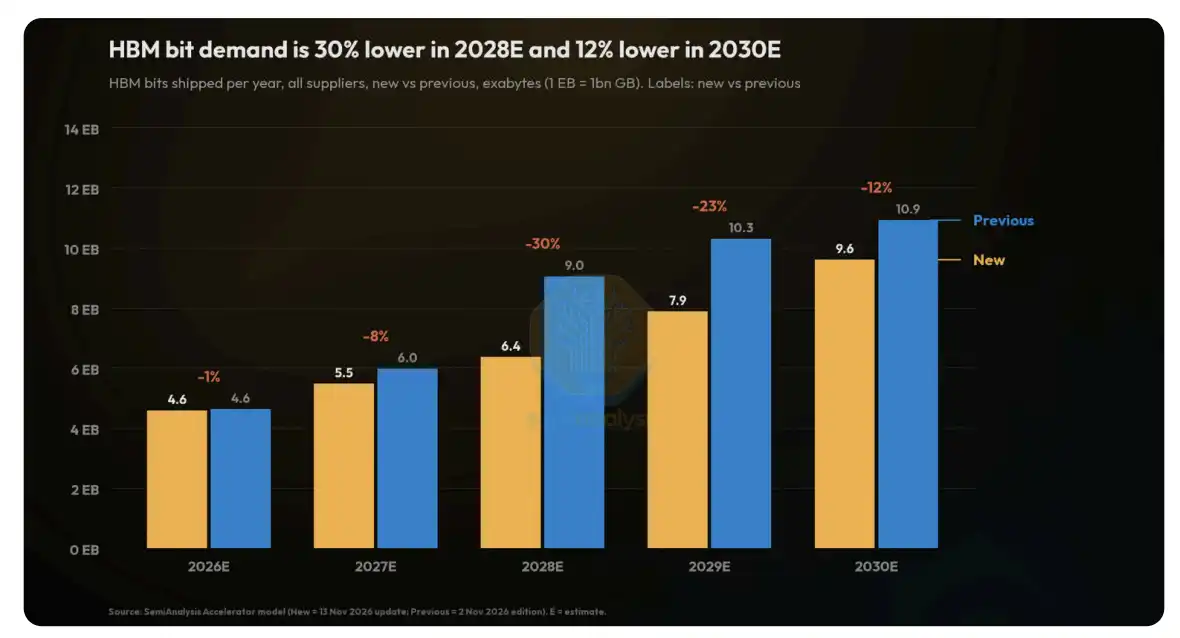
2028 年 HBM 位元需求預測下調 30%,2030 年下調 12%。
AI 電力需求預測也有所下調。這是出貨量減少和單晶片功耗假設下調共同作用的結果。由於電力仍是制約因素,我們預計未來的產品路線圖會下調晶片的最大功耗。電力需求的下降也意味著,按我們的資料中心模型修訂後的 2027 至 2029 年全球(不含中國)電力供應預測,這些出貨的設備有足夠電力完成部署。
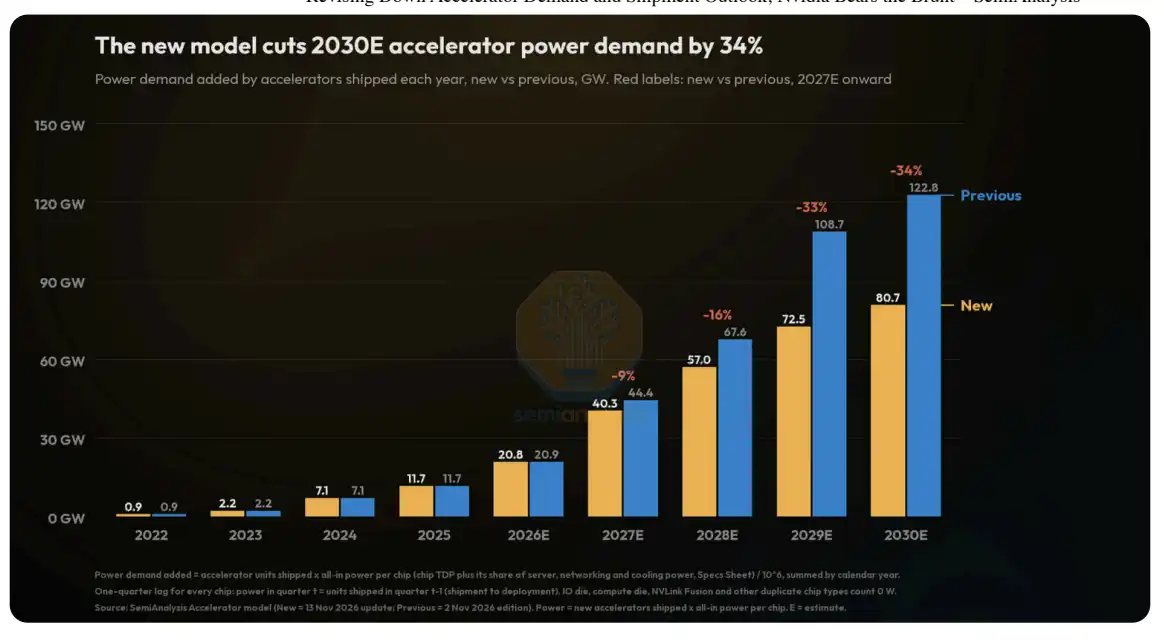
新模型將 2030 年加速器電力需求預測下調 34%。
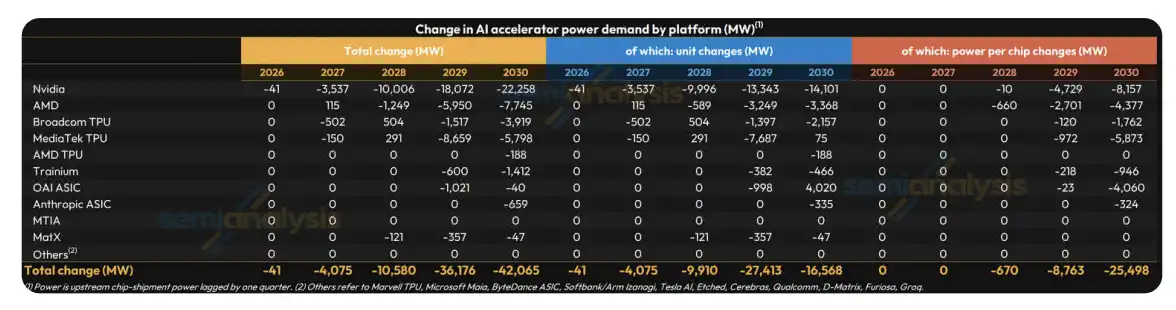
各平台的 AI 加速器電力需求變動,單位為 MW。
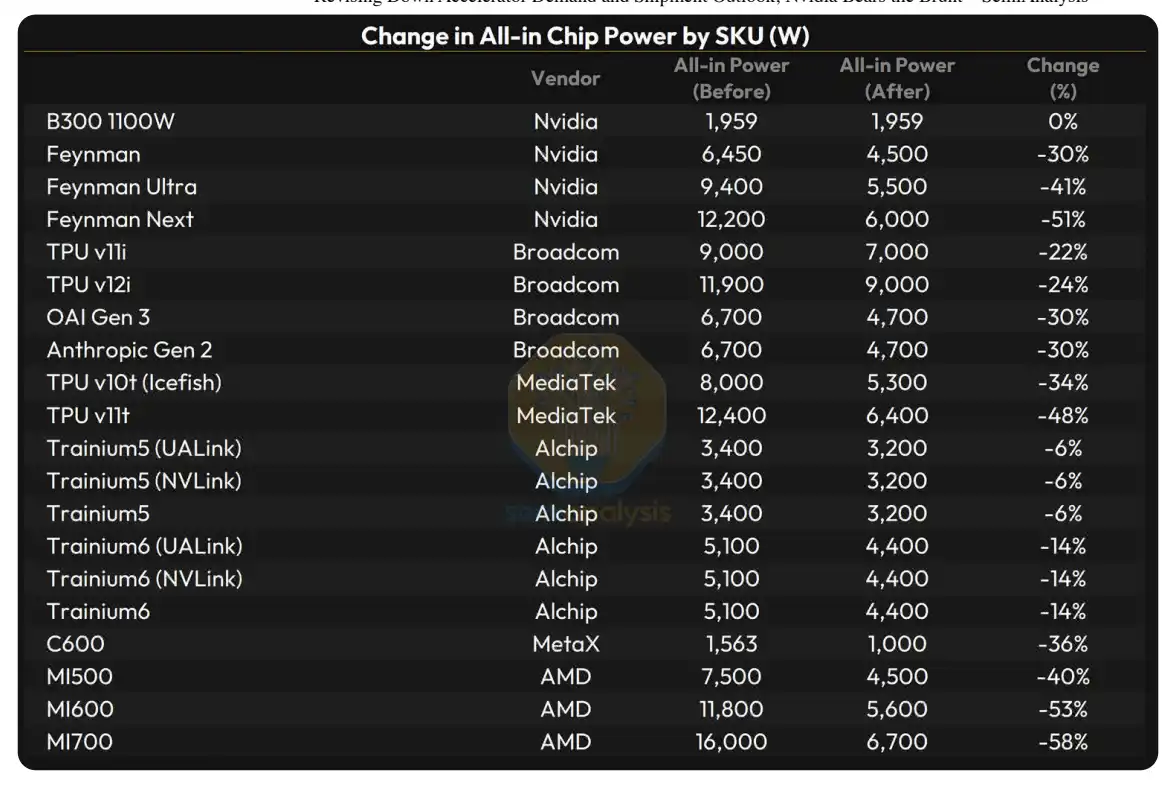
各型號晶片的綜合功耗變動,單位為W。
接下來,我們將按供應商和平台逐一回顧這些變化。
輝達
按算力產品收入衡量,我們將輝達 2027、2028、2029 和 2030 年的出貨預測分別大幅下調 22%、39%、56% 和 66%。按綜合功耗衡量,則分別下調 14%、35%、50% 和 59%。從 Feynman 開始,除了計入 HBM 成本變化,我們還進一步下調了平均售價假設,因為我們認為,輝達需要接受更低的利潤率,才能保持相對於其他項目的競爭力。Feynman 的預測售價從約 11 萬美元下調至約 7.8 萬美元,Feynman Ultra 從約 17.5 萬美元下調至約 9.8 萬美元,Feynman Next 從約 19.1 萬美元下調至約 11.8 萬美元。價格和出貨量同時下調,意味著輝達的預測收入將顯著下降。下調涉及 GPU、Groq LPU 和獨立 CPU。
我們對輝達需求的下調幅度最大,因為在前沿 AI 實驗室的算力體系中,輝達 GPU 的吸引力排名靠後。在 Anthropic 所用的四大算力平台中,也就是 TPU、Trainium、AMD GPU 和輝達 GPU,輝達 GPU 的地位最邊緣。就單位成本性能而言,Anthropic 更青睞其他平台。
雖然 GPU 在 OpenAI 的基礎設施中扮演更重要的角色,但把 AMD 認股權證交易帶來的可觀財務收益考慮在內,AMD GPU 已成為很有吸引力的選擇。此外,OpenAI 將優先部署其 ASIC 項目的 Jalapeno 和下一代 Serrano,因為這些晶片的單位總擁有成本性能已處於領先地位。
此外,輝達在各供應商中對新興雲服務商(Neocloud)客戶的敞口最大,尤其是規模偏小的長尾客戶。如今,新興雲服務商在項目執行和融資能力兩方面都面臨大得多的風險。中國終端客戶向新興雲服務商承諾採購的算力規模也相當可觀。《RASA 法案》成為法律的可能性似乎正在上升。一旦生效,遠程訪問 GPU 將被視為出口,中國客戶遠程訪問先進 GPU 因此將構成違反出口管制。
最後,我們指出,這次模型調整未計入黃仁勳辭任輝達 CEO 的影響。即便黃仁勳繼續擔任 CEO,我們也會作出同樣的調整。鑑於黃仁勳對輝達的重要性,我們認為,此次領導層交接將加大市場份額下滑的風險,降幅可能超過我們在此列出的預測。
由於 Vera Rubin L6 板卡的出貨從第三季度推遲到第四季度,我們也調整了 2026 年第三和第四季度的預測。我們把約 10 萬顆 Rubin GPU 從 2026 年第三季度移至第四季度,2026 年 Vera Rubin 全年出貨量維持約 98 萬顆。GB300 在第三季度增加約 13 萬顆出貨量,填補這一缺口。隨著 Rubin 加快放量,我們在 2026 年第四季度的預測中調減了約 26 萬顆 GB300 和約 15 萬顆 H200。綜合上述調整,輝達 2026 年第三季度總收入約為 1,091 億美元,第四季度約為 1,253 億美元。
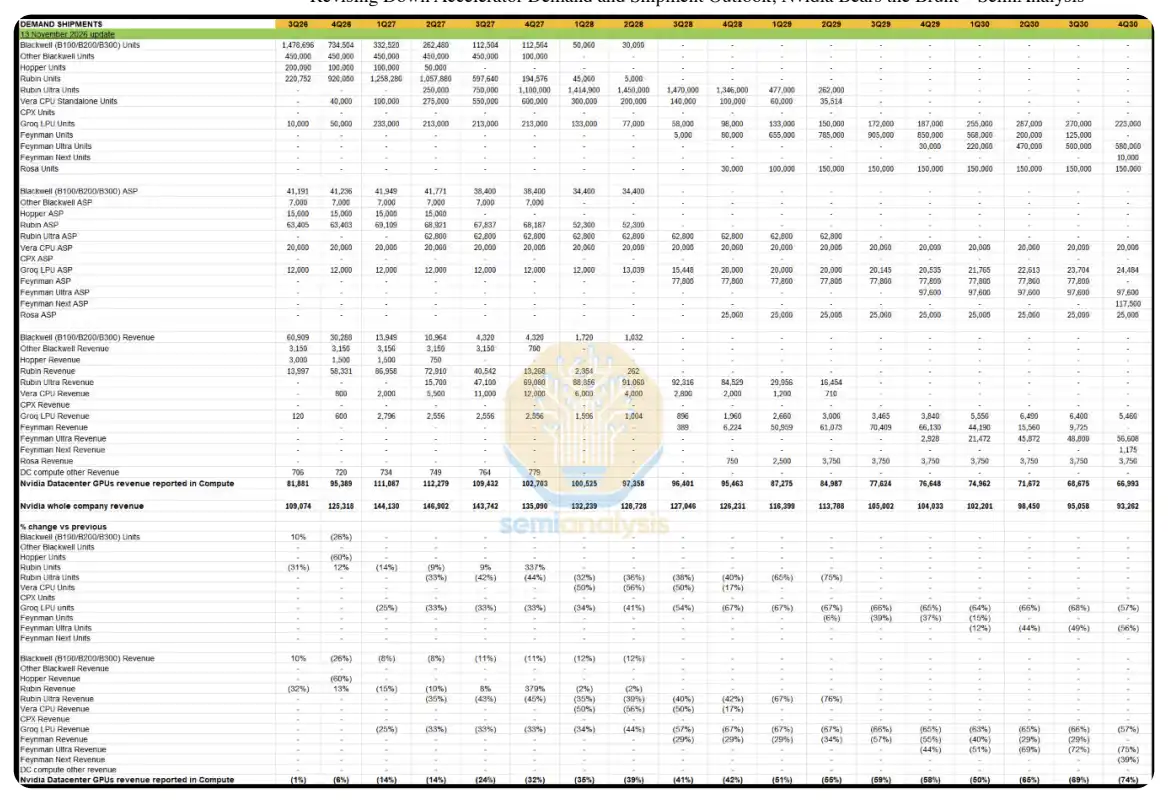
出貨量預測(輝達)。表格以 2026 年 11 月 13 日為更新日期,按季度列示各型號出貨量、平均售價及收入,另列相較上版的變動比例。彙總項包括計入算力業務的輝達數據中心 GPU 收入和輝達全公司收入。來源:SemiAnalysis。
博通
博通受到的影響最小,2026 至 2030 年的 ASIC 累計收入預測下調 11%,主要是 HBM 成本降低帶動平均售價下調,出貨量削減的影響較小。我們認為,博通的需求不會下降,因為它的三大 ASIC 項目(TPU、OpenAI 和 Anthropic)能為終端客戶提供更高的單位成本性能和單位功耗性能,同時博通也有能力為債權人提供的融資安排托底,為土地、電力、主體建築和系統籌措資金。就 OpenAI 而言,我們將 2029 年第二代 Serrano 的預測規模下調 1 GW,同時大幅上調了 2030 年第三代產品的出貨量。
我們小幅下調了 TPU 出貨量,涉及谷歌和 Anthropic。由於預計德克薩斯州的數據中心開發將暫停,我們還把原定在 2027 年向 Anthropic 交付的 700 MW TPU 推遲到 2028 年。我們的數據中心團隊預計,Crusoe/Goodnight 項目約有 275 MW 容量將從 2027 年第四季度延後,位於 Hubbard 的 Nexus 項目另有 330 MW 尚未獲批,也面臨風險。兩處項目均用於部署 Anthropic 的 TPU。
博通另一個被我們下調預測的項目來自初創公司 MatX。我們認為,MatX 的不確定性更高,也更難獲得融資,因此下調 Anthropic 對 MatX 芯片的需求預估。
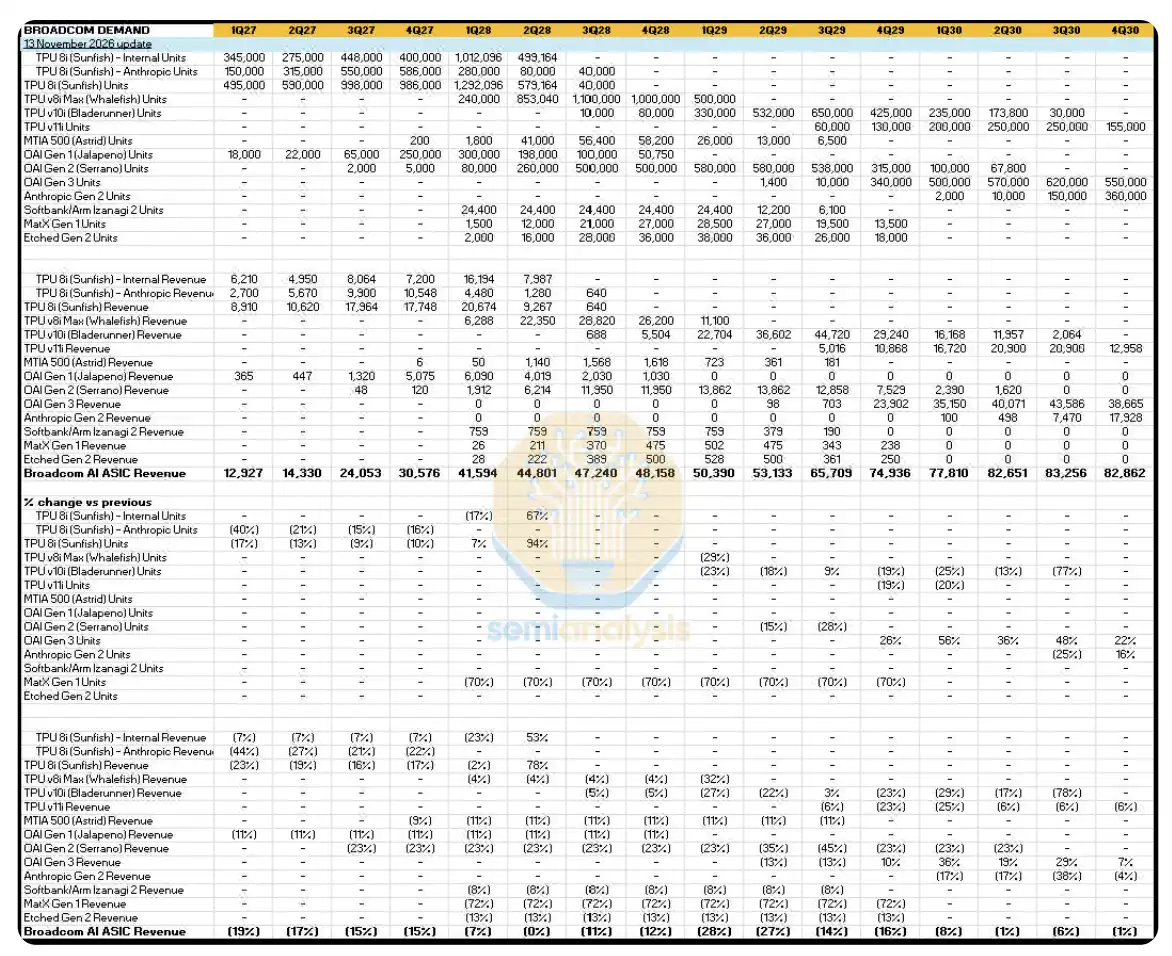
博通需求。表格以 2026 年 11 月 13 日為更新日期,按季度列示 TPU、OpenAI、Anthropic 等項目的出貨量、收入和相較上版的變動比例。匯總項為博通 AI ASIC 收入。來源:SemiAnalysis。
聯發科
我們對聯發科出貨量的下調幅度更大。
這既反映了融資因素導致 Anthropic 的需求下降,也反映了我們對 TPU 總需求的重新調整,因為按我們的模型,聯發科未來將承擔大部分 TPU 出貨量,特別是谷歌內部使用的 TPU。即便經過此次下調,聯發科在 2029 至 2030 年的 TPU 出貨量仍高於博通和 AMD/Marvell 等其他合作夥伴。此外,由於聯發科的客戶自行採購 HBM,HBM 降價對聯發科沒有影響,因此收入預測的變化完全來自出貨量下調。
下調主要集中在 TPU v9 的兩款產品 Humufish 和 Triggerfish。我們將 Humufish 在 2028 和 2029 年的全生命週期出貨量合計下調 47 萬顆,這主要反映了 EMIB-T 良率仍面臨風險。
鑑於融資約束是本次調整的主要原因之一,我們認為,博通為整個建設項目提供融資支持的能力對 Anthropic 更為重要。因此,我們下調幅度最大的項目是 TPU v9i(Triggerfish),其全生命週期出貨量下調 42%。Triggerfish 在設計時參考了 Anthropic 的意見,原計劃成為聯發科首款對外銷售給 Anthropic 的 TPU。
不過,我們也認識到,聯發科的整體利潤率低於博通,因此系統總成本更低,在資金受限時具有吸引力。這需要谷歌承擔更多融資責任,或由 Anthropic 提高預付款。
對於後續的 TPU v10t(Icefish),我們放慢了 2029 年的放量速度,並將更多出貨量移至 2030 年。
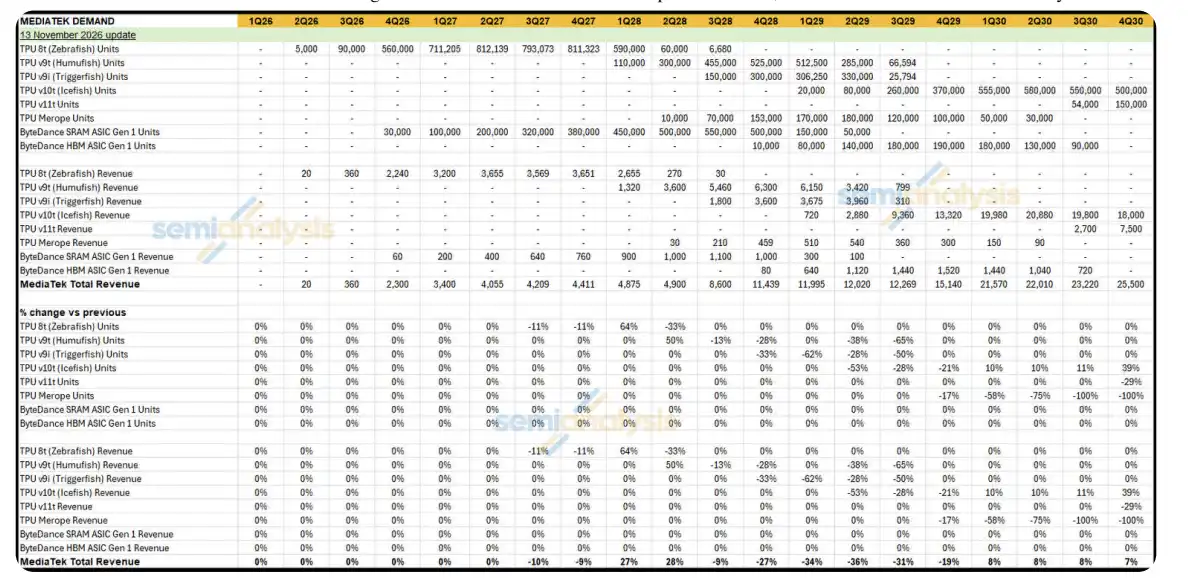
聯發科需求。表格以 2026 年 11 月 13 日為更新日期,按季度列示各型號 TPU 及字節跳動 ASIC 項目的出貨量、收入和相較上版的變動比例。彙總項為聯發科總收入。來源:SemiAnalysis。
AMD
按綜合功耗口徑,我們將 AMD 2028、2029 和 2030 年的預測分別下調 23%、55% 和 57%,按支出口徑則分別下調 29%、35% 和 32%。2027 年的功耗預測大致持平,支出預測下調 11%。雖然 AMD 也屬於面向公開市場銷售商用晶片的供應商,但收入下調幅度小於英偉達,因為 AMD 對超大規模雲廠商和前緣 AI 實驗室客戶的敞口更大,這些客戶包括 Meta、OpenAI 和 Anthropic。對 Meta 和 OpenAI 來說,認股權證交易使購買 AMD 系統幾乎成了無需猶豫的選擇。Anthropic 沒有認股權證交易,但我們認為,AMD 的定價對 Anthropic 仍非常有利。在推理的單位美元性能方面,AMD 對 Anthropic 的吸引力僅次於 TPU。
此外,就近期而言,我們將 MI400 的放量時間提前,以反映 2026 年第四季度更強勁的產量爬升。我們把約 2.5 萬顆 MI400 和約 3 萬顆 Meta 定製版 MI450-MC 從 2027 年第四季度移至 2026 年第四季度。
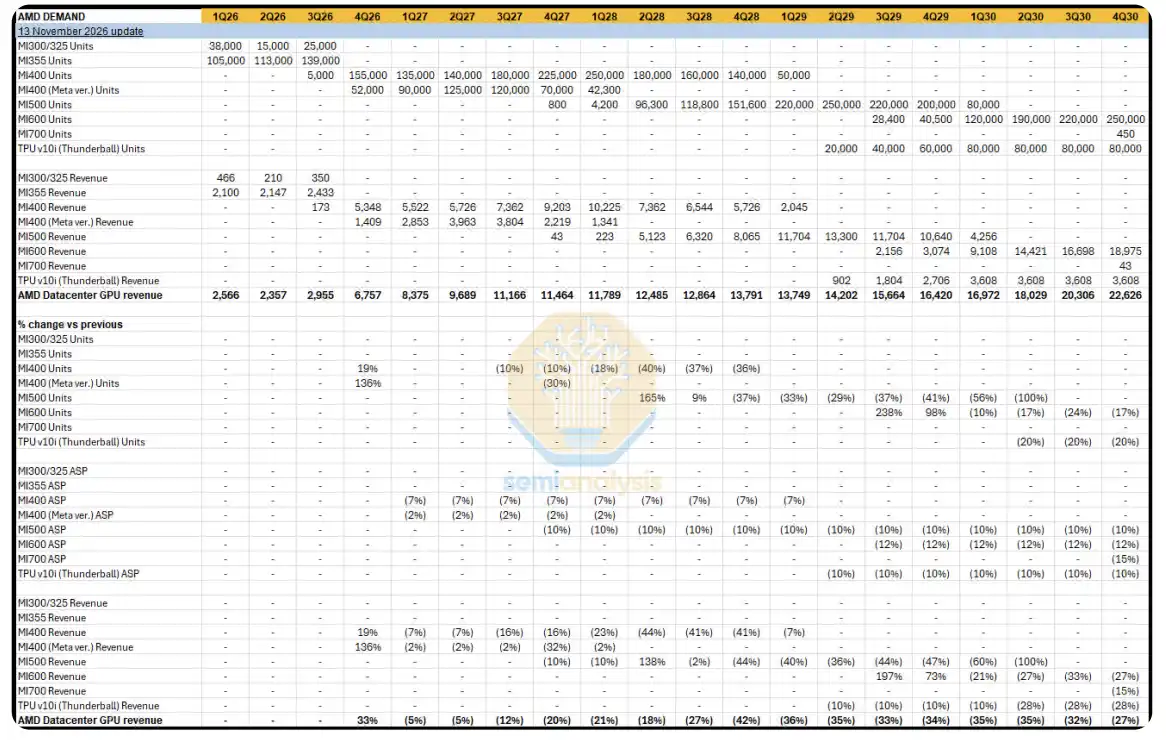
AMD 需求。表格以 2026 年 11 月 13 日為更新日期,按季度列示各型號出貨量、收入和相較上版的變動比例,並列出平均售價的變動比例。彙總項為 AMD 資料中心 GPU 收入。來源:SemiAnalysis。
亞馬遜 Trainium
我們維持 2027 年和 2028 年 Trainium 的出貨預測。對於 2029 年,我們把預計由 Trainium4 承擔的出貨量轉給 Trainium5,並把 Trainium5 的生命週期進一步延長至 2030 年,同時調低 Trainium6 的放量規模。我們維持 Trainium 近期的出貨預測,因為亞馬遜在建和籌備中的資料中心項目儲備十分充足,大多未受影響。此外,Trainium 的製造成本低得多,因此終端客戶的成本也低。亞馬遜也願意出於戰略考慮,對 Anthropic 和 OpenAI 等關鍵客戶使用 Trainium 的項目給予補貼。
其他調整
我們將 TPU v9i(Whalefish)更名為 TPU v8i Max(Whalefish)。
我們將「B300 1200W」更名為「B300 1100W」,並相應更新熱設計功耗(TDP)。晶片的綜合功耗保持不變。
在 ODM 模型中,我們將微軟 2027 年的 Vera Rubin 機櫃訂單下調 200 個。
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
 相關文章