融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


Galaxy:站在加密和人工智慧交叉點的專案們
原文標題:《Understanding the Intersection of Crypto and AI》
原文作者:Lucas Tcheyan
原文編譯:律動小工,BlockBeats
< br>
目錄
介紹
核心觀點
術語解釋
人工智慧+加密貨幣全景圖
去中心化計算
概述
去中心化計算垂直領域
通用計算
二級市場
去中心化機器學習訓練
去中心化通用人工智慧
建構用於
AI 模型的去中心化運算堆疊
其他去中心化產品
展望
智慧合約與零知識機器學習(zkML)
零知識機器學習(zkML)
基礎設施與工具
協處理器
應用
展望
人工智慧代理
代理提供者< blockquote>比特幣與人工智慧代理商
展望
結論
引言
區塊鏈的出現可以說是電腦科學史上最重要的進步之一。同時人工智慧的發展將會,而且已經在我們的世界產生深遠影響。如果說區塊鏈技術提供了一種新的交易結算、資料儲存和系統設計模板,人工智慧則是運算、分析和內容生產的革命。這兩個行業的創新正在解鎖新的用例,這些用例可能會在未來幾年加速兩者的應用程式落地。本報告探討了加密貨幣和人工智慧的集成,重點關注試圖彌合兩者之間差別、利用兩者力量的新用例。具體而言,本報告研究了去中心化計算協議、零知識機器學習(zkML)基礎設施和人工智慧代理的專案。
加密貨幣為人工智慧提供了一個無需許可、無需信任、可組合的結算層。這解鎖了更多用例,例如透過去中心化計算系統使硬體更容易獲得,建立可以執行需要價值交換的複雜任務的人工智慧代理,以及開發身份和來源解決方案來對抗女巫攻擊和深偽技術( Deepfake)。人工智慧為加密貨幣帶來了許多與 Web 2 中看到的相同的好處。這包括透過大型語言模型(例如 ChatGPT 和 Copilot 的專門訓練版本)增強了使用者和開發者的使用者體驗(UX),以及顯著提高智慧合約功能和自動化的潛力。區塊鏈是人工智慧所需的透明、數據豐富的環境。但區塊鏈的運算能力也受到了限制,這是直接整合人工智慧模型的主要障礙。
加密貨幣和人工智慧的交叉點正在進行的實驗和最終採用背後的驅動力,正是推動加密貨幣許多最有前景的用例的驅動力——一個無需許可、無需信任的協調層,更好地促進價值轉移。鑑於其巨大潛力,該領域的參與者需要理解這兩種技術相交的基本方式。
核心觀點:
在不久的將來(6 個月到1 年),加密貨幣和人工智慧的整合將由人工智慧應用程式主導,這些應用程式可以提高開發者的效率、智慧合約的可審查性和安全性以及用戶的可使用性。這些整合並非特定於加密貨幣,而是增強了鏈上開發者和使用者的體驗。
正如高效能 GPU 嚴重短缺一樣,去中心化運算產品正在發展人工智慧客製化的 GPU 產品,這為其採用提供了有力支援。
使用者體驗和監管仍然是去中心化計算客戶的障礙。然而,最近 OpenAI 的發展以及美國正在進行的監管審查突顯了無需許可、抗審查、去中心化人工智慧網路的價值主張。
鏈上人工智慧整合,特別是能夠使用人工智慧模型的智慧合約,需要改進 zkML 技術和其他驗證鏈下計算的計算方法。缺乏全面的工具和開發人才以及高昂的成本是採用的障礙。
人工智慧代理非常適合加密貨幣,用戶(或代理本身)可以創建錢包以與其他服務、代理或個人進行交易。這在傳統金融通路下目前不可能實現。為了更廣泛的採用,需要與非加密產品進行額外的整合。
術語解釋:
人工智慧(Artificial Intelligence)是利用計算和機器模仿人類的推理和問題解決能力。
神經網路(Neural Networks)是一種用於 AI 模型的訓練方法。它們透過一系列演算法層處理輸入數據,不斷優化直到產生所需的輸出。神經網路由具有可修改權重的方程式組成,可以修改權重以改變輸出。它們可能需要大量的數據和計算來進行訓練,以確保其輸出準確。這是開發 AI 模型最常見的方式之一(例如,ChatGPT 使用基於 Transformer 的神經網路流程)。
訓練(Training)是神經網路和其他 AI 模型開發的過程。它需要大量的數據來訓練模型,以正確地解釋輸入並產生準確的輸出。在訓練過程中,模型方程式的權重將不斷修改,直到產生令人滿意的輸出。訓練成本可能非常昂貴。例如,ChatGPT 使用數以萬計的 GPU 來處理其資料。資源較少的團隊通常依賴像亞馬遜網路服務(Amazon Web Services)、Azure 和Google雲端服務(Google Cloud Providers)等專用運算供應商。
推理(Inference)是實際使用AI 模型獲取輸出或結果的過程(例如,使用ChatGPT 為加密貨幣和人工智慧交會撰寫論文大綱)。推理在訓練過程中和最終產品都會用到。由於計算成本的原因,即使在訓練完成後,它們的運行成本也可能很高,但計算密集度低於訓練。
零知識證明(Zero Knowledge Proofs,ZKP)允許在不透露基礎資訊的情況下驗證聲明。這在加密貨幣中有兩個主要用途:1 隱私和 2 擴充性。對於隱私,這使用戶能夠進行交易而不洩露像錢包中有多少 ETH 這樣的敏感資訊。對於擴展性,它使得可以更快地在鏈上證明鏈下計算,而無需重新執行計算。這使得區塊鏈和應用程式可以在鏈下運行計算,然後在鏈上進行驗證。
人工智慧+加密貨幣全景圖
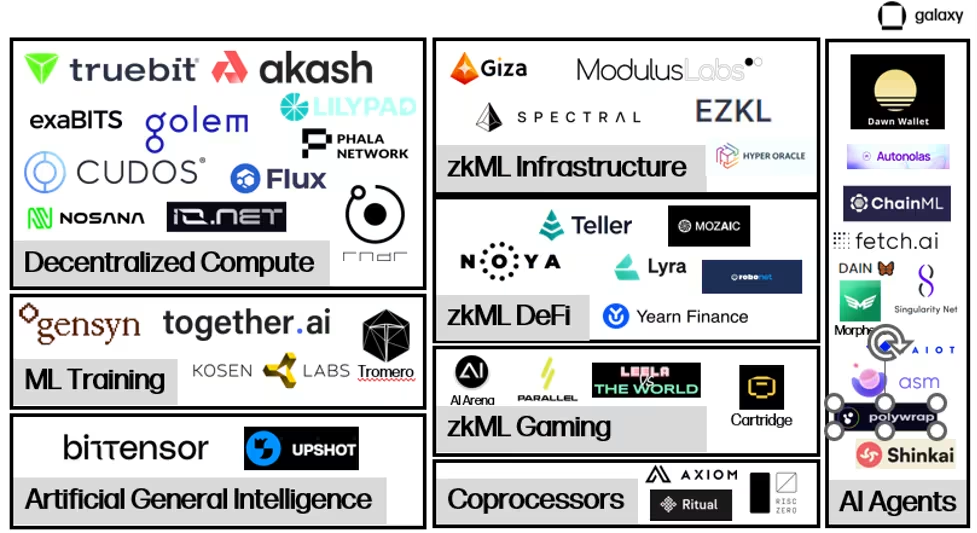 pformatity,p p>
在人工智慧和加密貨幣交匯的專案仍在建立所需的基礎設施,以支援大規模的鏈上人工智慧互動。
去中心化運算市場正在興起,以提供大量的實體硬件,主要是圖形處理單元(GPU),用於訓練和推理人工智慧模型。這些雙邊市場連接了出租和尋求租用計算資源的人,促進了價值的轉移和計算的驗證。在去中心化計算中,正在出現幾個子類別,提供了額外的功能。除了雙邊市場之外,本報告還將研究專門為可驗證訓練和微調輸出提供服務的機器學習訓練提供方,以及致力於連接計算和模型生成以實現人工通用智能的項目,也經常被稱為智能激勵網絡。
zkML 是希望以經濟有效且及時的方式在鏈上提供可驗證模型輸出項目的一個新興重點領域。這些項目主要使應用程式能夠處理鏈下繁重的計算請求,然後在鏈上發布可驗證的輸出,證明鏈下工作是完整且準確的。 zkML 在目前實例中既昂貴又耗時,但越來越多地被用作解決方案。這在 zkML 提供者和想要利用 AI 模型的 DeFi/遊戲應用程式之間的整合數量不斷增加中顯而易見。
充足的計算資源供應以及能夠在鏈上驗證計算的能力為鏈上人工智慧代理打開了大門。代理是經過訓練的模型,能夠代表使用者執行請求。代理商提供了極大的機會來顯著增強鏈上體驗,使用戶能夠透過與聊天機器人交談來執行複雜的交易。然而,就目前而言,代理程式專案仍集中於開發基礎架構和工具,以便輕鬆快速地部署。
去中心化計算
概述
< /p>
人工智慧需要大量的運算資源,無論是用於訓練模型或進行推理。在過去的十年裡,隨著模型變得越來越複雜,運算需求呈指數級增長。例如,OpenAI 發現,在 2012 年至 2018 年間,其模型的計算需求從每兩年翻倍成長到每三個半月翻倍成長。這導致了對 GPU 的需求激增,一些加密貨幣礦工甚至利用他們的 GPU 提供雲端運算服務。隨著獲取計算資源的競爭加劇和成本上漲,一些項目正在利用加密貨幣提供去中心化計算解決方案。它們以有競爭力的價格提供按需運算,以便團隊可以負擔得起訓練和運行模型。在某些情況下,這種權衡可能是效能和安全性。
像 Nvidia 生產的最先進的 GPU 等高階硬體需求很高。在 9 月份,Tether 收購了德國比特幣礦工 Northern Data 的股份,據報導支付了 4.2 億美元,以收購 1 萬個 H100 GPU(用於 AI 訓練的最先進的 GPU 之一)。獲得最佳硬體的等待時間至少為六個月,在許多情況下更長。更糟的是,公司通常需要簽訂長期合同,購買他們甚至可能不會使用的計算資源。這可能導致存在計算資源,但市場上卻不可用的情況。去中心化計算系統有助於解決這些市場效率低下的問題,創建了一個二級市場,使計算資源的所有者能夠隨時以競爭價格出租他們的多餘資源,釋放新的供應。
除了競爭性定價和易獲取性外,去中心化計算的關鍵價值是抗審查性。前沿的人工智慧發展越來越被擁有無與倫比的運算和數據獲取權限的大型科技公司所主導。 2023 年 AI 指數報告年度報告中首次突出的關鍵主題之一是,產業正在越來越超過學術界,在 AI 模型的開發方面,將控制權集中在少數科技領導者手中。這引發了對他們能否在製定支撐 AI 模型的規範和價值觀方面產生過大影響的擔憂,尤其是在這些科技公司推動監管措施以限制他們無法控制的 AI 開發之後。
去中心化計算垂直領域
近年來出現了幾種去中心化計算模型,每種模型都有自己的重點和取捨。

計算通用計算 類似Akash、io.net、iExec、Cudos 等項目是去中心化計算應用,除了數據和通用計算解決方案外,還提供或將很快提供專門用於AI 訓練和推理的特定計算資源。
Akash 目前是唯一完全開源的「超級雲端」平台。它是一個使用 Cosmos SDK 的權益證明網絡。 Akash 的原生代幣 AKT 用於保護網路、作為支付形式,並激勵參與。 Akash 於 2020 年推出了首個主網,重點是提供一個無需許可的雲端運算市場,最初提供儲存和 CPU 租賃服務。在 2023 年 6 月,Akash 推出了一個新的測試網,專注於 GPU,9 月推出了 GPU 主網,使用戶能夠租用 GPU 進行 AI 訓練和推理。
Akash 生態系中有兩個主要角色 - 租戶和提供者。租戶是 Akash 網路的用戶,他們想購買運算資源。提供者是計算資源提供者。為了匹配租戶和提供者,Akash 依賴一個逆向拍賣過程。租戶提交他們的計算需求,在其中可以指定某些條件,例如伺服器的位置或進行計算的硬體類型,以及他們願意支付的金額。然後,提供者提交他們的要價,最低出價者獲得任務。
Akash 驗證者維護網路的完整性。驗證者集目前限制為 100 個,計劃隨著時間逐步增加。任何人都可以透過抵押比目前抵押金額最少的驗證者更多的 AKT 來成為驗證者。 AKT 持有者也可以將他們的 AKT 委託給驗證者。網路的交易費用和區塊獎勵以 AKT 形式分配。此外,對於每筆租賃,Akash 網路都會以由社區確定的比率收取「手續費」,並分配給 AKT 持有者。
二級市場
去中心化計算市場旨在填補現有計算市場的低效。供應限制導致公司儲備了超出他們可能需要的運算資源,而且由於與雲端服務提供者的合約形式,供應進一步受到限制。即使可能不需要持續使用,這些客戶也被鎖定在長期合約中。去中心化運算平台釋放了新的供應,使全球任何需要的運算資源的人都可以成為提供者。

目前尚不清楚,對用於AI 訓練的的需求激增是否會轉化為Akash 網路的長期使用量。長期以來,Akash 一直為 CPU 提供了一個市場,例如,以 70-80% 的折扣提供類似於中心化替代方案的服務。然而,更低的價格並沒有導致顯著的採用。網路上的租賃活動已經趨於平緩,2023 年第二季的平均運算資源利用率僅 33%,記憶體利用率為 16%,儲存利用率為 13%。儘管這些對於鏈上採用來說是令人印象深刻的指標(作為參考,領先的儲存供應商Filecoin 在2023 年第三季的儲存利用率為12.6%),但這表明供應繼續超過對這些產品的需求。
距離 Akash 推出 GPU 網路已經過了一年多一點的時間,現在要準確衡量其長期採用率還為時過早。作為需求的標誌,迄今為止 GPU 的平均利用率為 44%,高於 CPU、記憶體和儲存。這主要是由對最高品質 GPU(如 A100s)的需求所推動的,超過 90% 的 GPU 已出租。

Akash 的每日支出也有所增加,相對於GPU出現之前幾乎翻了一番。這部分歸因於其他服務使用量的增加,尤其是 CPU,但主要是新 GPU 使用量的結果。

定價與Lambda 和 CloudVastai.對手相當(或在某些情況下甚至更貴)。對最高端 GPU(例如 H100 和 A100)的巨大需求意味著該設備的大多數所有者對在面臨競爭性定價的市場上市興趣不大。

儘管初期興趣令人欣喜,但採用早期興趣採用仍有喜(下文將進一步討論)。去中心化運算網路需要採取更多措施來創造需求和供應,團隊正在嘗試如何更好地吸引新用戶。例如,在 2024 年初,Akash 通過了提案 240,以增加 GPU 提供者的 AKT 發行量,並激勵更多的供應,具體針對高階 GPU。團隊也致力於推出概念驗證模型,向潛在用戶展示其網路的即時能力。 Akash 正在訓練他們自己的基礎模型,並已經推出了使用 Akash GPU 生成輸出的聊天機器人和圖像生成產品。類似地,io.net 已經開發了穩定的擴散模型,並正在推出新的網路功能,以更好地模擬傳統 GPU 資料中心的效能和規模。
去中心化機器學習訓練
除了可以滿足人工智慧需求的通用運算平台外,還出現了一系列專注於機器學習模型訓練的專用AI GPU 提供者。例如,Gensyn 正在「協調電力和硬體來建立集體智慧」,認為「如果有人想訓練某些東西,而有人願意訓練它,那麼應該允許進行訓練。」
該協議有四個主要角色:提交者、求解者、驗證者和舉報者。提交者向網路提交帶有訓練請求的任務。這些任務包括訓練目標、要訓練的模型和訓練資料。作為提交過程的一部分,提交者預先支付一筆費用,以支付解算者估計的計算成本。
一旦提交,任務將分配給求解者,他們將進行模型的實際訓練。然後,求解者將完成的任務提交給驗證者,驗證者負責檢查訓練是否正確完成。舉報者負責確保驗證者誠實行事。為了激勵舉報者參與網絡,Gensyn 計劃定期提供有意錯誤的證明,以獎勵舉報者抓住它們。
除了為人工智慧相關工作提供計算之外,Gensyn 的關鍵價值是其驗證系統,該系統仍在開發中。驗證是必要的,以確保 GPU 提供者進行的外部運算是正確的(即確保使用者的模型被訓練成他們想要的方式)。 Gensyn 採用獨特的方法解決了這個問題,利用稱為「機率學習證明、基於圖的定位協議和 Truebit 風格的激勵遊戲」的新型驗證方法。這是一種樂觀解決模式,使驗證者能夠確認求解者已正確運行模型,而無需完全重新運行它們,這是一個昂貴且低效的過程。
除了其創新的驗證方法外,Gensyn 還聲稱相對於中心化替代方案和加密競爭對手來說具有成本效益- 提供的ML 訓練比AWS便宜高達80%,同時在測試中勝過類似項目Truebit。


子網路根據根網路評估的表現來獲得TAO。根網路位於所有子網路的頂部,實質上充當一種特殊類型的子網,並由 64 個最大的子網路驗證者按份額管理。根網路驗證者根據子網路的表現進行排名,並定期向子網路分配 TAO。這樣,各個子網路就充當了根網路的礦工。
Bittensor 前景
Bittensor 在擴展協議功能以激勵跨多個子網路的智慧生成時,仍在經歷成長的痛苦。礦工們繼續想出新的方法來攻擊網絡,以賺取更多的 TAO 獎勵,例如通過略微修改其模型運行的高評級推理的輸出,然後提交多個變體。影響整個網路的治理提案只能由 Triumvirate 提交和實施,Triumvirate 完全由 Opentensor 基金會的利害關係人組成(值得注意的是,提案在實施之前需要 Bittensor 驗證者審批)。專案的代幣經濟學正在進行改進,以改善 TAO 在子網路中的使用誘因。該專案還因其獨特的方法而迅速獲得了知名度,最受歡迎的人工智慧網站 HuggingFace 的 CEO 表示 Bittensor 應該將其資源添加到該網站中。
在一篇最近由核心開發者發布的名為“Bittensor Paradigm”的文章中,團隊闡明了他們對Bittensor 最終演變為“不受測量物件限制(agnostic to what is being measured)」的願景。理論上,這可以使 Bittensor 開發激勵任何類型行為的子網,所有這些都由 TAO 提供支援。然而,仍然存在相當大的實際約束 - 最主要的是要證明這些網絡能夠擴展到處理如此多樣的過程,並且底層的激勵機制推動的進展超過了中心化的提供。
建構用於AI 模型的去中心化計算堆疊
上述部分提供了正在開發的各種類型的去中心化人工智慧計算協議的高緯度概述。雖然它們在發展和採用方面還處於早期階段,它們為生態系統提供了基礎,該生態系統最終可能促進創建“AI 構建塊”,就像“DeFi 樂高”概念一樣。無需許可的區塊鏈的可組合性開啟了每個協議在其他協議之上構建的可能性,從而提供了更全面的去中心化人工智慧生態系統。
例如,以下是 Akash、Gensyn 和 Bittensor 可能如何相互互動以回應推理請求的一種方式。

需要明確的是,這只是未來可能發生事情的一個範例,而不是對當前生態系統、現有合作夥伴或可能結果。今天,互通性的限制以及下文描述的其他考慮因素大大限制了整合可能性。除此之外,流動性的碎片化和使用多個代幣的需求可能對用戶體驗產生不利影響,這一點已經被 Akash 和 Bittensor 的創始人指出。
其他去中心化產物
除了計算之外,還有幾種其他去中心化基礎設施服務,以支援加密貨幣新興的人工智慧生態系統。列舉它們所有的內容超出了本報告的範圍,但其中一些有趣而具有代表性的例子包括:
Ocean:去中心化的資料市場。用戶可以創建代表其數據的數據 NFT,並使用數據代幣購買。使用者既可以將其資料貨幣化,又可以擁有更大的主權,同時為從事人工智慧開發和訓練模型的團隊提供所需的資料獲取途徑。
Grass:去中心化的頻寬市場。用戶可以將他們多餘的頻寬出售給使用它從網路上抓取資料的人工智慧公司。該市場建立在Wynd 網路上,這不僅使個人可以將其頻寬貨幣化,而且還為頻寬的購買者提供了更多樣化的視角,了解個人用戶在線上看到的內容(因為個人使用網路存取通常是針對其特定的IP 位址)。
HiveMapper:建立一個去中心化的地圖產品,其中包含從汽車駕駛員收集的資訊。 HiveMapper 依賴人工智慧來解釋用戶汽車儀表板攝影機收集的圖像,並透過強化人類學習回饋(RHLF)獎勵用戶來幫助完善人工智慧模型。
總的來說,這些都指向了探索支持人工智慧模型的去中心化市場模型,或者支持開發這些模型所需的周邊基礎設施的近乎無盡的機會。目前,這些項目大多處於概念驗證階段,需要進行更多的研究和開發,以證明它們能夠以所需的規模提供全面的人工智慧服務。
展望
去中心化運算產品仍處於開發的早期階段。他們剛開始使用最先進的運算能力,能夠訓練生產中最強大的人工智慧模型。為了獲得有意義的市場份額,他們需要展示與中心化替代品相比的實際優勢。更廣泛採用的潛在誘因包括:
GPU 供需情況。 GPU 供應短缺,加上快速成長的運算需求,導致了一場 GPU 競賽。由於 GPU 約束,OpenAI 已經限制了對其平台的使用。像 Akash 和 Gensyn 這樣的平台可以為需要高效能運算的團隊提供成本競爭力的替代方案。未來 6-12 個月是去中心化運算提供者吸引新用戶的特殊機會,因為這些用戶被迫考慮去中心化方案。加上越來越有效率的開源模型(如 Meta 的 LLaMA 2),使用者在部署有效的微調模型時不再面臨同樣的障礙,這讓運算資源成為主要瓶頸。然而,平臺本身的存在並不能確保運算資源的充足供應和消費者的對應需求。要獲得高端 GPU 仍然困難,而成本並不總是需求方的主要動機。這些平台將面臨挑戰,要證明使用去中心化運算的實際好處 - 無論是因為成本、抗審查性、持續時間和彈性還是可使用性 - 以累積黏性使用者。那麼這些協議就不得不行動迅速。 GPU 基礎設施的投資和建設速度非常驚人。
監理。監管繼續是去中心化計算運動的一大障礙。在短期內,缺乏明確的監管意味著提供者和使用者使用這些服務面臨潛在的風險。如果提供方無意中提供計算或買家從受制裁的實體購買計算,會怎麼樣?使用者可能不願意使用缺乏中心化實體控制和監督的去中心化平台。協議已經試圖透過將控制納入其平台或僅提供已知計算提供方的篩選器(即提供 KYC 資訊)來緩解這些擔憂,但需要更強大的方法來保護隱私同時確保合規,以促進採用。短期內,我們可能會看到出現 KYC 和符合監管的平台,限制對其協議的使用以解決這些問題。
審查。監管是雙向的,去中心化計算提供者可能受益於限制對人工智慧的使用所採取的行動。除了行政命令外,OpenAI 創始人 Sam Altman 曾在國會作證,強調了頒發人工智慧開發許可證的監管機構的必要性。圍繞人工智慧監管的討論剛剛開始,但任何試圖限制對人工智慧的使用或審查人工智慧的嘗試可能會加速採用沒有這些障礙的去中心化平台。去年 11 月 OpenAI 的領導層變動進一步證明了將決策權授予僅有少數人的最強大的現有人工智慧模型存在的風險。此外,所有人工智慧模型都必然反映了其創建者的偏見,無論是有意還是無意。消除這些偏見的一種方法是盡可能地使模型對微調和訓練開放,確保任何人都可以隨時隨地使用各種偏見的模型。
資料隱私。當與為用戶提供資料自主權的外部資料和隱私解決方案整合時,去中心化計算可能會比替代方案更具吸引力。三星公司就曾遭受此類問題,他們意識到工程師正在使用 ChatGPT 來幫助晶片設計,並洩露了敏感資訊給 ChatGPT。 Phala Network 和 iExec 聲稱為用戶提供了 SGX 安全隔離區,以保護用戶數據,並且正在進行完全同態加密的研究,進一步解鎖確保隱私的去中心化計算。隨著人工智慧進一步融入我們的生活,用戶將更加重視能夠在具有隱私保護功能的應用程式上運行模型。使用者還將需求能夠實現資料的可組合性,以便能夠無縫地將其資料從一個模型轉移到另一個模型。
使用者體驗(UX)。使用者體驗仍然是所有類型的加密應用和基礎設施更廣泛採用的重要障礙。去中心化計算方案也不例外,在某些情況下,由於開發者需要理解加密和人工智慧,情況更加嚴重。需要進行改進的面向包括從入門和與區塊鏈互動的抽像到提供與當前市場領導者相同的高品質輸出。這是顯而易見的,因為許多運行中的去中心化計算協議提供更便宜的方案,但難以獲得常規使用。
智能合約與零知識機器學習(zkML)
智能合約是任何區塊鏈生態系的核心建構模組。在特定條件下,它們會自動執行並減少或消除對可信任第三方的需求,從而實現了像 DeFi 中所見的複雜去中心化應用程式的創建。然而,就目前而言,智能合約在功能上仍然存在局限性,因為它們基於預設參數執行,這些參數必須進行更新。
例如,一個借貸協議智能合約根據一定的貸款價值比例規範了何時清算頭寸。在一個風險不斷變化的動態環境中,這些智能合約必須不斷更新以考慮風險容忍度的變化,這為透過去中心化流程進行管理的合約帶來了挑戰。例如,依賴去中心化治理流程的 DAO 可能無法及時對系統性風險做出反應。
整合人工智慧(如機器學習模型)的智慧合約是增強功能、安全性和效率的一種可能的方式,同時改善整體使用者體驗。然而,這些整合也引入了額外的風險,因為無法確保支援這些智能合約的模型不會被攻擊或考慮到長尾情況(眾所周知,由於缺乏資料輸入,很難對模型進行訓練)。
零知識機器學習(zkML)
機器學習需要大量運算資源來運作複雜模型,這使得AI 模型無法在智慧合約內部直接運行,因為高昂的成本。例如,一個 DeFi 協議為用戶提供了收益優化模型的功能,但如果試圖在鏈上運行模型,就必須支付高昂的 Gas 費用。一種解決方案是增加底層區塊鏈的運算能力。然而,這也會增加鏈的驗證節點的負擔,可能會削弱其去中心化屬性。因此,一些專案正在探索使用 zkML 來以無需密集的鏈上運算就能以無許信任的方式驗證輸出的方法。
說明zkML 有用性的一個常見範例是,當使用者需要其他人透過模型運行數據,並驗證其交易對手是否實際運行了正確的模型時。也許開發者正在使用去中心化計算提供者來訓練他們的模型,擔心提供者正在嘗試透過使用成本較低的模型來節省成本,但輸出幾乎無法察覺。 zkML 使得計算提供者可以運行資料通過他們的模型,然後產生一個證明,可以在鏈上驗證模型對給定輸入的輸出是正確的。在這種情況下,模型提供者將有額外的優勢,即能夠提供他們的模型,而無需透露產生輸出的底層權重。
相反的情況也可以發生。如果使用者想要運行一個模型,使用他們的數據,但又不想讓提供模型的項目獲取他們的數據,因為存在隱私問題(例如醫學檢查或專有業務資訊),那麼用戶可以在他們的數據上運行模型而不共享它,並驗證他們是否運行了正確的模型,同時提供證據。這些可能性大大擴展了透過解決限制性運算限制來整合人工智慧和智慧合約功能的設計空間。
基礎設施與工具
鑑於zkML 領域的早期狀態,開發主要集中在構建團隊將其模型和輸出轉換為可在鏈上驗證的證明所需的基礎設施和工具上。這些產品盡可能地抽象化了開發中的零知識面向。
EZKL 和 Giza 是兩個項目,透過提供機器學習模型執行的可驗證證明,來建構這些工具。兩者都幫助團隊建立機器學習模型,以確保這些模型可以以一種無需信任地在鏈上驗證結果的方式執行。這兩個專案都使用開放式神經網路交換(ONNX)將以通用語言如 TensorFlow 和 Pytorch 編寫的機器學習模型轉換為標準格式。然後,在執行時它們輸出這些模型的版本,也產生 zk-proofs。 EZKL 是開源的,產生 zk-SNARKS,而 Giza 是閉源的,產生 zk-STARKS。這兩個項目目前僅與 EVM 相容。
在過去幾個月中,EZKL 在增強其zkML 解決方案方面取得了顯著進展,主要集中在降低成本、提高安全性和加速證明生成方面。例如,在2023 年11 月,EZKL 整合了一個新的開源GPU 庫,將整體證明時間減少了35%,並且在1 月份,EZKL 宣布了Lilith,這是一個軟體解決方案,用於使用EZKL 證明系統時整合高效能運算集群並協調並發作業。 Giza 獨特之處在於,除了提供創建可驗證機器學習模型的工具之外,他們還計劃實現Hugging Face 的web3 等效版本,為zkML 協作和模型共享開設一個用戶市場,並最終集成去中心化的計算產品。在 1 月份,EZKL 發布了一個基準評估,比較了 EZKL、Giza 和 RiscZero(下文討論)的表現。 EZKL 表現出更快的證明時間和記憶體使用率。

的論文,對當時的現有zk-proof 系統進行了基準測試,以識別改進AI 模型zk -proofs 的能力和瓶頸。該論文發表於 2023 年 1 月,顯示現有的解決方案成本和效率都太高,無法實現大規模的 AI 應用。基於他們的初步研究,Modulus 在11 月推出了Remainder,這是一個專門為降低AI 模型成本和證明時間而構建的專業零知識證明器,旨在使項目能夠經濟上可行地大規模集成模型到他們的智能合約中。他們的工作是閉源的,因此無法與上述解決方案進行基準測試,但最近在 Vitalik 的有關加密和人工智慧的部落格文章中提到了它們。 </p><p><br></p><p>工具和基礎設施的開發對zkML 領域的未來成長至關重要,因為它極大地減少了團隊部署zk 電路以進行可驗證的鏈下計算所需的摩擦力。創建安全接口,使非加密原生開發者在機器學習領域工作時能夠將他們的模型帶到鏈上,將使具有真正新穎用例的應用程式的實驗增加。工具還解決了更廣泛的 zkML 採用的一個主要障礙,即缺乏在零知識、機器學習和密碼學交叉領域有知識和興趣的開發者。 </p><p><br></p><h2>協處理器</h2><p><br></p><p>正在開發的其他解決方案,稱為「協處理器」,包括RiscZero、Axiom 和Ritual。術語「協處理器」在大多數情況下是語義上的 - 這些網路承擔許多不同的角色,包括在鏈上驗證鏈下計算。與 EZKL、Giza 和 Modulus 一樣,它們的目標是完全抽象化零知識證明產生過程,從而創建基本上是能夠在鏈下執行程序並為鏈上驗證生成證明的零知識虛擬機。 RiscZero 和 Axiom 可以處理簡單的 AI 模型,因為它們是更通用的協處理器,而 Ritual 則專為與 AI 模型配合使用而構建。 </p><p><br></p><p>Infernet 是Ritual 的第一個實例,並包含一個Infernet SDK,允許開發者向網路提交推理請求,並在返回時收到輸出和證明(可選)。 Infernet 節點接收這些請求,並在鏈下處理計算,然後傳回輸出。例如,一個 DAO 可以創建一個流程,以確保所有新的治理提案在提交之前滿足某些先決條件。每次提交新提案時,治理合約都會透過 Infernet 觸發推理請求,呼叫一個特定於 DAO 的治理訓練過的 AI 模型。該模型審查提案,以確保提交了所有必要的條件,並返回輸出和證明,要么批准,要么否決提案的提交。 </p><p><br></p><p>在未來一年內,Ritual 團隊計畫推出構成基礎設施層的附加功能,稱為 Ritual Superchain。之前討論過的許多項目都可以作為服務提供者插入到 Ritual 中。目前,Ritual 團隊已經與 EZKL 整合進行了證明生成,並可能很快就會添加來自其他領先提供者的功能。 Ritual 上的 Infernet 節點也可以使用 Akash 或 io.net GPU,並查詢在 Bittensor 子網路上訓練的模型。他們的最終目標是成為開放 AI 基礎設施的首選提供方,能夠為任何網路上的任何工作負載提供機器學習和其他與 AI 相關的任務服務。 </p><p><br></p><h2>應用</h2><p><br></p><p>zkML 有助於調和區塊鏈和人工智慧之間的矛盾,前者天生資源受限,後者需要大量的計算和數據。正如Giza 的一位創始人所說:「用例是如此豐富...這有點像在以太坊早期問智能合約有哪些用例一樣...我們正在擴展智能合約的用例。」然而,正如上文所強調的,當今的發展主要集中在工具和基礎設施層面。應用程式仍處於探索階段,團隊面臨的挑戰是證明使用 zkML 實現模型帶來的價值超過了這樣做的複雜性和成本。 </p><p><br></p><p>今天的一些應用包括:</p><p><br></p><p>DeFi。 zkML 透過增強智能合約的功能,拓展了 DeFi。 DeFi 協議為機器學習模型提供了大量可驗證且不變的數據,可用於產生產生效益或交易策略、風險分析、UX 等。例如,Giza 與 Yearn Finance 合作,為 Yearn 的新 v3 保險庫建立了一個概念驗證的自動風險評估引擎。 Modulus Labs 與 Lyra Finance 合作,將機器學習納入其 AMMs,與 Ion Protocol 合作驗證者風險模型,並協助 Upshot 驗證其基於 AI 的 NFT 價格資料來源。像 NOYA(利用 EZKL)和 Mozaic 這樣的協定提供了專有鏈下模型的使用,使用戶能夠使用自動 APY 機槍池,同時能夠在鏈上驗證資料輸入和證明。 Spectral Finance 正在建立鏈上信用評分引擎,預測 Compound 或 Aave 借款人違約的可能性。這些所謂的「De-Ai-Fi」產品有望在未來幾年變得更加普遍,這要歸功於 zkML。 </p><p><br></p><p>遊戲。人們一直認為區塊鏈顛覆和增強遊戲的時機已經成熟。 zkML 使得在鏈上使用人工智慧進行遊戲成為可能。 Modulus Labs 已經為簡單的鏈上遊戲實現了概念驗證。 《Leela vs the World》是一個博弈論象棋遊戲,用戶與 AI 象棋模型對決,zkML 驗證 Leela 的每一步都是基於遊戲所說的模型在運行。類似地,團隊們使用 EZKL 框架建立了簡單的唱歌比賽和鏈上井字棋。 Cartridge 正在使用 Giza 使團隊能夠部署完全在鏈上的遊戲,最近力推了、一個簡單的 AI 駕駛遊戲,用戶競爭創建更好的模型,使汽車避開障礙物。雖然簡單,但這些概念驗證指向了未來的落地,即實現更複雜的鏈上驗證,例如與AI Arena 中的高級NPC 角色交互的遊戲經濟相互作用,AI Arena 是一款類似於超級瑪利歐的遊戲,玩家訓練自己的戰士,然後部署為AI 模型進行戰鬥。 </p><p><br></p><p>身分、溯源和隱私。加密已經被用作驗證真實性的手段,並對越來越多的 AI 生成/操縱的內容和深偽進行打擊。 zkML 可以推進這些努力。 WorldCoin 是一個人格證明的解決方案,需要使用者掃描他們的虹膜產生唯一 ID。未來,生物識別 ID 可以透過使用加密儲存在個人裝置上自我保管,所需的模型用於本地驗證這些生物識別資訊。用戶可以提供他們的生物識別資訊的證明,而無需透露自己的身份,從而抵禦女巫攻擊,同時確保隱私。這也可以應用於其他需要隱私的推斷,例如使用模型分析醫學數據/圖像以檢測疾病、驗證個體身份並在約會應用程式中開發匹配演算法,或用於需要驗證財務資訊的保險和貸款機構。 </p><p><br></p><h2>展望</h2><p><br></p><p>zkML 仍處於實驗階段,大多數專案都專注於建立基礎設施原型和概念驗證。目前面臨的挑戰包括運算成本、記憶體限制、模型複雜性、有限的工具和基礎設施,以及開發人才。簡而言之,在 zkML 可以實現消費產品所需的規模之前,還有大量工作要做。 </p><p><br></p><p>然而,隨著領域的成熟和這些限制的解決,zkML 將成為人工智慧和加密整合的關鍵組成部分。在其核心,zkML 承諾能夠將任何規模的鏈下計算帶到鏈上,同時保持與在鏈上運行計算相同或接近相同的安全保障。然而,在實現這一願景之前,該技術的早期用戶將繼續不得不在 zkML 的隱私和安全性與替代方案的效率之間進行權衡。 </p><p><br></p><h1>人工智慧代理</h1><p><br></p><p>人工智慧和加密貨幣最令人興奮的整合之一是正在進行的人工智慧代理實驗。代理是能夠接收、解釋和執行任務的自治機器人,使用的是 AI 模型。代理可以是任何東西,從擁有一個始終可用、根據您的偏好進行優化的個人助手,到僱用一個財務代理,根據用戶的風險偏好管理,並調整投資組合。 </p><p><br></p><p>代理程式和加密很好地結合在一起,因為加密提供了無需許可和無需信任的支付基礎設施。一旦訓練完成,代理商可以擁有一個錢包,以便它們可以自行與智能合約進行交易。例如,如今簡單的代理可以在互聯網上搜索信息,然後根據一個模型在預測市場上進行交易。 </p><p><br></p><h2>代理商提供者</h2><p><br></p><p>Morpheus 是2024 年在以太坊和Arbitrum 上推出的最新的開源代理專案之一。其白皮書於 2023 年 9 月匿名發布,為一個社區形成和建立提供了基礎(包括像 Erik Vorhees 這樣的知名人物)。白皮書包括可下載的智慧代理協議,這是一個開源的 LLM,可以在本地運行,由用戶的錢包管理,並與智能合約進行互動。它使用智能合約排名來幫助代理商確定基於諸如處理的交易數量等標準與哪些智能合約進行互動是安全的。 </p><p><br></p><p>白皮書也提供了建構 Morpheus 網路的框架,例如實施智慧代理協定所需的激勵結構和基礎設施。這包括激勵貢獻者為與代理互動的前端建立介面,為開發者建立可以插入代理以便它們彼此交互的應用程式的API,以及為用戶提供雲端解決方案,以便他們可以使用在邊緣設備上運行代理所需的計算和儲存。該項目的初始資金於 24 年 2 季初啟動,完整的協議預計將在那時推出。 </p><p><br></p><p>去中心化自治基礎設施網路 (DAIN) 是一種新的代理基礎設施協議,在 Solana 上建立代理到代理經濟。 DAIN 的目標是讓來自不同企業的代理可以透過通用 API 無縫地相互交互,從而大大開放 AI 代理的設計空間,重點是實現能夠與 web2 和 web3 產品交互的代理。一月份,DAIN 宣布與 Asset Shield 首次合作,使用戶能夠將「代理簽署者」添加到其多重簽名中,這些簽署者能夠根據用戶設定的規則解釋交易並批准/拒絕。 </p><p><br></p><p>Fetch.AI 是最早部署的人工智慧代理協議之一,已經開發了一個生態系統,用於在鏈上使用其FET 代幣和Fetch .AI 錢包建置、部署和使用代理程式。該協議提供了一套全面的工具和應用程序,用於使用代理,包括與代理進行互動和下達命令的錢包內功能。 </p><p><br></p><p>Autonolas 的創辦人包括來自 Fetch 團隊的前成員,他們是一個用於創建和使用去中心化的人工智慧代理的開放市場。 Autonolas 還為開發者提供一套工具,用於建立鏈下託管的人工智慧代理,並能夠連接到包括 Polygon、以太坊、Gnosis Chain 和 Solana 在內的多個區塊鏈。他們目前有一些活躍的代理概念驗證產品,包括用於預測市場和 DAO 治理的產品。 </p><p><br></p><p>SingularityNet 正在建立一個用於AI 代理的去中心化市場,人們可以在那裡部署專注於特定領域的AI 代理,這些代理可以被其他人或代理僱傭來執行複雜的任務。其他項目,如 AlteredStateMachine,正在建立與 NFTs 的 AI 代理整合。使用者鑄造具有隨機屬性的 NFTs,這些屬性使它們對不同任務具有優勢和劣勢。然後,這些代理可以被訓練來增強某些屬性,用於遊戲、DeFi 或作為虛擬助手,並與其他用戶進行交易。 </p><p><br></p><p>總的來說,這些項目設想了一個代理的未來生態系統,這些代理能夠共同工作,不僅執行任務,還能幫助構建人工通用智能。真正複雜的代理將能夠自主地執行任何使用者任務。例如,不需要確保代理程式已經整合了外部 API(如旅行預訂網站)就可以使用它,完全自主的代理將有能力找出如何僱用另一個代理來整合 API,然後執行任務。從使用者的角度來看,沒有必要檢查代理是否能夠執行任務,因為代理可以自行確定。 </p><p><br></p><h2>比特幣和人工智慧代理</h2><p><br></p><p>2023 年7 月,閃電實驗室推出了在閃電網路上使用代理的概念驗證方案,稱為LangChain 比特幣套件。這個產品尤其有趣,因為它旨在解決 Web 2 世界中一個日益嚴重的問題——網路應用程式的門禁(限制獲取)和昂貴的 API 服務。 </p><p><br></p><p>LangChain 透過為開發者提供一套工具,使代理商能夠購買、出售和持有比特幣,以及查詢API 密鑰並發送微型支付來解決這個問題。在傳統的支付管道上,由於費用問題,小額微支付基本上不可行,而在閃電網路上,代理商可以每天發送無限的微支付,並且只需支付極少的費用。當與 LangChain 的 L402 支付計量 API 框架結合使用時,這可以使公司根據使用量的增加和減少來調整對其 API 的使用費用,而不是設定單一的成本禁止標準。 </p><p><br></p><p>在未來,鏈上活動主要由代理與代理交互所主導,上文提到的事情將是必要的,以確保代理能夠以不成本過高的方式相互互動。這是一個早期的例子,說明如何在無需許可且經濟高效的支付軌道上使用代理,為新市場和經濟互動開闢了可能性。 </p><p><br></p><h2>展望</h2><p><br></p><p>代理領域仍處於初期階段。 </p><p><br></p><p>專案剛開始推出功能代理,可以使用其基礎設施處理簡單的任務—這通常只有經驗豐富的開發者和使用者才能使用。 </p><p><br></p><p>然而,隨著時間的推移,人工智慧代理將對加密領域產生的最大影響之一是改善所有垂直領域的使用者體驗。交易將開始從基於點擊轉向基於文本,用戶將能夠透過大語言模型(LLMs)與鏈上代理進行互動。已經有像 Dawn Wallet 這樣的團隊推出了用於用戶在鏈上進行互動的聊天機器人錢包。 </p><p><br></p><p>此外,尚不清楚代理程式在Web 2.0 中如何運作,因為金融軌道依賴受監管的銀行機構,這些機構不能24/7 運作且無法進行無縫跨境交易。正如 Lyn Alden 所強調的那樣,因為缺乏退款和處理小額交易的能力,與信用卡相比,加密管道尤其吸引人。然而,如果代理商變得更普遍,現有的支付提供者和應用程式可能會迅速採取行動,實現所需的基礎設施,使其能夠在現有的金融管道上運作,從而減輕使用加密的一些好處。 </p><p><br></p><p>目前,代理可能僅限於確定性的加密貨幣交易,其中給定輸入保證給定輸出。如何利用這些代理人的能力來執行複雜任務的模型,以及擴展其可以完成的任務範圍的工具,都需要進一步的發展。要使加密代理在新穎的鏈上加密用例之外變得有用,需要更廣泛地整合和接受加密作為支付形式以及法規的明確。然而,隨著這些組件的發展,代理將成為上文討論的去中心化計算和 zkML 解決方案中最大的消費者之一,以自主的非確定性方式接收和解決任何任務。 </p><p><br></p><h1>結論</h1><p><br></p><p>人工智慧為加密領域引入了與我們已經在Web2 中看到的相同的創新,增強了從基礎設施開發到用戶體驗和可使用性的各個方面。然而,專案仍處於早期階段,在短期內,加密和人工智慧的整合將主要由鏈下整合主導。 </p><p><br></p><p>像Copilot 這樣的產品將「使開發效率提升10 倍」,與微軟等主要公司合作,Layer 1 們和DeFi 應用程式已經在推出AI輔助開發平台。像 Cub3.ai 和 Test Machine 這樣的公司正在開發用於智慧合約審計和即時威脅監控的人工智慧,以增強鏈上安全性。而 LLM 聊天機器人正在使用鏈上資料、協議文件和應用程式進行訓練,以提供用戶增強的可使用性和用戶體驗。 </p><p><br></p><p>對於更高階的整合,真正充分利用加密的基礎技術,挑戰在於證明在鏈上實現人工智慧解決方案在技術上是可行的,且在規模上是經濟可行的。去中心化運算、zkML 和人工智慧代理的發展都指向了有前景的垂直領域,為一個將加密和人工智慧深度交織在一起的未來奠定了基礎。 </p><p><br></p><blockquote><a href=) 原文連結
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
類似Akash、io.net、iExec、Cudos 等項目是去中心化計算應用,除了數據和通用計算解決方案外,還提供或將很快提供專門用於AI 訓練和推理的特定計算資源。
Akash 目前是唯一完全開源的「超級雲端」平台。它是一個使用 Cosmos SDK 的權益證明網絡。 Akash 的原生代幣 AKT 用於保護網路、作為支付形式,並激勵參與。 Akash 於 2020 年推出了首個主網,重點是提供一個無需許可的雲端運算市場,最初提供儲存和 CPU 租賃服務。在 2023 年 6 月,Akash 推出了一個新的測試網,專注於 GPU,9 月推出了 GPU 主網,使用戶能夠租用 GPU 進行 AI 訓練和推理。
Akash 生態系中有兩個主要角色 - 租戶和提供者。租戶是 Akash 網路的用戶,他們想購買運算資源。提供者是計算資源提供者。為了匹配租戶和提供者,Akash 依賴一個逆向拍賣過程。租戶提交他們的計算需求,在其中可以指定某些條件,例如伺服器的位置或進行計算的硬體類型,以及他們願意支付的金額。然後,提供者提交他們的要價,最低出價者獲得任務。
Akash 驗證者維護網路的完整性。驗證者集目前限制為 100 個,計劃隨著時間逐步增加。任何人都可以透過抵押比目前抵押金額最少的驗證者更多的 AKT 來成為驗證者。 AKT 持有者也可以將他們的 AKT 委託給驗證者。網路的交易費用和區塊獎勵以 AKT 形式分配。此外,對於每筆租賃,Akash 網路都會以由社區確定的比率收取「手續費」,並分配給 AKT 持有者。
二級市場
去中心化計算市場旨在填補現有計算市場的低效。供應限制導致公司儲備了超出他們可能需要的運算資源,而且由於與雲端服務提供者的合約形式,供應進一步受到限制。即使可能不需要持續使用,這些客戶也被鎖定在長期合約中。去中心化運算平台釋放了新的供應,使全球任何需要的運算資源的人都可以成為提供者。
目前尚不清楚,對用於AI 訓練的的需求激增是否會轉化為Akash 網路的長期使用量。長期以來,Akash 一直為 CPU 提供了一個市場,例如,以 70-80% 的折扣提供類似於中心化替代方案的服務。然而,更低的價格並沒有導致顯著的採用。網路上的租賃活動已經趨於平緩,2023 年第二季的平均運算資源利用率僅 33%,記憶體利用率為 16%,儲存利用率為 13%。儘管這些對於鏈上採用來說是令人印象深刻的指標(作為參考,領先的儲存供應商Filecoin 在2023 年第三季的儲存利用率為12.6%),但這表明供應繼續超過對這些產品的需求。
距離 Akash 推出 GPU 網路已經過了一年多一點的時間,現在要準確衡量其長期採用率還為時過早。作為需求的標誌,迄今為止 GPU 的平均利用率為 44%,高於 CPU、記憶體和儲存。這主要是由對最高品質 GPU(如 A100s)的需求所推動的,超過 90% 的 GPU 已出租。
Akash 的每日支出也有所增加,相對於GPU出現之前幾乎翻了一番。這部分歸因於其他服務使用量的增加,尤其是 CPU,但主要是新 GPU 使用量的結果。
定價與Lambda 和 CloudVastai.對手相當(或在某些情況下甚至更貴)。對最高端 GPU(例如 H100 和 A100)的巨大需求意味著該設備的大多數所有者對在面臨競爭性定價的市場上市興趣不大。
儘管初期興趣令人欣喜,但採用早期興趣採用仍有喜(下文將進一步討論)。去中心化運算網路需要採取更多措施來創造需求和供應,團隊正在嘗試如何更好地吸引新用戶。例如,在 2024 年初,Akash 通過了提案 240,以增加 GPU 提供者的 AKT 發行量,並激勵更多的供應,具體針對高階 GPU。團隊也致力於推出概念驗證模型,向潛在用戶展示其網路的即時能力。 Akash 正在訓練他們自己的基礎模型,並已經推出了使用 Akash GPU 生成輸出的聊天機器人和圖像生成產品。類似地,io.net 已經開發了穩定的擴散模型,並正在推出新的網路功能,以更好地模擬傳統 GPU 資料中心的效能和規模。
去中心化機器學習訓練
除了可以滿足人工智慧需求的通用運算平台外,還出現了一系列專注於機器學習模型訓練的專用AI GPU 提供者。例如,Gensyn 正在「協調電力和硬體來建立集體智慧」,認為「如果有人想訓練某些東西,而有人願意訓練它,那麼應該允許進行訓練。」
該協議有四個主要角色:提交者、求解者、驗證者和舉報者。提交者向網路提交帶有訓練請求的任務。這些任務包括訓練目標、要訓練的模型和訓練資料。作為提交過程的一部分,提交者預先支付一筆費用,以支付解算者估計的計算成本。
一旦提交,任務將分配給求解者,他們將進行模型的實際訓練。然後,求解者將完成的任務提交給驗證者,驗證者負責檢查訓練是否正確完成。舉報者負責確保驗證者誠實行事。為了激勵舉報者參與網絡,Gensyn 計劃定期提供有意錯誤的證明,以獎勵舉報者抓住它們。
除了為人工智慧相關工作提供計算之外,Gensyn 的關鍵價值是其驗證系統,該系統仍在開發中。驗證是必要的,以確保 GPU 提供者進行的外部運算是正確的(即確保使用者的模型被訓練成他們想要的方式)。 Gensyn 採用獨特的方法解決了這個問題,利用稱為「機率學習證明、基於圖的定位協議和 Truebit 風格的激勵遊戲」的新型驗證方法。這是一種樂觀解決模式,使驗證者能夠確認求解者已正確運行模型,而無需完全重新運行它們,這是一個昂貴且低效的過程。
除了其創新的驗證方法外,Gensyn 還聲稱相對於中心化替代方案和加密競爭對手來說具有成本效益- 提供的ML 訓練比AWS便宜高達80%,同時在測試中勝過類似項目Truebit。
子網路根據根網路評估的表現來獲得TAO。根網路位於所有子網路的頂部,實質上充當一種特殊類型的子網,並由 64 個最大的子網路驗證者按份額管理。根網路驗證者根據子網路的表現進行排名,並定期向子網路分配 TAO。這樣,各個子網路就充當了根網路的礦工。
Bittensor 前景
Bittensor 在擴展協議功能以激勵跨多個子網路的智慧生成時,仍在經歷成長的痛苦。礦工們繼續想出新的方法來攻擊網絡,以賺取更多的 TAO 獎勵,例如通過略微修改其模型運行的高評級推理的輸出,然後提交多個變體。影響整個網路的治理提案只能由 Triumvirate 提交和實施,Triumvirate 完全由 Opentensor 基金會的利害關係人組成(值得注意的是,提案在實施之前需要 Bittensor 驗證者審批)。專案的代幣經濟學正在進行改進,以改善 TAO 在子網路中的使用誘因。該專案還因其獨特的方法而迅速獲得了知名度,最受歡迎的人工智慧網站 HuggingFace 的 CEO 表示 Bittensor 應該將其資源添加到該網站中。
在一篇最近由核心開發者發布的名為“Bittensor Paradigm”的文章中,團隊闡明了他們對Bittensor 最終演變為“不受測量物件限制(agnostic to what is being measured)」的願景。理論上,這可以使 Bittensor 開發激勵任何類型行為的子網,所有這些都由 TAO 提供支援。然而,仍然存在相當大的實際約束 - 最主要的是要證明這些網絡能夠擴展到處理如此多樣的過程,並且底層的激勵機制推動的進展超過了中心化的提供。
建構用於AI 模型的去中心化計算堆疊
上述部分提供了正在開發的各種類型的去中心化人工智慧計算協議的高緯度概述。雖然它們在發展和採用方面還處於早期階段,它們為生態系統提供了基礎,該生態系統最終可能促進創建“AI 構建塊”,就像“DeFi 樂高”概念一樣。無需許可的區塊鏈的可組合性開啟了每個協議在其他協議之上構建的可能性,從而提供了更全面的去中心化人工智慧生態系統。
例如,以下是 Akash、Gensyn 和 Bittensor 可能如何相互互動以回應推理請求的一種方式。
需要明確的是,這只是未來可能發生事情的一個範例,而不是對當前生態系統、現有合作夥伴或可能結果。今天,互通性的限制以及下文描述的其他考慮因素大大限制了整合可能性。除此之外,流動性的碎片化和使用多個代幣的需求可能對用戶體驗產生不利影響,這一點已經被 Akash 和 Bittensor 的創始人指出。
其他去中心化產物
除了計算之外,還有幾種其他去中心化基礎設施服務,以支援加密貨幣新興的人工智慧生態系統。列舉它們所有的內容超出了本報告的範圍,但其中一些有趣而具有代表性的例子包括:
Ocean:去中心化的資料市場。用戶可以創建代表其數據的數據 NFT,並使用數據代幣購買。使用者既可以將其資料貨幣化,又可以擁有更大的主權,同時為從事人工智慧開發和訓練模型的團隊提供所需的資料獲取途徑。
Grass:去中心化的頻寬市場。用戶可以將他們多餘的頻寬出售給使用它從網路上抓取資料的人工智慧公司。該市場建立在Wynd 網路上,這不僅使個人可以將其頻寬貨幣化,而且還為頻寬的購買者提供了更多樣化的視角,了解個人用戶在線上看到的內容(因為個人使用網路存取通常是針對其特定的IP 位址)。
HiveMapper:建立一個去中心化的地圖產品,其中包含從汽車駕駛員收集的資訊。 HiveMapper 依賴人工智慧來解釋用戶汽車儀表板攝影機收集的圖像,並透過強化人類學習回饋(RHLF)獎勵用戶來幫助完善人工智慧模型。
總的來說,這些都指向了探索支持人工智慧模型的去中心化市場模型,或者支持開發這些模型所需的周邊基礎設施的近乎無盡的機會。目前,這些項目大多處於概念驗證階段,需要進行更多的研究和開發,以證明它們能夠以所需的規模提供全面的人工智慧服務。
展望
去中心化運算產品仍處於開發的早期階段。他們剛開始使用最先進的運算能力,能夠訓練生產中最強大的人工智慧模型。為了獲得有意義的市場份額,他們需要展示與中心化替代品相比的實際優勢。更廣泛採用的潛在誘因包括:
GPU 供需情況。 GPU 供應短缺,加上快速成長的運算需求,導致了一場 GPU 競賽。由於 GPU 約束,OpenAI 已經限制了對其平台的使用。像 Akash 和 Gensyn 這樣的平台可以為需要高效能運算的團隊提供成本競爭力的替代方案。未來 6-12 個月是去中心化運算提供者吸引新用戶的特殊機會,因為這些用戶被迫考慮去中心化方案。加上越來越有效率的開源模型(如 Meta 的 LLaMA 2),使用者在部署有效的微調模型時不再面臨同樣的障礙,這讓運算資源成為主要瓶頸。然而,平臺本身的存在並不能確保運算資源的充足供應和消費者的對應需求。要獲得高端 GPU 仍然困難,而成本並不總是需求方的主要動機。這些平台將面臨挑戰,要證明使用去中心化運算的實際好處 - 無論是因為成本、抗審查性、持續時間和彈性還是可使用性 - 以累積黏性使用者。那麼這些協議就不得不行動迅速。 GPU 基礎設施的投資和建設速度非常驚人。
監理。監管繼續是去中心化計算運動的一大障礙。在短期內,缺乏明確的監管意味著提供者和使用者使用這些服務面臨潛在的風險。如果提供方無意中提供計算或買家從受制裁的實體購買計算,會怎麼樣?使用者可能不願意使用缺乏中心化實體控制和監督的去中心化平台。協議已經試圖透過將控制納入其平台或僅提供已知計算提供方的篩選器(即提供 KYC 資訊)來緩解這些擔憂,但需要更強大的方法來保護隱私同時確保合規,以促進採用。短期內,我們可能會看到出現 KYC 和符合監管的平台,限制對其協議的使用以解決這些問題。
審查。監管是雙向的,去中心化計算提供者可能受益於限制對人工智慧的使用所採取的行動。除了行政命令外,OpenAI 創始人 Sam Altman 曾在國會作證,強調了頒發人工智慧開發許可證的監管機構的必要性。圍繞人工智慧監管的討論剛剛開始,但任何試圖限制對人工智慧的使用或審查人工智慧的嘗試可能會加速採用沒有這些障礙的去中心化平台。去年 11 月 OpenAI 的領導層變動進一步證明了將決策權授予僅有少數人的最強大的現有人工智慧模型存在的風險。此外,所有人工智慧模型都必然反映了其創建者的偏見,無論是有意還是無意。消除這些偏見的一種方法是盡可能地使模型對微調和訓練開放,確保任何人都可以隨時隨地使用各種偏見的模型。
資料隱私。當與為用戶提供資料自主權的外部資料和隱私解決方案整合時,去中心化計算可能會比替代方案更具吸引力。三星公司就曾遭受此類問題,他們意識到工程師正在使用 ChatGPT 來幫助晶片設計,並洩露了敏感資訊給 ChatGPT。 Phala Network 和 iExec 聲稱為用戶提供了 SGX 安全隔離區,以保護用戶數據,並且正在進行完全同態加密的研究,進一步解鎖確保隱私的去中心化計算。隨著人工智慧進一步融入我們的生活,用戶將更加重視能夠在具有隱私保護功能的應用程式上運行模型。使用者還將需求能夠實現資料的可組合性,以便能夠無縫地將其資料從一個模型轉移到另一個模型。
使用者體驗(UX)。使用者體驗仍然是所有類型的加密應用和基礎設施更廣泛採用的重要障礙。去中心化計算方案也不例外,在某些情況下,由於開發者需要理解加密和人工智慧,情況更加嚴重。需要進行改進的面向包括從入門和與區塊鏈互動的抽像到提供與當前市場領導者相同的高品質輸出。這是顯而易見的,因為許多運行中的去中心化計算協議提供更便宜的方案,但難以獲得常規使用。
智能合約與零知識機器學習(zkML)
智能合約是任何區塊鏈生態系的核心建構模組。在特定條件下,它們會自動執行並減少或消除對可信任第三方的需求,從而實現了像 DeFi 中所見的複雜去中心化應用程式的創建。然而,就目前而言,智能合約在功能上仍然存在局限性,因為它們基於預設參數執行,這些參數必須進行更新。
例如,一個借貸協議智能合約根據一定的貸款價值比例規範了何時清算頭寸。在一個風險不斷變化的動態環境中,這些智能合約必須不斷更新以考慮風險容忍度的變化,這為透過去中心化流程進行管理的合約帶來了挑戰。例如,依賴去中心化治理流程的 DAO 可能無法及時對系統性風險做出反應。
整合人工智慧(如機器學習模型)的智慧合約是增強功能、安全性和效率的一種可能的方式,同時改善整體使用者體驗。然而,這些整合也引入了額外的風險,因為無法確保支援這些智能合約的模型不會被攻擊或考慮到長尾情況(眾所周知,由於缺乏資料輸入,很難對模型進行訓練)。
零知識機器學習(zkML)
機器學習需要大量運算資源來運作複雜模型,這使得AI 模型無法在智慧合約內部直接運行,因為高昂的成本。例如,一個 DeFi 協議為用戶提供了收益優化模型的功能,但如果試圖在鏈上運行模型,就必須支付高昂的 Gas 費用。一種解決方案是增加底層區塊鏈的運算能力。然而,這也會增加鏈的驗證節點的負擔,可能會削弱其去中心化屬性。因此,一些專案正在探索使用 zkML 來以無需密集的鏈上運算就能以無許信任的方式驗證輸出的方法。
說明zkML 有用性的一個常見範例是,當使用者需要其他人透過模型運行數據,並驗證其交易對手是否實際運行了正確的模型時。也許開發者正在使用去中心化計算提供者來訓練他們的模型,擔心提供者正在嘗試透過使用成本較低的模型來節省成本,但輸出幾乎無法察覺。 zkML 使得計算提供者可以運行資料通過他們的模型,然後產生一個證明,可以在鏈上驗證模型對給定輸入的輸出是正確的。在這種情況下,模型提供者將有額外的優勢,即能夠提供他們的模型,而無需透露產生輸出的底層權重。
相反的情況也可以發生。如果使用者想要運行一個模型,使用他們的數據,但又不想讓提供模型的項目獲取他們的數據,因為存在隱私問題(例如醫學檢查或專有業務資訊),那麼用戶可以在他們的數據上運行模型而不共享它,並驗證他們是否運行了正確的模型,同時提供證據。這些可能性大大擴展了透過解決限制性運算限制來整合人工智慧和智慧合約功能的設計空間。
基礎設施與工具
鑑於zkML 領域的早期狀態,開發主要集中在構建團隊將其模型和輸出轉換為可在鏈上驗證的證明所需的基礎設施和工具上。這些產品盡可能地抽象化了開發中的零知識面向。
EZKL 和 Giza 是兩個項目,透過提供機器學習模型執行的可驗證證明,來建構這些工具。兩者都幫助團隊建立機器學習模型,以確保這些模型可以以一種無需信任地在鏈上驗證結果的方式執行。這兩個專案都使用開放式神經網路交換(ONNX)將以通用語言如 TensorFlow 和 Pytorch 編寫的機器學習模型轉換為標準格式。然後,在執行時它們輸出這些模型的版本,也產生 zk-proofs。 EZKL 是開源的,產生 zk-SNARKS,而 Giza 是閉源的,產生 zk-STARKS。這兩個項目目前僅與 EVM 相容。
在過去幾個月中,EZKL 在增強其zkML 解決方案方面取得了顯著進展,主要集中在降低成本、提高安全性和加速證明生成方面。例如,在2023 年11 月,EZKL 整合了一個新的開源GPU 庫,將整體證明時間減少了35%,並且在1 月份,EZKL 宣布了Lilith,這是一個軟體解決方案,用於使用EZKL 證明系統時整合高效能運算集群並協調並發作業。 Giza 獨特之處在於,除了提供創建可驗證機器學習模型的工具之外,他們還計劃實現Hugging Face 的web3 等效版本,為zkML 協作和模型共享開設一個用戶市場,並最終集成去中心化的計算產品。在 1 月份,EZKL 發布了一個基準評估,比較了 EZKL、Giza 和 RiscZero(下文討論)的表現。 EZKL 表現出更快的證明時間和記憶體使用率。
原文連結
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章