融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


Roam Research:不光是一個筆記工具
原文標題:《Roam白皮書》
原文來源:胖車庫
原文出自 Zack 在知乎的專欄,軟磨硬泡讓我拿到首轉,因爲實在翻譯的精彩。他在 Twitter 上寫到,Roam 的理想和願景應該值得更多的人看到,也恰恰是我想說的。Enjoy。
Roam 是去年新涌現出來的筆記工具,其他作者已經在知乎上把它的功能進行了詳盡介紹:Roam Research 這款筆記軟件有何特別之處?
這裏,我把 Roam 創始人寫的白皮書翻譯了一下,希望能給大家一些啓發。摘抄一下原著的結論:
今天的人類知識體系,是一個浩瀚的信息與思想的海洋,其中很多是不準確的,有些是惡意的,其最佳資源或有看門人限制,或幾乎不可能找到。信息量呈指數級增長,如果能夠解決潛在的協作問題,這將帶來巨大機會。
顯然,我們需要一種跟以往本質上不同的方法。Roam 對人類知識的願景是一種集體的、開源的智能,不斷地重新排列、迭代和進化以追求真理。我們每個人都將成爲這個集體智能中的一個節點,建立聯繫並創建網絡,分享每個人所能提供的最好的東西,在改善他人的同時也在改善自己,推進人類整體前進。
原著:Conor White-Sullivan | cwhitesullivan@gmail.com
英文:https://roamresearch.com/#/app/h elp/page/Vu1MmjinS
中文:https://roamresearch.com/#/app/trade/page/nhzz3wRuM
翻譯:Zack Fan | zack.fan@gmail.com
摘要:Roam 是一個用於組織和評估知識的在線工作區。該系統建立在一個有向圖(Directed Graph) 的基礎上,使其不受經典文件樹架構的束縛。用戶可以在多個重疊的層次結構中混合和連接思想,每個信息單元都成爲動態網絡中的一個節點。任何給定的節點可以同時佔據多個位置,通過可定義的關係鏈傳遞信息,並實時在整個有向圖中更新。如果將節點之間關係強度分配了相應的權重,Roam 也可成爲貝葉斯推理和決策 (Bayesian Inference) 的工具。我們的最終目標將此係統擴展到協作推理領域,並允許團隊構建可共享的心像地圖 (Mental Map),從而做出更快、更明智的決策。
1. 導言
我們正在經歷前所未有的知識爆炸。僅在美國,每天就有 2700 本書籍出版,6850 篇科學論文發表,200 多萬篇博客文章上線,2940 億封電子郵件飛來飛去。地球每轉一次, 如果把新產生數據寫入書裏,那麼這些書堆積在一起可以從地球到月球一個往返 (注 [1])。儘管這種指數增長爲個人和整個社會帶來了巨大的機遇,但無論是人腦還是當前的技術都還無法駕馭。
2. 當前知識管理的常見做法
人類對信息時代的適應性很差,信息時代僅在我們進化史的最後 0.02%出現。儘管大腦確實具有非凡的原始存儲能力,可能在幾 PB (Petabytes) 範圍內(注 [2]), 但它在處理信息時極易出錯。人類的記憶檢索是有損且不可靠的,而許多固有的認知偏見及思維方式在現代世界中也會失效,從而扭曲了我們的感知、判斷和決策能力。大腦的可塑性使它能夠用新的鏈接重新連接自己,但即這也是一個「用則有,不用則無」的特質,那些不常用的的神經通路最終將逐漸萎縮。
爲了應對這些侷限,許多在大腦之外組織知識的技術應運而生。自古登堡印刷術(Gutenberg Press)發明以來,實體書籍和期刊大量涌現,此後又部分被文字處理程序,網站,博客,論壇,維基及其它軟件應用所取代。
雖然我們對所學知識進行構架管理的方式有很多選擇,但幾乎每種技術都遵循相同的「文件櫃」格式:即知識單元/文件被保存到某個特定文件路徑中,該路徑指向按章節或類別分類的某個文件夾。當某個知識單元/文件與許多知識點相關時,可以給它打相關知識點標籤,但每個文件通常只存儲在一個單一的嵌套層次結構中。要訪問這些信息,用戶必須記住他們存儲文件的位置,標籤的內容,或者使用搜索功能來定位文件。
相關討論:
https://twitter.com/Conaw/status/1099181050045952006
By Conor White-Sullivan@Conaw
3. 文件櫃架構的問題
在某些方面,當前的技術仍遠不及人類的大腦。如果每個神經元僅能保存一個單獨的「單位」記憶,我們的大腦就會迅速充滿到溢出。相反,信息在大腦中是通過神經元和神經網絡之間的聯繫來傳遞的,因此一個想法可以被整個大腦共用;藍天的概念可能被重複用於無數看似互不相關的戶外時光記憶中。這種效率有助於解釋爲什麼一臺計算機需要幾百萬倍的能量來完成與人腦相同的任務(人腦的功率大約相當於一個昏暗燈泡的功率)。(注 [3])
與大腦不同,文件櫃方法使聚合或重用同一條信息很難甚至是不可能,因爲每次對任何給定文件進行修改時,都必須在其存在的每個位置對其進行跟蹤和更新。這就導致了冗餘,幾乎相同的想法重複被記錄,且在任何需要系統範圍更改時都要進行大量工作。
當前的解決方案也缺乏互聯性, 許多文件被孤立而脫離了其上下文;信息被放在抽屜裏,而不是系統性的放進更廣泛的知識框架中。知識樹可以在給定層次結構中的文件之間創建非正式關係,但這些關係通常是不明確的,且只能描述垂直的「父和子」分類關係。一些工具,如網頁和 wiki,同樣允許相關文件之間的正交鏈接,但通常是非標準化的,且並沒有清晰定義鏈接特性的能力。
4. 用節點網來展現的知識圖譜
與傳統的文件樹相比,大規模協作需要更靈活的數據結構。Roam 是建立在映射所有可能關係的知識圖上的,並在用戶所定義的概念之間建立了「智能」鏈接。用戶可以在多個重疊的層次結構中連接相似的想法,在不覆蓋原文的情況下重新合成它們,並有選擇地與其他人共享知識圖的一部分,以便在特定的子問題上進行協作。
如果市場現有的工具類似於文件櫃,那麼 Roam 更類似於電信網絡中的節點網或者人腦中的神經元集羣。每個註釋或文件不是存在於真空中,而是成爲相互聯繫的知識圖中的一個節點。單個節點可以同時在多個不同的序列、層次結構或文件路徑中保持位置,並且可以與其他節點「對話」,雙向傳遞有關每種關係性質的信息。該網絡是動態的,任何更新和修訂將實時更新至整個網絡。網絡中的各個節點或分支可以根據需要進行分叉,從而允許在不更改原始含義的情況下建立新路徑。
在最簡單的層面上,Roam 的結構使得存儲、回憶和交叉引用思想變得更加容易, 這也是針對學生、作者、自學者和現有筆記程序用戶 Roam 能幫到的主要領域。
對於高級用戶,知識圖還可以幫助解鎖邏輯與推理,貝葉斯推理與決策,複雜問題建模及協作研究等多領域的更多應用。這些功能以及相關技術的潛在用例將在第 5-8 章中進行探討。
5. 用節點網來展現的知識圖譜
從研究論文的同行評審到報紙的時評,人們都是基於某種前提下來闡述某個觀點,大致如下:
如果 A 爲真,則 B 爲真。如果 C 和 D 都爲真,則 A 爲真。C 和 D 是都爲真。因此,B 爲真。
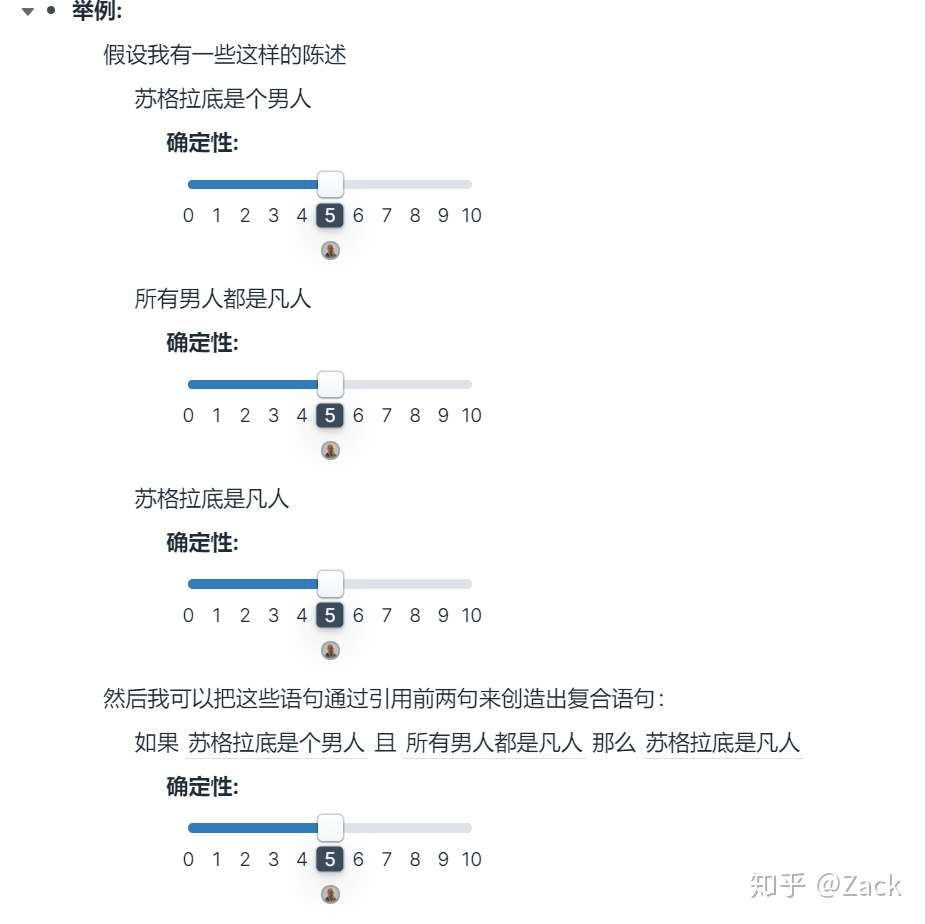
當訪問其中一個被引用的語句(block) 時,我們能看到整個複合句已被關聯。
例如:
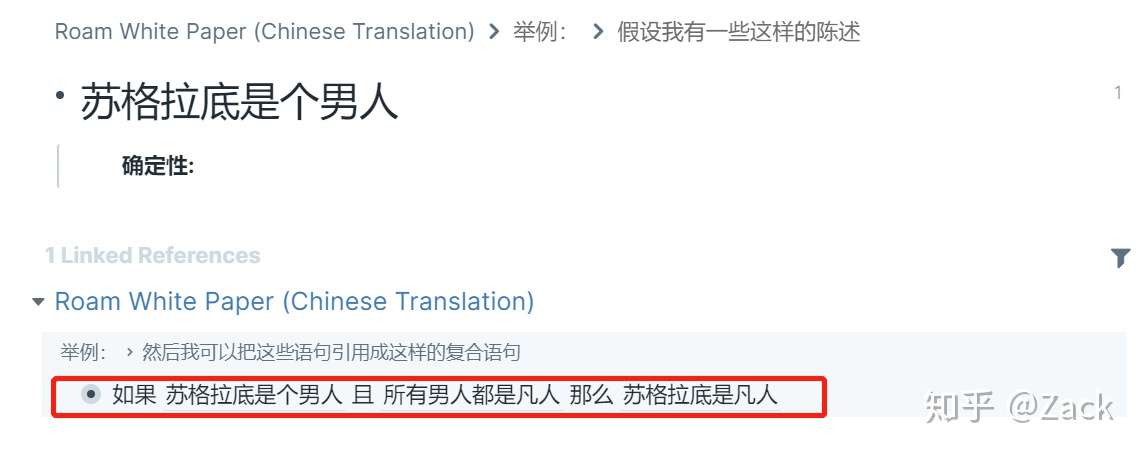
通常,C 和 D 的論點是通過外部文章的鏈接得到支持,它們往往是基於更大論點之下,並綜合其它前提後所得出的結論。不幸的是,論據的結構只是在語句中被暗示。除了在作者用作推論的草稿外,論據和證據之間的關係極少在文章中被明確的闡述。
Roam 允許科研工作者或作家把他們在不同項目中所想表達的思想組織起來。它也爲大規模的跨學科研究項目創造了機會。當感興趣的合作團隊在一個一致同意的框架下討論正反論點時,那我們就有可能創建可擴展的用戶界面,將一些需要專業知識的洞察轉化爲更容易被外行人理解的觀點。
自然語言的歧義性常常阻礙了許多有意義的討論,且除非討論的議題從一開始就有明確的定義,否則任何形式的爭論都是徒勞的,並且通常最終會鞏固對話者的最初立場。
示例 A
愛麗絲:「一棵樹倒在一大片荒蕪的森林裏會發出聲音。」
鮑伯:「一棵樹倒在一大片荒蕪的森林裏不會發出聲音。」
示例 B
愛麗絲:「一棵樹倒在一大片荒蕪的森林裏會 (產生聲波振動)。」
鮑勃:「一棵倒在一大片荒蕪森林中不會 (產生聽覺體驗)。」(注 [4])
雖然這些立場如示例 A 所示是矛盾的,但簡單地定義「聲音」一詞則可以表明雙方基本看法 是完全兼容的。
在依賴關係圖 (Dependency Graph) 中使用明確定義的集合有助於解決歧義,減少討論的參與者夾雜其他目的進行辯論,或者故意使用「莫特和貝利謬誤戰術」(Motte-and-bailey fallacy) 進行誤導。(注 [5])
除了推理和論證,依賴關係圖在教育、自主學習和日常決策中也有衆多應用。即使是一個非常複雜的項目,也可以追溯到一些較小的任務。用戶可以看到每個決策路徑所涉及的權衡,找出哪條路徑最快,哪條路徑可能更接近其他有趣的目標。當學生記錄學習進程時,他們也可以利用學習中獲得的技能發現新的任務和路徑。
語言表達的問題甚至適用於數學證明領域,請參閱 Lamport 的「如何編寫 21 世紀的證明」(How to write a 21st Century Proof)。
6. 理清複雜關係 6.1 非線性因果關係
簡單的問題往往遵循直接的因果關係。當病人有一系列與流感密切相關的症狀時,醫生可能會從可觀察到的變量中推斷出有一個不可見的變量——流感病毒。治療這個潛在的變量,症狀就會消失。
Scott Alexander 觀察到,他的精神病學同行同樣試圖將一組相關症狀歸因於一個潛在變量,例如抑鬱症。(注 [6])然而,抑鬱症引起的症狀-例如睡眠障礙、疲勞、內疚——也會對彼此和紊亂本身產生因果影響。這種複雜的關係網,可能包括反饋迴路,並不遵循線性因果關係的路徑。對於這種性質的複雜問題,節點網絡是一個更精確的模型:
Nuijten、Deserno、Cramer 和 Borsboom 建立的一個抑鬱症(MD)和廣泛性焦慮症(GAD)模型。(注 [7])這些疾病大致映射到一系列症狀上,這些症狀經常在一起發生並相互加強,但在這些症狀之間沒有清晰的「亮線」。
即使從表面價值來看,節點網絡也爲解決問題提供了一種直觀的幫助——鳥瞰各種元素之間的聯繫。這可能有助於識別不同形態或羣集,這些形態或羣集可能是違反直覺的,或者當研究微觀結構時很難看到整體面貌。
6.2 貝葉斯推理
將貝葉斯推理應用於知識圖,可使其成爲概率估算、假設評測和決策制定的強大工具。貝葉斯定理是一個概率定律,它告訴我們,當學習一個新的事實或獲得新的證據時,我們應該在多大程度上改變我們對某事的看法。該定理在下列方程式中陳述:
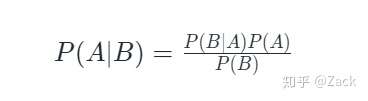
其中 A 是關注的命題,B 是觀察到的證據, P(A) 和 P(B) 是先驗概率, P(A|B) 是 A 的後驗概率。
假設一個醫生有一個病人,因爲他屬於一個高危人羣,所以他想知道攜帶一種潛在病毒的概率, 這是等式左邊的「關注命題」。先前的數據表明,總人口中有 4%是病毒攜帶者,因此 P(A) = 0.04。B 是觀察到的證據, 即 32% 的總人口是高危人羣,P(B) = 0.32。醫生知道,在攜帶該病毒的患者中,80% 屬於高危人羣:B | A=0.8
醫生應用了貝葉斯定理:
P(A|B) = (0.8 * 0.04)/0.32
P(A|B) = 0.1
她的病人只有十分之一的機會成爲病毒攜帶者,這可能低於常人的預期,因爲幾乎所有的攜帶者都是高危人羣。
雖然這是一個簡單的計算,但貝葉斯推理的優勢在於可以將看似無法解決的問題分解成小塊。即使沒有可用的數據,連續的多層估算仍然可以對各種結果的置信水平提供有益的改進。通過將此框架加入到節點之間定義的關係中,網絡中任何一點的權重的修改將自動更新到整個知識圖中。
貝葉斯概率也爲決策制定提供了一個框架。通過評估各種選擇的成本和取捨,用戶可以計算出哪條路徑提供了最高的期望值。同樣,即使權重只是個人喜好的簡單估計,決策的質量也可以通過多層的正反方論據來改進。評估矩陣允許我們將大量信息集成到最終決策中,而不是默認使用某種簡單的推斷法。
7. 爲意外發現進行優化
正如人類無法隨意生成隨機數一樣,讓我們有意識地生成隨機想法也很困難——以至於我們常常主動嘗試「以不同的方式思考」,但這似乎只會進一步加深現有思維模式的固化。大腦必須面對新的刺激,才能重新組織其感知能力,而不是試圖粗暴地強行產生創造力。暴露在一定數量的隨機「噪音」(夢境、冥想、塔羅牌閱讀、錯誤)會使思想脫離常理的束縛,進入全新的思維空間。通常,這些洞察發生在兩個或多個看似不相關的領域、概念或形態的交界處。
Roam 知識圖的相互聯繫可不斷地爲意外發現創造機會。網絡中的每個節點都可以在多個圖表顯示與查看,用戶可以查看相關的想法,上下掃描垂直層次結構,檢查附近的節點羣集以及觀察知識圖的形態。
Roam 的搜索功能可以根據用戶的需要進行校準,以包含儘可能多或儘可能少的「噪音」。在尋找特定的段落或註釋時,搜索設置可以足夠窄,以準確地找到用戶的想法。然而,它也可以擴大到「釣魚之旅」的範圍,目的是使各種想法浮出水面。一些搜索結果將包含用戶可能已忘記的註釋,一些可能是噪音,而另一些則會激發用戶甚至不知道自己在尋找的想法。
來自不同領域思想的交叉融合可爲個人和社會帶來唾手可得的效益。而成爲某個領域一名專家所需的時間和精力投入則很快會進入收益遞減。相比之下,積累一系列業餘知識或技能的「才華」反而可以捕捉到那些侷限在更窄關注點專家們所洞察不到機會。
高度專業化的知識對於開闢新的領域仍然至關重要。然而,面對日益複雜的問題,跨學科的研究方法對科學家、技術專家和決策者也變得愈發必要。
8. 協同問題解決
雖然 Roam 的單人使用有其自身的優點,但最終目標是創建一個協作研究和學習的平臺。現有機制常常受到必要共識假設的約束,而知識圖庫的靈活性允許一種更加多元化的方法,能夠在不訴諸專制或民主的情況下,權衡相互衝突的觀點,將信號與噪音分離。
8.1 在噪音中尋找訊號
隨着信息頻率的增加,世界變得越來越嘈雜。如第 7 章所述,在特定情況下,故意暴露於噪音是一種有用的策略,但在其他時候會造成溝通中的含混。(注 [8])鑑於我們有把故事和解釋強加於隨機性的傾向(即敘事謬誤),將真正的信號與噪聲區分開來變得越來越困難。
假設一個趨勢的年化信噪比爲 1:1(50% 的數據是有意義的,50% 是隨機的)。如果我們每天觀察相同的數據,則比例變化爲 95% 的噪聲,5% 的信號。如果每小時觀察一次數據(就像新聞記者和市場狂熱追蹤者那樣),它就會變成 99.5% 隨機-也就是說,噪音是信號的 200 倍。(注 [9])負責解釋數據的機構包括媒體,學術界和立法機關。這些機構中的某些人可能故意掩蓋真相,如「假新聞」,p-hacking 和 politicking。儘管主動的惡意行爲是例外,但即使是最好的記者,研究人員和分析人員也不能倖免被隨機性所愚弄。
因此,對大多數人來說,從噪聲中分離信號的問題涉及到尋找可靠和準確的輔助信息源。這項困難的任務經常被封閉的科學期刊和搜索引擎算法所阻礙,這些算法越來越被精通搜索引擎優化的內容營銷人員操縱。
8.2 信息冗餘
瀏覽海量信息會產生大量冗餘。大多數人將精力浪費在已經解決了一百萬次的問題上。那些解決未解決問題的人們經常在信息孤島上,而沒有意識到彼此的存在。任何給定拼圖的所有碎片可能都存在,但沒有一個個體或羣體持有全部。在無窮無盡的論壇、評論區、網頁和書籍中,車輪被一遍又一遍地重新發明,信息突然出現,又很快消失得無影無蹤。
8.3 共識
今天,幾乎每種媒體都把所傳播的認知當作真理來呈現;假設有默認的共識,且不可分割。維基百科是互聯網時代最偉大的奇蹟之一,但它同時犯了這兩個錯誤。對於任何給定的語言,任何主題都只能有一篇文章,頁面之間的唯一連接是通過鏈接,而沒有文章是在另一篇文章的基礎上構建的。
相比之下,我們來看一下 Github:庫是在其他庫上構建的,功能是從其他功能上構建的。開發人員致力於開發可以被其他人拿來做更棒工具的工具。大多數現代互聯網都是建立在開源技術之上的,如果程序員只能遵循舊的協議進行智能協作,這是不可持續的。
許多問題可以通過編寫代碼來解決,但是自然語言仍然是我們確認哪些問題值得解決的方式。自然語言是我們相互解釋世界並交流現實模型的方式。它是教育的語言,也是決策的語言。自然語言需要一個跟管理代碼的工具鏈一樣好的協作工具鏈。
8.4 協作方法
必要共識的問題是可以由個人或團體根據他們自己的信任網絡所提供的數據,並依其所得出的推論圖來解決。然而,協作仍然需要一種機制來評估哪些想法是最好的。就像個人給自己的預測和決定賦予權重一樣,團隊必須能夠對任何給定的想法、前提或證據的可信性進行「投票」。如何校驗這些集體權重,有多種選擇,下面簡要介紹其中一些。
a) 羣體智慧
一羣人可以做出比任何一個個人都更好的某些決定和預測:偉大的統計學家弗朗西斯·高爾頓驚訝地發現,在一個鄉村集市上,800 人猜測一頭牛的均重僅比 1198 磅的正確數字低一磅。
簡單的人氣比拼並不總是能讓我們更接近事實,但它是有用的,因爲它告訴我們什麼是我們相信的。這些數據可按人口統計數據來分解,以展示不同的羣體如何看待現實,並可能提醒人們注意到其自身羣體內的偏見。
b) 可信度評分
對衝基金經理雷達里奧(Ray Dalio)在橋水基金(Bridgewater Associates)開創了一個決策系統,相較民主制度這更像一個智者治國的制度:與那些可信度得分較低的人相比,那些反覆證明自己對特定專題或特性有把握的「可信」人的觀點更具分量。沒有什麼可以阻止達里奧的觀點被他最年輕的員工推翻,只要員工始終可持續證明比達里奧更正確。在 Roam 中實現類似的系統將需要跟蹤績效的能力,比如用戶對知識圖貢獻了多少被廣泛支持的原創內容,或者他們的預測有多麼精準。
c) 預測市場
當人們屈服於同伴的壓力和其他偏見,沒有足夠的專業知識或故意做出錯誤的預測時,「羣體的智慧」最終可能是非常錯誤的
預測市場背後的洞見是,可以利用市場的力量激勵參與者從任何錯誤中獲利。只要有人認爲某個共識是錯誤的,他們隨時可以押注該共識是錯誤的,從而把概率推回到一個更明智的立場。內幕信息不僅被允許,而且受到歡迎。通過這種方式,大量的信息可以被合成爲一個不斷更新的數據點,且其通常非常準確。
監管問題抑制了預測市場的增長與擴大,可能的解決方法包括非法定代幣(non-fiat token)或聲譽掛鉤積分系統。
9. 結論
今天的人類知識體系,是一個浩瀚的信息與思想的海洋,其中很多是不準確的,有些是惡意的,其最佳資源或有看門人限制,或幾乎不可能找到。信息量呈指數級增長,如果能夠解決潛在的協作問題,這將帶來巨大機會。
顯然,我們需要一種跟以往本質上不同的方法。Roam 對人類知識的願景是一種集體的、開源的智能,不斷地重新排列、迭代和進化以追求真理。我們每個人都將成爲這個集體智能中的一個節點,建立聯繫並創建網絡,分享每個人所能提供的最好的東西,在改善他人的同時也在改善自己,推進人類整體前進。
關於 Roam
Roam 由 Conor White Sullivan 和 Joshua Brown 創立。九年多以來,Conor 一直致力於集體智能工具的開發,創建了在線小鎮 common Localocracy(2011 年被 AOL 收購),並在收購之後領導了《赫芬頓郵報》的研發工作。Conor 和 Josh 在免學費的編碼大學 http://42.us.org 相遇,在爲期一個月的申請考試期間,喬希在首批 1000 名進入美國項目的學員中名列前五。該白皮書由商業記者 Richard Meadows 共同撰寫,他對早期原型的試用使他成爲 Roam 的第一位投資者。
本文轉自知乎,原文鏈接請點擊閱讀原文
參考資料 [1]
註釋 1: 現在每天至少產生 2.5 萬億字節的信息,這與 2002 年全年產生的信息量差不多。
[2]
註釋 2: 科學美國人:New Estimate Boosts The Human Brain's Memory Capacity 10-Fold 現在每天至少產生 2.5 萬億字節的信息。
[3]
註釋 3: 微電子學的先驅卡弗·米德(Carver Mead)創造了摩爾定律一詞,他在 1990 年正確地預測到,如今的計算機在單個指令中的能量消耗要比大腦在突觸激活中的能量高一千萬倍。
[4]
註釋 4: 本示例改編自《the Less Wrong sequence 37 Ways Words Canbe Wrong》
[5]
註釋 5: 莫特和貝利(Motte-and-bailey)指的是爭論一個容易辯護的、通常是常識性的陳述(Motte),以避免批評人士提出一個難以辯護的、更有爭議的陳述(bailey)。該術語由斯科特·亞歷山大(Scott Alexander)推廣,並在《All in All,Another Brick in the Motte》中進行了解釋。
[6]
註釋 6: Slate Star Codex:精神障礙作爲網絡(Mental disorders as networks)。
[7]
註釋 7: Michèle B. Nuijten,Marie K. Deserno,Angélique O. J. Cramer,Denny Borsboom:精神病理學的網絡方法的介紹和概述(An introduction and overview of a network approach to psychopathology)
[8]
註釋 8: 正如卡爾·薩根(Carl Sagan)所觀察的那樣,雖然每天電視節目中播放的數據比歷史上所有文字作品的總和還要多,「但並非所有的比特都具有同等的價值」。
[9]
註釋 9: 此示例來自塔勒布 (Nassim Taleb)《反脆弱》(Antifragile)。
原文鏈接
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
 相關文章