融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


Anthropic Engineer: How to Design a "Self-Correcting" Loop with Fable 5
原文標題:Designing loops with Fable 5
原文作者:Lance Martin
編譯:Peggy,BlockBeats
編者按:Anthropic 的 Lance Martin 認為,Claude Fable 5 這類 Mythos 級模型的關鍵用法,不是靠人不斷手動提示,而是為模型設計可自我糾錯的迴圈。
文章提出兩個核心技巧:一是通過 /goal、Outcomes 等機制設定明確目標或評分標準,讓模型在執行、接收反饋、修正方案之間持續迭代;二是利用 memory(跨會話記憶)讓模型記錄失敗、調查原因、驗證結論,並將經驗提煉成未來可複用的規則。
在 Parameter Golf 和 Continual Learning Bench 等實驗中,Fable 5 相比 Opus 4.7、Sonnet 4.6 更擅長進行結構性探索、堅持長期任務,並將記憶轉化為後續任務的有效改進。
文章的核心觀點是:與其直接操控模型,不如設計環境、反饋機制和記憶系統,讓模型自己在迴圈中變強。
以下為原文:
像 Claude Fable 5 這樣的 Mythos 級模型,已經改變了 Anthropic 內部許多人的工作方式。我想分享兩個技巧,幫助大家更好地發揮這類模型的能力。
自我糾錯迴圈
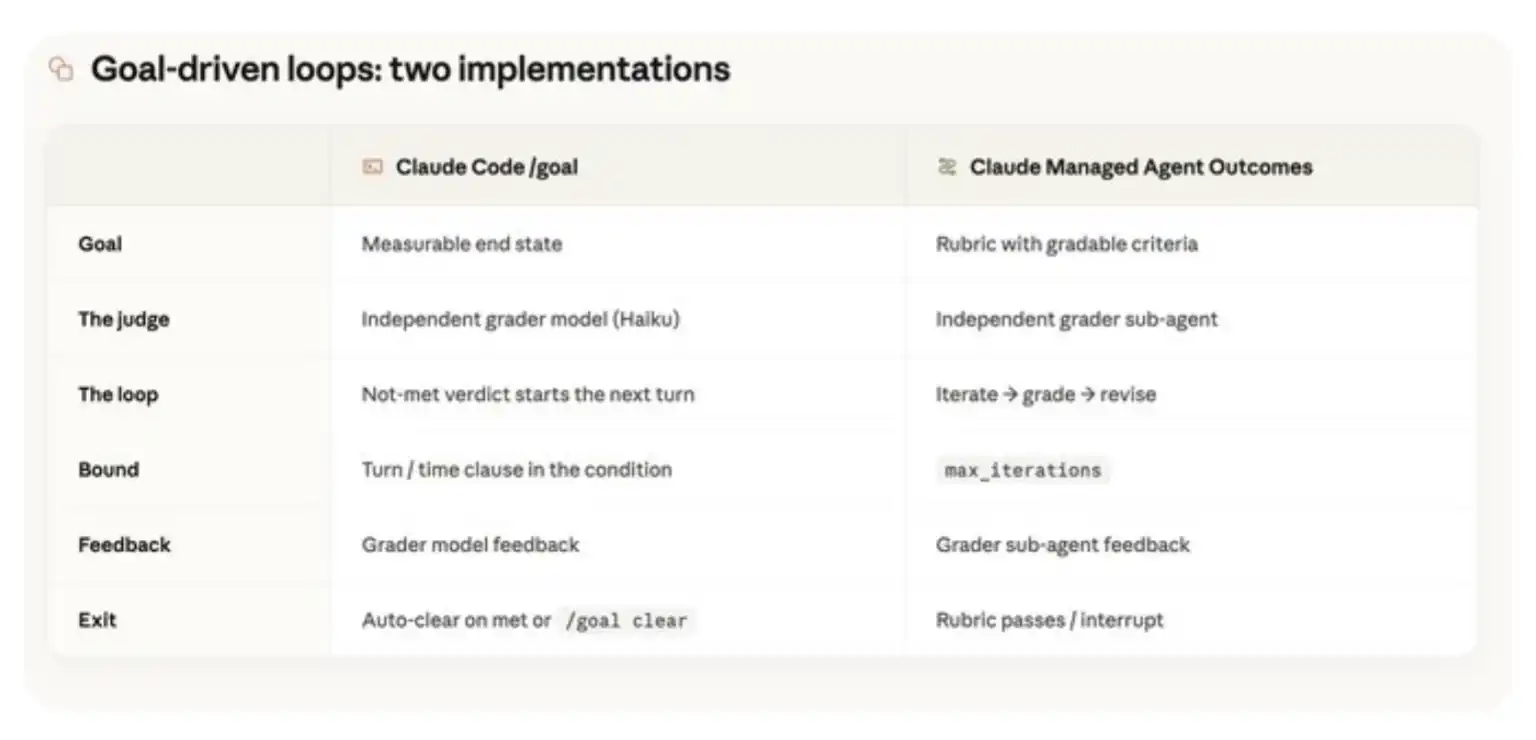
最近,大家對「迴圈(Loop)」很感興趣。@bcherny 曾提到,「我的工作就是寫迴圈。」讓模型圍繞某個評估標準不斷爬坡優化,是提升任務表現的常見方法:Claude Code 里的 /goal,以及 Claude Managed Agent 里的 Outcomes,都是可以讓你把這一通用方法應用到具體任務中的基礎能力。
正如我們在 Prompt 指南中提到的,Fable 5 很擅長在迴圈中進行自我糾錯。一個設計良好的目標或評分標準,相當於給 Claude 所處的環境增加了反饋機制。這樣,Claude 就可以先執行任務,再通過目標或評分標準收集反饋,隨後自我修正,並持續推進,直到滿足目標或評分標準為止。
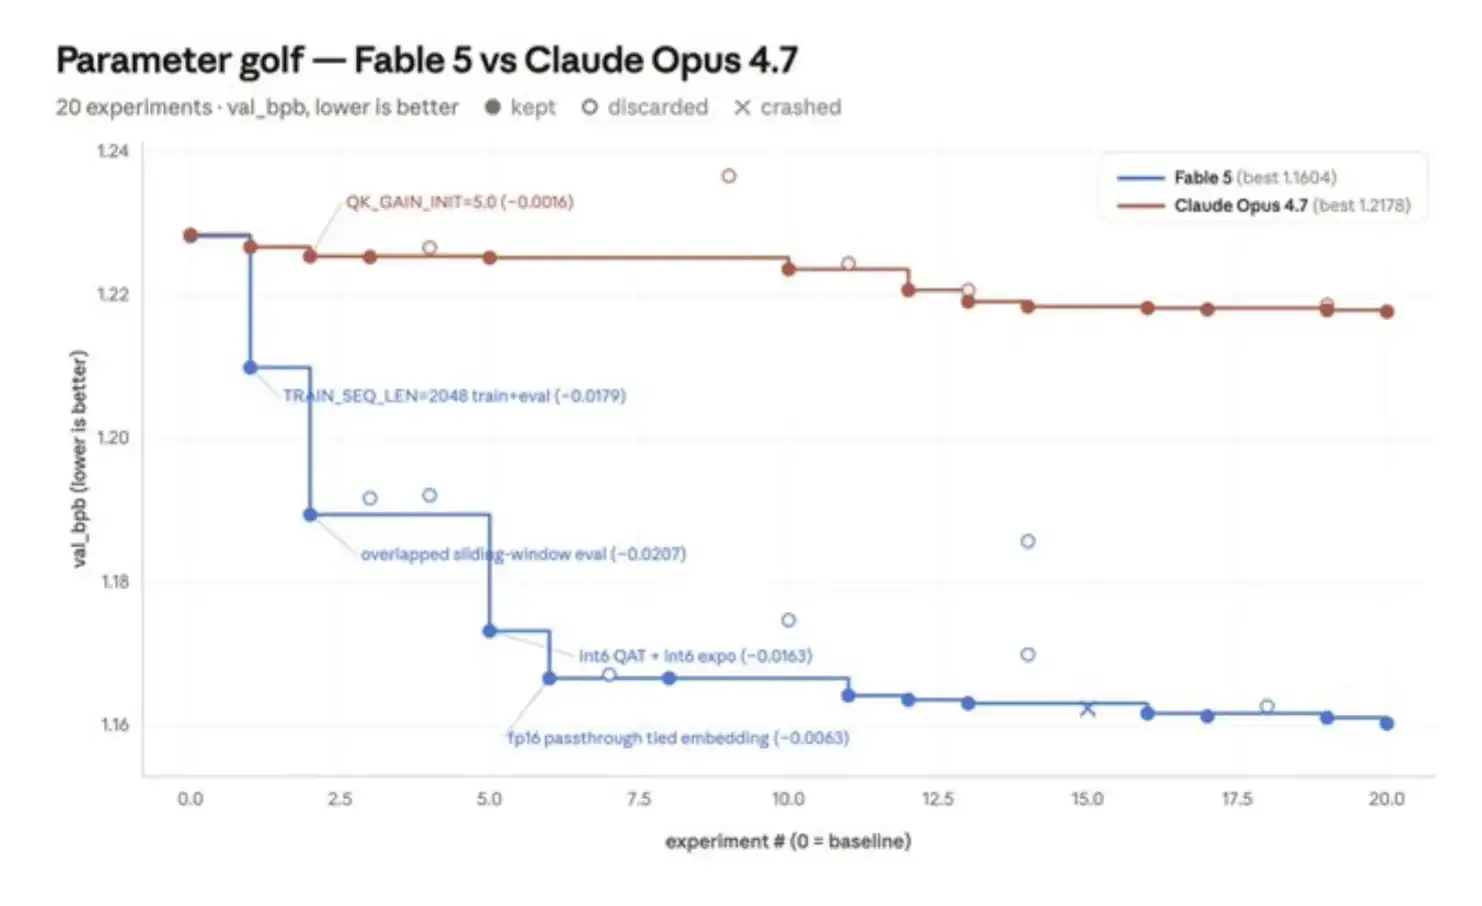
我分享一個自己用來測試 Fable 的小例子:Parameter Golf。這是一個開源的機器學習工程挑戰,目標是在 8 張 H100 GPU 上、10 分鐘以內,訓練出一個效果最好的模型,並且最終產物必須控制在 16MB 以內。
它有點像 @karpathy 的 autoresearch 專案:這個挑戰測試的是一個 Agent 是否有能力修改基礎訓練程式碼,也就是一個 train_gpt.py 檔案;啟動訓練;輪詢日誌;讀取分數;並決定下一步該運行什麼實驗。
我用 Claude Managed Agents(CMA)在這個挑戰上對比了 Fable 5 和 Opus 4.7。CMA 提供 Agent 運行框架和托管沙盒,因此非常適合讓 Fable 5 執行長周期任務。在 Parameter Golf 這個測試裡,我讓 CMA 接入了一個自托管沙盒,其中包含 8 張 H100 GPU。
這裡有一個微妙但重要的點:由誰來評斷結果很關鍵。我們發現,模型在批評自己生成的內容時往往會出現問題。Prithvi Rajasekaran 曾在我們的工程部落格中寫過這一點。
我們發現,對於 Fable 5 來說,使用一個驗證型子 Agent,通常比讓模型自我批評效果更好,因為評分是在一個獨立的上下文視窗中完成的。CMA 裡的 Outcomes 功能會自動為你啟動一個評分子 Agent 來處理這件事。
在每次測試中,我都會提供一個評分標準檔案,其中包含九項可檢查的標準,比如運行基準實驗、完成 20 次實驗等。隨後,我讓 Parameter Golf 最多運行 8 小時。只有當 Outcomes 評分器確認所有實驗標準都已滿足之後,Claude 才被允許停止工作。
結果是,Fable 5 對訓練流程的改進幅度大約是 Opus 4.7 的 6 倍。如果把實驗分為結構性實驗,比如改變模型架構,和標量型實驗,比如調整某個常數,那麼 Fable 5 更傾向於押注更大的結構性改動,並且表現出了更強的韌性。例如,它在一次量化回歸問題中堅持推進,最終取得了最大的一次提升。
相較之下,Opus 4.7 的第一次實驗帶來了一點小幅提升,但之後幾乎所有實驗都沿用了同一種模板:調整一個標量,測量結果,如果結果為正就保留。
記憶
記憶是 Fable 擅長的另一個領域。我們可以把它理解為一種跨會話運行的外部迴圈:Claude 會在一次會話中寫入記憶,而這些記憶可以在未來的會話中被再次檢索出來。
@pgasawa 和團隊最近發布了 Continual Learning Bench 1.0,所以我也想用它來測試 Fable 5 和早期模型之間的差異。
我在這個基準測試中的一項任務上,對比了 Fable 5、Opus 4.7 和 Sonnet 4.6。這個任務要求 Agent 在訪問一個 SQL 數據庫的前提下,連續回答一系列問題。每個問題都是一次獨立的 Agent 會話,並且會提供記憶能力。
為此,我使用了帶有記憶功能的 CMA。它會為每個 Agent 提供一個掛載的檔案系統,並且這個檔案系統可以在不同會話之間共享。
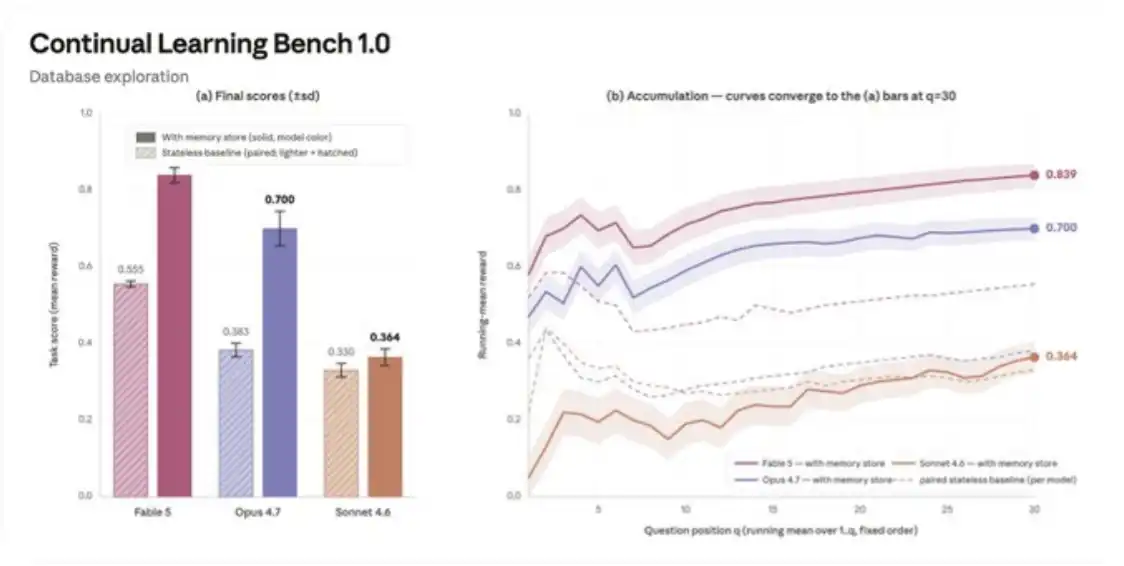
對於這項任務來說,想要有效利用記憶,通常需要經歷這樣一個递進過程:失敗(答錯並記錄下來)、調查(在繼續之前弄清錯因)、驗證(把診斷結果變成經過檢查的事實)、提煉(把驗證結果轉化為通用規則),以及查閱(之後直接讀取規則,而不是重新推導一遍)。
Sonnet 4.6 大約停留在第 1 步:它的記憶存儲更像是一串失敗筆記和未定猜測,比如「也許應該用 prc,而不是 prc_usd?」它很少查閱此前的筆記。若想提升表現,就需要加入面向具體任務的記憶使用說明。
Opus 4.7 大約推進到第 3 步:它會創建一份 schema 參考文件,并標註其中的不確定性,比如「prc 可能是以美分計價?需要驗證。」但它的驗證覆蓋率並不高:只覆蓋了 7% 到 33% 的問題,中位數運行結果約為 17%。
Fable 5 則傾向於完成整個递進過程:在表現最好的幾次運行中,它的驗證覆蓋率最高達到 73%,也就是 30 個問題中驗證了 22 個,並且會把學到的內容提煉成通用規則,從而幫助後續任務。
因此,與其直接提示並不斷引導 Fable 5,很多時候更好的方式,是設計一套迴圈,讓模型能夠根據環境反饋自我糾錯,比如使用 /goal 或 Outcomes;同時讓它自己管理上下文,比如通過記憶機制來完成。
我這裡只分享了幾個自己做過的小規模實驗,但 Fable 5 很值得你親自在高難度任務上測試,尤其是結合自我糾錯迴圈或記憶機制來使用。
想要上手,可以查看我們的文檔,或者直接詢問最新版 Claude Code。它可以使用內建的 /claude-api 技能,向你介紹 Fable 5,比如 Prompt 最佳實踐、/goal、Claude Managed Agents,或其他 API 功能。
[原文連結]
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
 相關文章