融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


中國AI大遷徙
原文標題:《中國AI大遷徙》
原文作者:Sleepy
工業史上有種規律,越是到了換代的時候,越能看清一個技術到底生長在哪兒。
十八世紀六七十年代的英國,水力紡紗機剛被造出來,工廠主們往北走,去奔寧山脈兩側的德比郡、蘭開夏郡找河谷。那時候瓦特的蒸汽機還沒進紡織廠,帶動紡錘靠的還是水輪。再過幾十年,蒸汽機鋪開了,工廠又陸續從山谷搬到了煤田和城市邊上。
每一次技術換代,先是一套算法、一張圖紙或一台機器的發明,緊接著就是一場找電、找水、找土地的地理意義上的大搬家。
風平浪靜時,全球供應鏈像一張鋪平的網,算力隔著太平洋也能調取,人們很容易產生一種錯覺,以為軟件與智能沒有重量,也不挑水土。可一旦遇到封鎖與圍堵,雲端就會落回地面,顯出它作為重工業的本來面目,它需要電,怕熱,挑線路,更取決於那一排排機櫃裡的芯片到底是誰的。
1964 年 10 月 16 日,羅布泊,中國第一顆原子彈爆炸成功,代號「596」。五年前的 1959 年 6 月 20 日,蘇共中央致信中共中央,決定暫緩提供協議裡商定好的原子彈教學模型和圖紙資料。
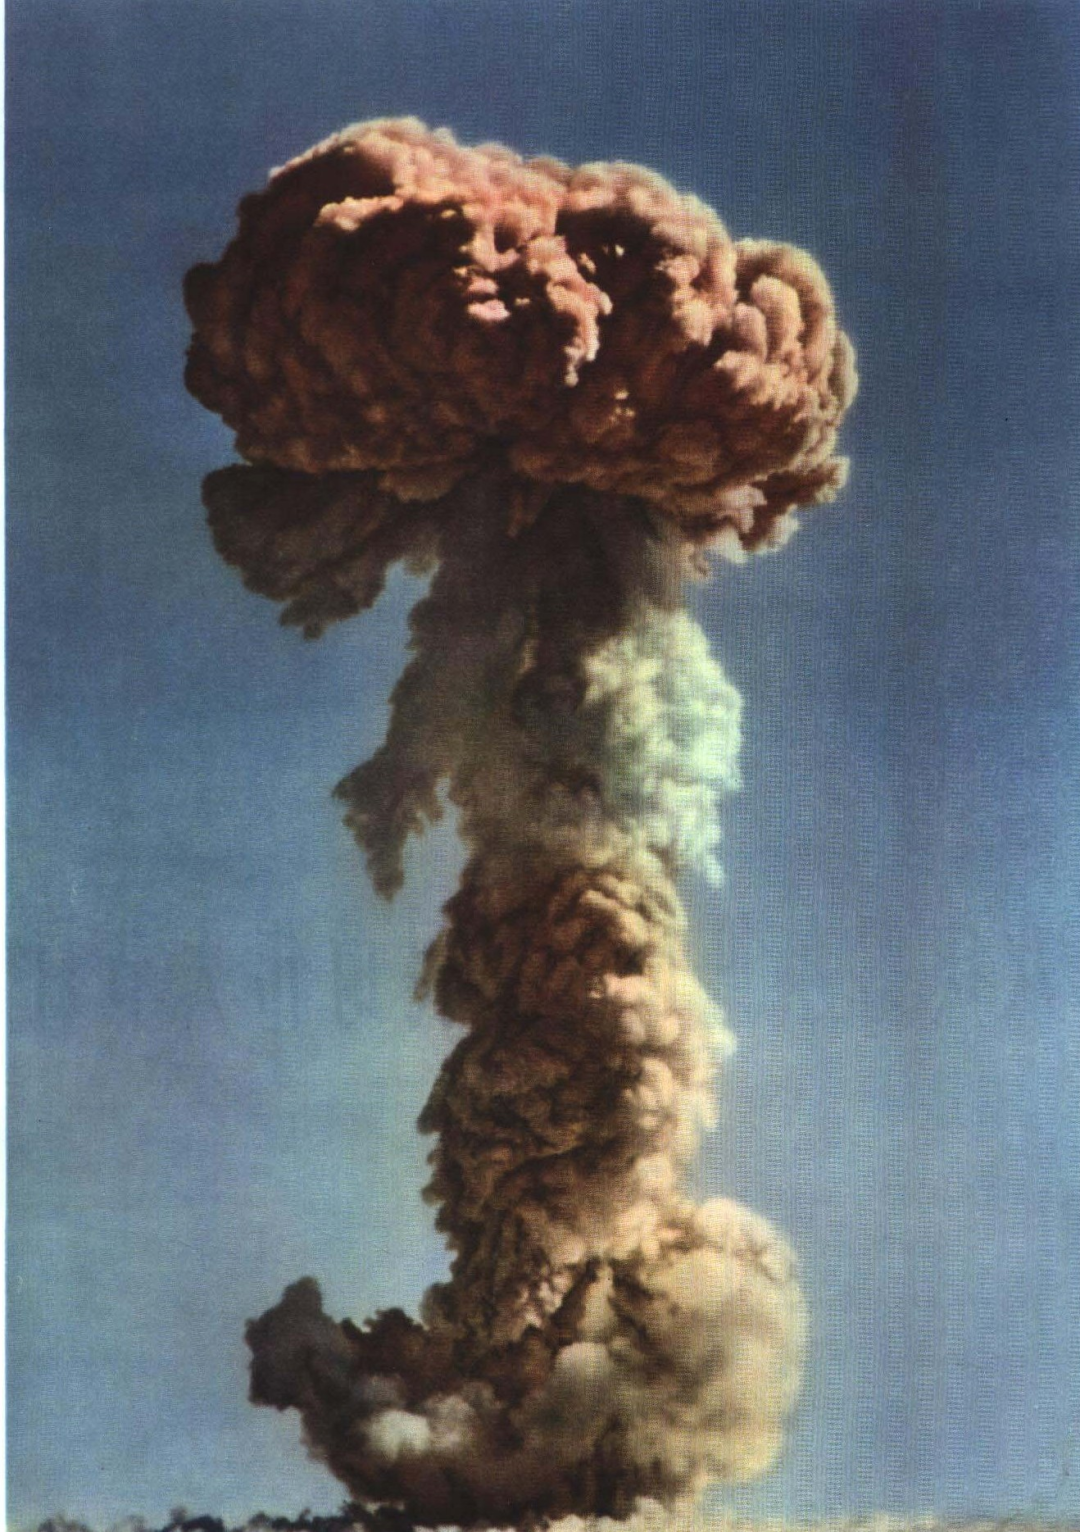
1964年羅布泊中國第一顆原子彈爆炸的蘑菇雲|圖源:人民畫報
幾乎在同一個秋天,三線建設的選址方針定了下來,靠山、分散、隱蔽,具體執行時又多出兩個字,進洞。此後十幾年,數以百萬計的工人、幹部、知識分子和解放軍官兵離開東部與東北的城市,把機床、高爐和實驗室搬進西南與西北的大山,高峰時投入的人力有 400 多萬。
半個多世紀過去,世界最前沿的工業換成了大模型。
訓練大模型的人,每天都有一個規定動作,存 checkpoint 。幾千上萬張加速卡連著跑幾個月,中間哪怕一張卡掉線,訓練就會中斷;每隔一段時間把模型的全部權重、優化器狀態和隨機數種子存下來,出了問題才能從最近的那一個節點接著跑。
這個詞在英文裡還有一個本義,邊境檢查站。
2026 年 11 月,在經歷了一輪橫跨赤道的找卡長征之後,中國大模型行業迎來了屬於自己的那座檢查站。
60 塊硬盤
故事要從四隻飛往吉隆坡的行李箱說起。
2025 年 3 月初,四名中國工程師從北京飛往馬來西亞。他們每人拖著一隻行李箱,箱子裡整整齊齊碼著 15 塊硬盤,一共裝著 80TB 的數據。
他們的目的地是馬來西亞當地的一座數據中心,僱主在那裡租下了約 300 台搭載英偉達先進芯片的服務器。
為了這一趟飛行,國內的同事提前八週多就開始打磨數據集、反覆調試訓練程序。因為數據一旦裝進箱子出了境,到了異國他鄉的機房裡,就很難再像在國內那樣推倒重來。至於為什麼不走網絡傳過去,理由是走網絡傳輸「可能要幾個月」,還不如肉身快。
按計劃,他們最後要帶回國的東西小得多,只有幾百 GB,是訓練好的模型參數。
這是中國大模型第一次算力遷徙最原始的切面,卡進不來,數據就坐飛機出去。
把工程師逼上飛機的,是幾年裡步步收緊的芯片禁令。
2022 年 10 月 7 日,美國第一次禁止向中國出售英偉達 A100 和 H100;英偉達很快專門為中國市場改出降低互聯帶寬的 A800 和 H800。僅僅一年後的 2023 年 10 月 17 日,降速版也被關在了門外。
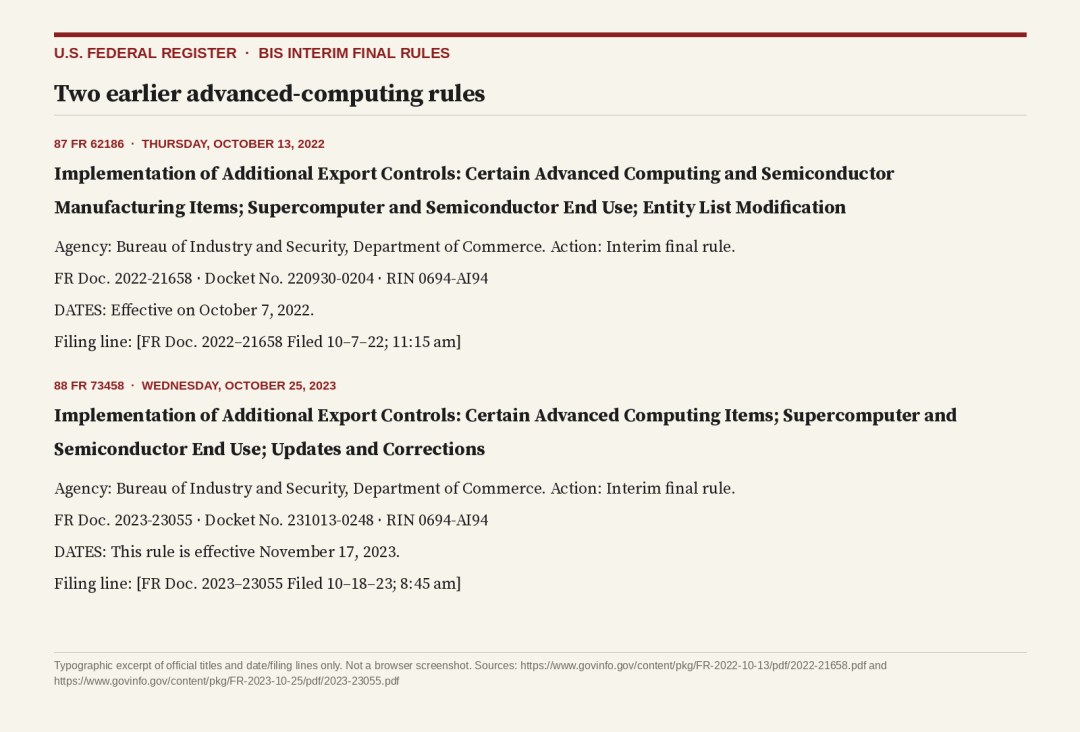
2022年與2023年美國先進計算芯片出口管制規則|圖源:政府官網
那年國內市場一卡難求。A100 從年初的 4 萬元左右一路跳漲到接近 25 萬元;10 月新規落地後的一週裡,H800 的報價幾乎翻倍,一台 8 卡整機在渠道商嘴裡喊到了 245 萬元。
與此同時,國內算力基建經歷了一輪早產。2023 年到 2024 年間,各地先後宣布了 500 多個智算中心項目,到 2024 年底至少 150 個已經投運。
一邊是實驗室拿着現金買不到卡,一邊是各地機房空置,原因在於大模型訓練的物理門檻,前沿模型需要的是上萬張同代際高端卡通過高速網絡拼成一個大集群,而散落在各地機房裏的,大多是零散、老舊、連不成片的推理卡或上一代顯卡。
好在當時的美國出口管制留了一道縫,只管買賣,不管租用。
總部在中國的公司不能把芯片買進國門,卻可以去租海外雲廠商和非中國業主的機房。行業裏很快摸索出一套分工,最吃算力、最講究集群通信帶寬的預訓練放在海外機房,模型訓好後,把權重帶回國內,用國內的算力池承接日常的用戶推理。
路跑通了,手提行李箱的土辦法很快被現代雲基建取代。
再往後,工程師連國都不用出了。訓練集群留在東南亞或北歐的機房裏,算法團隊坐在北京海淀、杭州餘杭或上海徐匯的工位上遠程登錄,在終端裏敲下一行行啟動命令。
柔佛的油棕林
地球上有一條看不見的空中走廊,叫「東亞—澳大利西亞遷飛區」。
它從俄羅斯遠東和阿拉斯加出發,穿過東亞和東南亞,一直延伸到澳大利亞和新西蘭,途經 22 個國家,每年有超過 5000 萬隻水鳥沿着它南來北往。馬來西亞柔佛州西南海岸的紅樹林濕地,是這條路上的歇腳處之一,其中的丹戎比艾正是亞洲大陸的最南端。
過去五年,這條遷飛路線上多了一種硅基候鳥。
柔佛與新加坡只隔了一道狹窄的柔佛海峽。這裏的紅土地換過好幾茬作物,1940 年代,從新加坡渡海而來的華人宗族砍開熱帶叢林,種下胡椒和甘蜜;英國殖民者來了,把作物改成橡膠;到了 20 世紀下半葉,漫山遍野換成了油棕樹。
如今,推土機推倒了成片的油棕林,種下了柔佛的第四代經濟作物,數據中心。
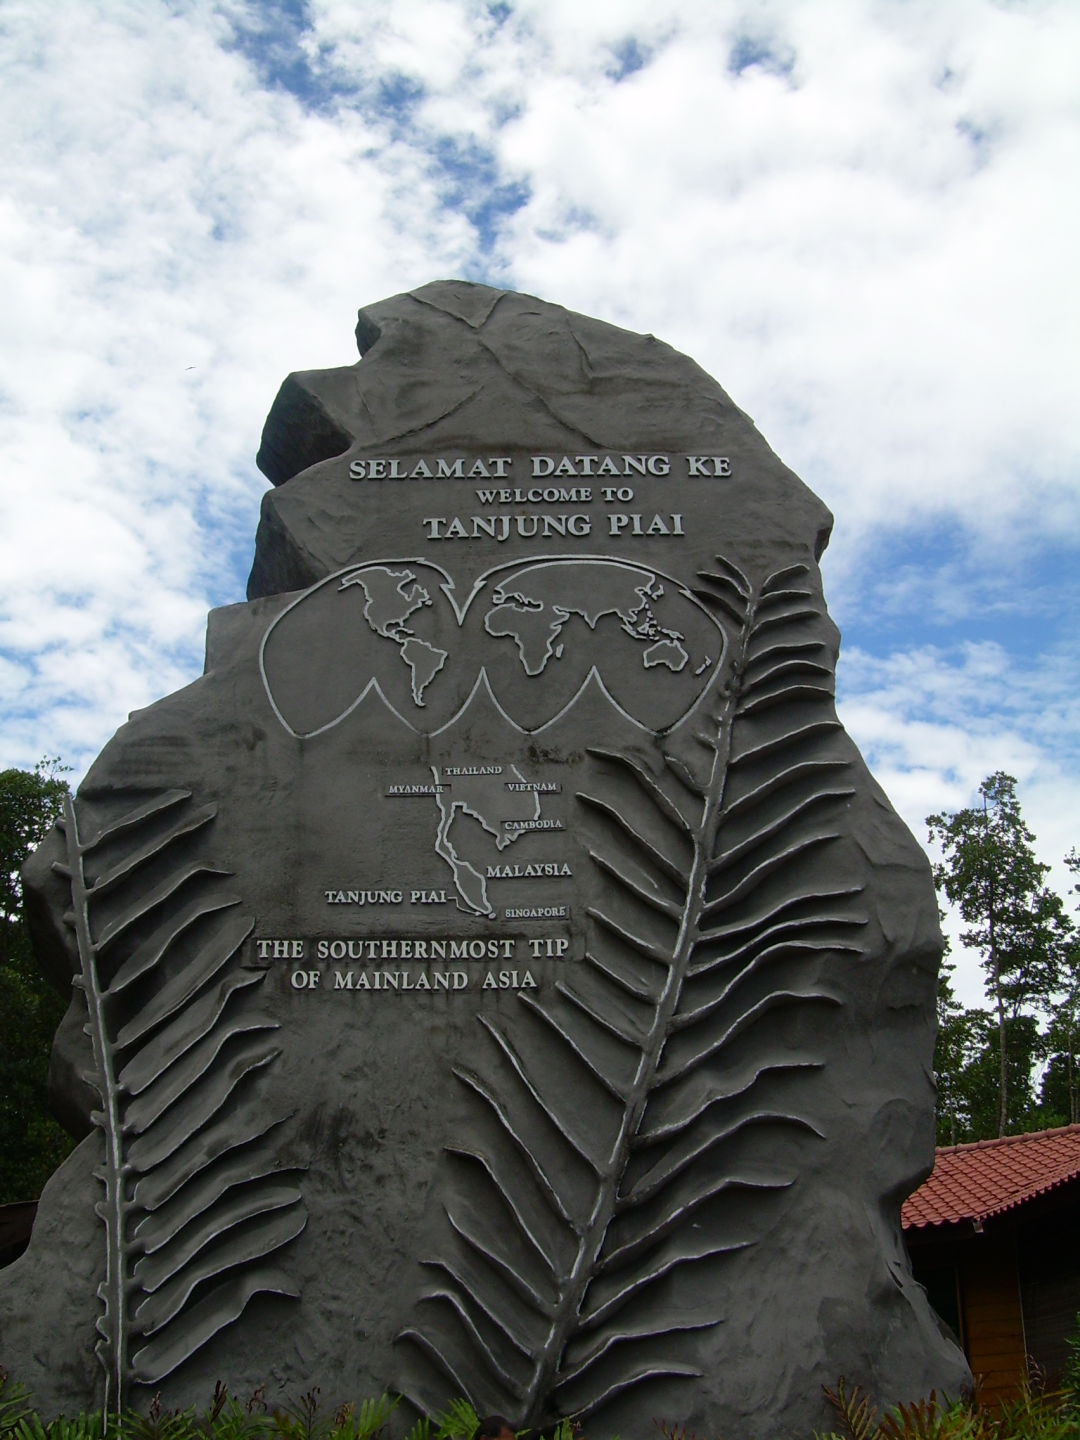
柔佛丹戎比艾亞洲大陸最南端地標碑|圖源:D.W. Fisher-Freberg
2021 年,整個柔佛州在線運行的 IT 負載只有區區 10MW 。到了 2025 年底,這個數字跨過了 900MW 。
把人吸引過來的,是海峽兩岸懸殊的要素價格。
新加坡地少、電貴,曾在 2019 年到 2022 年間暫停批建新數據中心。而在海峽對面的柔佛士年納科技園,每平方英尺地價只要 5.12 新元,新加坡大成一帶則要 6000 新元左右;柔佛的電價,也只有新加坡的一半上下。
更讓海外同行吃驚的是中國基建團隊的交付速度。中資背景的運營商在柔佛拿地、平整、拉電、裝冷卻,九到十二個月就能亮燈交機房。DayOne 和曾與秦淮數據合併、如今歸屬美國資本的 Bridge Data Centres 兩家,合計拿下了柔佛在線 IT 容量的至少 58%。而在柔佛的中資運營商名單裡,最大的客戶是字節跳動。
連接柔佛新山與新加坡兀蘭的那座跨海長堤關卡,每天有幾十萬人查驗證件通關,是世界上最繁忙的陸路口岸之一,也是這一帶最有名的物理 checkpoint ;而在海峽兩岸的機房裡,另一種 checkpoint 正被一份份存進硬盤。
2025 年 11 月,《金融時報》報道,阿里巴巴和字節跳動都在東南亞的數據中心訓練最新模型,簽的是非中國業主的租約。一位新加坡數據中心運營商當時對媒體解釋:「訓練最前沿的模型需要最好的芯片,而且一切都合法合規。」
美國智庫 IFP 做過估算,到 2026 年底,中國企業通過海外遠程訪問能夠調動的算力,折合下來約為 100 萬張 H100 等效算力,其中約 75% 分佈在東南亞。2021 年以來,馬來西亞批准的數據中心投資累計達 950 億美元。
飛得最遠的一支隊伍,一直飛到了北極圈邊緣。從 2025 年 5 月起,字節跳動的一家海外子公司在挪威北部的峽灣小鎮格洛姆菲尤爾租下了 2304 張英偉達 B200 芯片,那裡靠水電供能,常年低溫,字節這一筆訂單就佔了那家歐洲 neocloud 當年約四分之三的收入。
但所有人心裡都清楚,借來的屋簷躲不過長久的雨。
候鳥南飛,從來不是為了在南方定居。
兩家公司的 2025
同樣是面對算力圍堵,2025 年到 2026 年間,中國最具代表性的兩家大模型公司,Kimi 和 DeepSeek ,分別走了兩條路。
在南下找卡這條路上,月之暗面是最用力的一家。用一位知情人士的話說,他們在全球搜尋算力的姿態「非常 aggressive」。
2025 年 7 月,月之暗面發布 1 萬億參數的 K2,用自研的 MuonClip 優化器在 15.5 萬億 token 上走完預訓練。一年後的 2026 年 7 月 16 日,K3 正式發布,總參數量推高到 2.8 萬億,是全球首個開放權重的 3T 級模型。
美國 AI 學者 Nathan Lambert 在評測 K3 時專門提到,這個模型是「在一個 GPU 受限的環境裡」做出來的。他和 Kimi 的研究員聊天時,半開玩笑地提起在 OpenAI,一個普通研究員手頭可能有「幾千台 H100 等效機器」,對方「都震驚了」。
拿著遠少於矽谷同行的卡,中國團隊交出了讓大洋彼岸無法忽視的答卷。矽谷風投機構 Menlo Ventures 在 2026 年 11 月發布的企業級報告顯示,美國企業花在開源大模型上的錢,89% 流向了中國模型,其中 Kimi 一家就拿走了 61% 的份額。
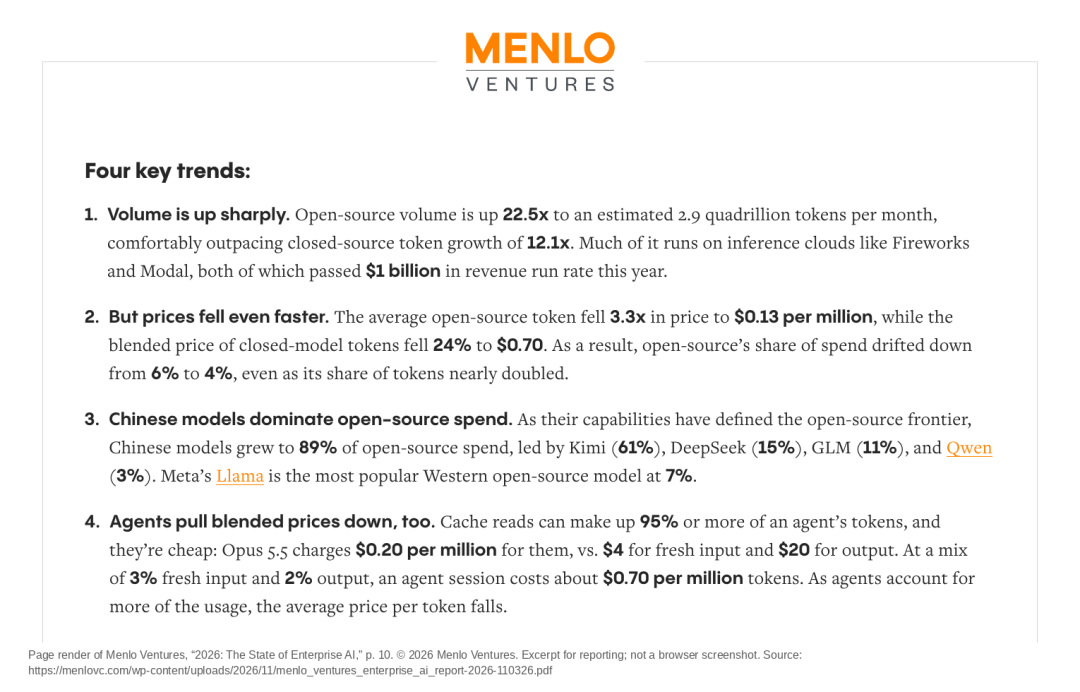
Menlo Ventures 2026企業AI報告|圖源:Menlo Ventures
模型太強,最直接的煩惱就是卡不夠用了。
K3 發布僅僅三天後,7 月 19 日,Kimi 官方貼出一則《關於算力緊缺與會員暫停開放的說明》,說過去 48 小時,用戶請求量已大幅超出預估,逼近現有集群的承載極限。新會員通道不得不臨時關閉,等新一批算力到位後再分批放號。
為了替推理集群減壓,月之暗面把能想到的辦法都用上了,他們在和幾家美國雲廠商合作託管 K3 的收入分成,利用開源權重的優勢,讓海外雲廠商用自己的 GPU 替 Kimi 接住海外企業客戶。
但下一代旗艦模型的預訓練,沒法靠分流解決。據 The Information 7 月底報道,規劃中的 K4 規模將比 K3 大得多。月之暗面把目光投向了印尼,簽下了一筆總價約 1.5 億美元的租約,預訂了一座印尼數據中心裡的英偉達 Blackwell Ultra B300 集群,計劃最早在 2027 年啟用。據報道,這批卡正是為 K4 準備的。
當月之暗面在東南亞四處找卡時,杭州的 DeepSeek 選擇了另一條路。
2024 年 7 月,梁文鋒在接受《暗湧》採訪時說過一句話:「我們面臨的問題從來不是錢,而是高端晶片被禁運。」
那年底,DeepSeek 發布 V3 ,在 2048 張 H800 上完成了訓練,折算下來最終一次訓練的成本僅約 557.6 萬美元。技術報告說,整個訓練過程「沒有遇到任何不可恢復的 loss spike ,也沒有做任何回滾」。
2025 年 1 月 20 日,DeepSeek R1 發布,憑藉強化學習帶來的推理能力震動全球。但在 R1 之後,當同行紛紛出海租卡時,DeepSeek 卻沒有把主力訓練搬出過國門。《金融時報》在 2025 年 11 月的報導中透露,DeepSeek 堅持在國內訓練,華為的工程師常駐在它的杭州總部。
留在原地的代價,是實打實的陣痛與等待。
2025 年,華為派了一支工程師團隊進入 DeepSeek 辦公室,協助它在國產昇騰晶片上訓練下一代推理模型 R2 。據《金融時報》報導,訓練撞上了穩定性、軟體和晶片間通信慢等問題,R2 的發布一推再推,多模態生成模型的訓練排期也相應後移。
外界當時只看到 DeepSeek 慢了下來,卻很少有人讀懂它在水下做的鋪墊。
2025 年 8 月,DeepSeek 發布過渡版本 V3.1 ,在發布說明裡寫道,該模型採用的 UE8M0 FP8 精度格式,是專門為「即將發布的下一代國產晶片」設計的。
2026 年 4 月 24 日,打磨良久的 DeepSeek V4 終於上線。公司在發布公告裡說受限於高端算力,V4-Pro 的服務吞吐有限,等下半年昇騰 950 超節點批量上市後,價格將會下調。
在 2026 年秋天的那個節點回看,一個四處找卡、把模型送進了全球開發者的工具鏈,一個留在國內死磕底層架構、替國產大集群趟雷。兩條路共同構成了中國 AI 在過渡期裡的雙翼。
直到華盛頓決定把海外那扇門徹底焊死。
下午 4 點 15 分
門是在 2026 年 11 月的前兩週裡,一扇接一扇關上的。
先是口頭吹風。11 月 3 日,《金融時報》披露,英偉達的銷售團隊開始口頭通知全球雲端服務合作夥伴,在新簽的合約裡,至少 51% 的產能必須賣給非中國客戶。這條要求沒有落在紙面上,卻讓東南亞的機房老闆們面面相覷,在美國以外,上哪兒去找那麼多非中國客戶?
第二天,11 月 4 日,甲骨文退掉了與騰訊在東南亞的一筆超級租約。那是一份為期五年、總價約 70 億美元、涉及約 10 萬張晶片的大單,告吹的原因是美國官員表示反對。
11 月 12 日,執掌英偉達 33 年的黃仁勳因風波辭去 CEO 職務。這位曾公開說中國 AI 「只落後美國幾納秒」、直言美國出口管制「在很大程度上適得其反」的華人企業家,在這個敏感的深秋離開了牌桌。
11 月 16 日,週一,美東時間下午 4 點 15 分,美國商務部工業與安全局將一份臨時最終規則遞進了聯邦公報系統,標題叫《Addressing Remote Access to Advanced Semiconductors》(應對先進半導體的遠端存取)。11 月 19 日正式公佈,當天生效。
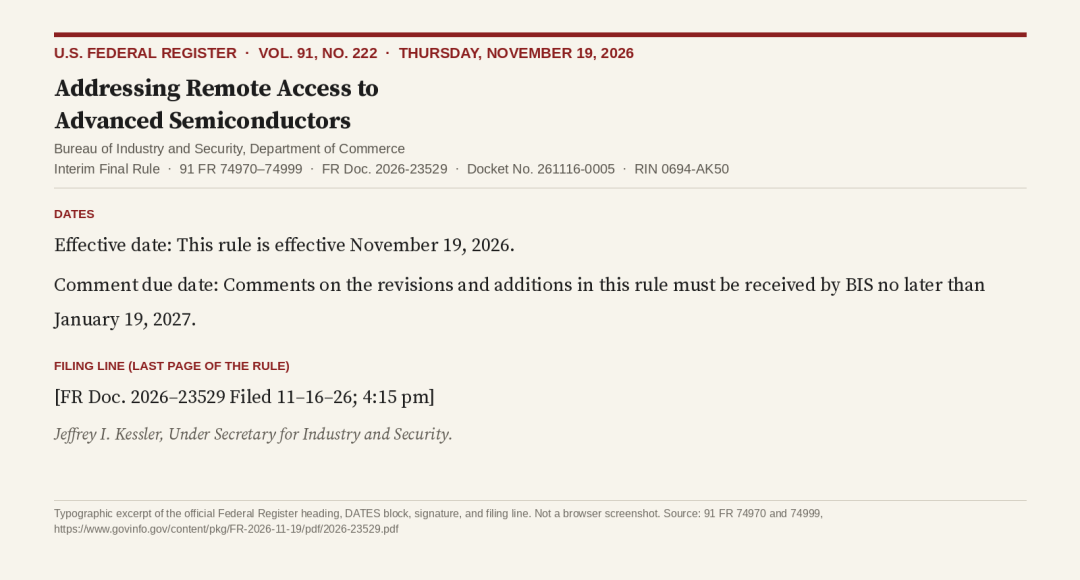
遠端存取先進半導體新規|圖源:政府官網
巧合的是,同一天,美國總統特朗普正在深圳出席 APEC 領導人非正式會議,會後稱讚他與中方領導人之間擁有「outstanding personal relationship」(出色的私人關係)。
新規的核心條款只有一條,全世界任何一座資料中心,只要給總部設在中國的公司(含其海外子公司)提供超過 1200 萬 TPP 的算力,向這座資料中心運送先進晶片就必須事先拿到美國商務部的許可證。
1200 萬 TPP 折算下來,大約相當於 750 張 H100 晶片,體量大約是四五個機櫃。
而訓練一個萬億參數級別的前沿大模型,起步就是幾千張乃至幾萬張卡。四五個機櫃,連塞牙縫都不夠。
對於目前已經在服務中國客戶的海外存量資料中心,新規給出了 90 天的緩衝期去申請許可證,否則「將面臨未來的出口限制」。從 11 月 19 日生效日起算,90 天大限正好落在 2027 年 2 月 17 日前後。
新規裡有一句推定條款,如果一座境外資料中心拒絕提供、或者提供不了客戶盡職調查資訊,這一行為本身就會被視為「Red Flag」,可以「推定」出口方「知情」。
換句話說,說不清機房裡跑的是誰的程式碼,就預設你有問題。
印尼、馬來西亞、新加坡、泰國、巴西五個國家被單獨點名,往這五國運送先進 AI 晶片一律需要許可審批;如果買家是美國總部的公司,出口方按月提交報告即可豁免。
物理斷供緊隨其後。11 月 17 日,輝達財報電話會上,接替黃仁勳出任臨時 CEO 的 Colette Kress 確認:「我們已不再向中國發運獲得許可的 Hopper 資料中心產品。」另據《金融時報》報導,台積電和三星也暫停了對部分中國客戶的出貨,等待許可。
中國商務部對此表示強烈不滿,宣布將採取反制措施;外交部發言人郭嘉昆直言,這是「典型的經濟脅迫和長臂管轄」。
50% 的押金
貿易規則落地的同一週,金融槓桿也開始收緊東南亞機房的錢袋子。
很多人以為東南亞遍地開花的 neocloud 背後站著揮金如土的財團,實際上,這是一門高度依賴債務的重資產生意。據彭博社統計,2023 年以來,亞太地區資料中心公司累計拿到的貸款約 490 億美元;一份半導體行業的研究簡報測算,neocloud 專案七到八成的資金來自債務,常見的做法是,機房業主拿著大客戶簽下的長期租約,向銀行貸款買輝達的卡,再用收上來的租金還本付息。
在這個鏈條裡,押金比例就是地緣政治風險的溫度計。
在海外算力市場上,一個普通客戶去租用輝達 B300 伺服器叢集,行業通行的押金比例在 15% 左右。
而月之暗面在印尼簽下那筆 1.5 億美元的 B300 租約時,為了鎖住這批 2027 年才能交付的卡,同意先付 50% 的押金。
到了 11 月初,據 CNBC 報導,月之暗面在歐洲洽談租用 8000 張以上 Blackwell 晶片時,甚至有人提出,它必須比非中國客戶多付 30% 到 50% 的預付款。
11 月 19 日的新規,直接讓這筆溢價失去了交易對手。
據 The Information 報導,新規出台後,月之暗面退掉了印尼那筆 1.5 億美元的合同,並暫停了其他新交易的談判。為 K4 準備的那批海外晶片,就此作罷。
比退租更麻煩的是銀行的抽貸。
11 月 17 日,彭博社曝出,新加坡雲服務商 Aolani Cloud 一筆 4.8 億美元的貸款被凍結。這筆錢原本要用來採購英偉達 GPU ,裝進馬來西亞一座為字節跳動服務的數據中心。據此前報導,兩家在馬來西亞合作的 B200 約有 3.6 萬張。這筆貸款的牽頭行是新加坡星展銀行,新規風聲一出,五家貸款方開始討論退出。
而另一家雲服務商 GMI Cloud 此前為了在泰國建設服務騰訊的算力設施,借了 3 億美元,貸款條款清單裡白紙黑字寫著一旦騰訊被列入美國限制名單,貸款方有權要求提前還款。
東南亞各國政府在合規高壓下紛紛後撤。馬來西亞投資、貿易及工業部長 Johari Abdul Ghani 對 CNBC 表態:「想留在牌桌上,就得守美國的規矩。」泰國商務部副部長公開表示,未獲美方批准的新建項目「可能無法完工」。新加坡數碼發展及新聞部與貿工部發表聯合聲明,「不容許公司借與新加坡的關聯來規避或違反他國法律」。
資本市場的反應很快,11 月 17 日當天,馬來西亞股市兩隻數據中心概念股盤中暴跌近 20%,公用事業巨頭 YTL Power 大跌近 10%。
而在同一天的中國香港市場,中芯國際大漲 7%。
其實,早在華盛頓關上大門之前,北京就已經開始主動引導產業往回走了。
2025 年 9 月,網信辦要求字節、阿里等公司停止採購和測試英偉達針對中國市場特供的 RTX Pro 6000D ;11 月,國資數據中心項目被要求只用國產晶片;甘肅、貴州、內蒙古等西部算力樞紐省份,對採用國產晶片的數據中心給予最高減半的電費補貼。到了 2026 年 1 月,美方有條件放行 H200 之後,國內海關告訴報關代理,H200「不准入」。
一邊是華盛頓給海外機房上鎖,一邊是國內堅定關上特供晶片的後門。持續了三年的外訓內推,在太平洋兩岸的雙向切割下,走到了頭。
卡被用戶吃掉了
把視線轉回國內。要理解 2026 年底這場大遷徙的緊迫感,得先看清國內實驗室正在經歷的另一種甜蜜而痛苦的煎熬。用戶增長得太快,把研發用的卡都吃掉了。
2026 年 3 月 4 日凌晨 0 點 11 分,阿里 Qwen 技術負責人林俊暘在 X 上發了簡短的一行英文:「me stepping down. bye my beloved qwen.」
林俊暘的離開,官方口徑是權責調整分歧,算力只是背景。但兩個月前他在一場行業對話裡倒出的苦水,道出了許多一線技術負責人的共同焦慮,他說光是應付日常的交付,就已經吃掉了團隊絕大部分算力,真正留給前沿探索的卡捉襟見肘。
字節跳動內部同樣在經歷這種拉扯。
到了 2026 年 8 月,據《晚點 LatePost》報導,字節內部曾認真討論過訓練一個 5 萬億參數以上的超級模型,盤點完家底後發現,現有的算力儲備「難再支撐多線並行的研發」,Seed 團隊隨後啟動內部架構收斂。
為什麼連字節和阿里這樣最不差錢的巨頭,都會覺得卡不夠用?
因為 2026 年是中國 AI 應用真正走進國民日常生活的一年。春節過後,字節旗下豆包的日活用戶一舉突破 2 億大關。高日活帶來的是高昂的推理成本和運維壓力,以至於向來擅長買量投流的字節,據 36 氪報導,今年豆包的投流預算很低,再繼續拉新,推理的卡就更緊張了。
在大模型行業,預訓練和日常推理搶的是同一池子算力。用戶用得越起勁,留給下一代模型訓練的卡就越少。
這種「幸福的煩惱」,在創業公司身上體現得更加驚心動魄。
2026 年 2 月 16 日,智譜 AI 的旗艦模型 GLM-5 發布後,湧入的並發請求衝破了既定規劃上限。儘管智譜此前已經幾次擴容國產晶片集群,也限售了 Coding Plan 套餐,線上服務依然出現了排隊和卡頓。智譜不得不公開徵集晶片廠商、算力夥伴和推理服務商。
不自建機房、靠向雲廠商採購的 MiniMax ,也在急劇追加預算。2026 年 8 月 26 日,MiniMax 與阿里雲簽署補充協議,將 2026 年至 2028 年三年的年度採購上限,從原定的 1.15 億、1.25 億、1.35 億美元,一口氣上調至 3 億、4 億和 5 億美元。創始人閆俊傑在一檔海外播客裡坦言:「對於我們而言,尤其是對於一家中國 AI 公司來說,算力始終是一種約束。」
到了 9 月,連一向以工程效率著稱的 DeepSeek 也開始引導用戶分流。它將原本調用 V4-Pro 的請求轉給新發布的 V4.1-Flash 。11 月 16 日,「DeepSeek使用額度已達上限」衝上微博熱搜,不少重度用戶連續對話不到兩個小時就碰到了上限。
看懂了這層供需關係,就能理解為什麼 2026 年下半年國內的空氣裡總有一種微妙的蓄力感。
這幾個月裡,各家的小版本和 Flash 模型密集迭代,唯獨超大參數的旗艦紛紛放慢了腳步。智譜在 8 月 31 日官宣了 GLM-6 ,沒有給出具體上線日期;MiniMax 約 3 萬億參數的 Pro 版本,據報導原計劃三季度亮相,至今未見;DeepSeek 發了 V4.1-Flash ,還沒有 V4.1-Pro 。
與此同時,兩年前那種不計成本的 API 價格戰徹底熄火,據統計,2026 年二季度,國內大模型 API 的平均輸入價格比 2025 年一季度高出約 48%,輸出價格高出約 80%;DeepSeek 高峰時段的輸出價格,漲到了原來的 4.5 倍。
朱嘯虎曾斷言:「今年,可能是基礎大模型的最後一年。」
但在我們看來,這個結論恰恰把因果倒置了。
旗艦模型放慢發布節奏、API 價格回歸理性,從來不是因為基礎模型摸到了天花板,而是因為中國大模型走出實驗室、真正進入了數以億計的真實場景和全球開發者的工具鏈。
研究機構 Epoch AI 統計,2022 年至 2026 年年中,全球新增的 AI 算力裡,中國拿到的份額只有大約十分之一;但全球最大開源社區 Hugging Face 的統計顯示,2025 年 2 月至 2026 年 2 月間,全平台四成以上的模型下載量來自中國團隊研發的模型。
用全球十分之一的增量算力,撐起了全球四成以上的開源模型下載和國內數億人的日常調用。
不僅如此,算力的剛性約束,反而逼出了中國工程師在架構優化與系統工程上的硬功夫。財新引述的一位業內專家判斷,經過 harness 深度調優的小模型,能用大約 4% 的成本,拿到大模型接近 90% 的能力。
正如 SemiAnalysis 的 Dylan Patel 在 11 月新規落地前幾天所評價的那樣:「論能力,月之暗面大概和美國實驗室一樣好,他們只是在算力和部署上有很大缺口。」
現在,這群最懂得如何省著用卡的工程師,要集體搬回國產晶片的地基上了。
精度對齊
從英偉達的 CUDA 生態搬回國產算力底座,不是發一紙行政命令就能完成的搬家,它首先是一場極其硬核、細緻到每一個比特的底層工程攻堅。
在晶片和框架工程師嘴裡,回家之後的第一道鬼門關,叫「精度對齊」。
理想狀態下,同一個模型架構、餵進去同一批訓練數據,放在英偉達的 GPU 上跑和放在華為昇騰的 NPU 上跑,畫出來的兩條 loss 下降曲線,應該像兩頁描紅紙一樣嚴絲合縫地疊在一起。
但在真實的工程世界裡,只要底層硬體的數值精度或者通信算子的歸約順序有一丁點差異,兩條曲線就會差很多。
科大訊飛是最早把這套苦功夫啃下來的中國公司之一。
在 2026 年 4 月的投資者關係活動記錄表裡,訊飛把兩代硬體的客觀差距擺了出來,當時主力使用的昇騰 910B 單卡顯存是 64G ,而英偉達 H200 是 141G ;顯存帶寬一邊是 1.6TB/s ,另一邊是 4.8TB/s 。開箱狀態下,訊飛在 910B 集群上的訓練效率,只有同規模英偉達 A800 集群的 30% 左右。
訊飛跟華為深度合作,一個算子一個算子地重寫、調優。2025 年裡,他們硬是把長思維鏈強化學習的訓練效率從 30% 拉升到了 84%,昇騰原生 MoE 模型的全鏈條訓練效率提到了 93%。即便如此,客觀的適配週期依然存在,訊飛在記錄中寫道,當國際上冒出一種新的主流算法時,在 N 卡上直接就可以做,在國產卡上卻需要額外解決算子庫效率優化等一系列問題,通常要多花 3 到 6 個月的適配週期。
2026 年 10 月,科大訊飛董事長劉慶峰說:「我們並不希望訊飛是唯一一個在國產算力上做訓練的。」
劉慶峰沒有等太久。當年選擇留在原地的 DeepSeek,在這個秋天把這條路往前鋪了一大段。
回過頭看,DeepSeek 在 2025 年經歷的那次 R2 遷移挫折,非但不是一次潰敗,反而成了整個中國大模型行業最寶貴的一次投石問路。
2026 年 4 月 DeepSeek V4 發布當天,昇騰芯片就在第一時間實現了推理支持,其專家並行的核心 kernel 在英偉達和昇騰兩套硬件上都完成了驗證。到了 7 月,一支由華為牽頭、深圳河套學院等機構參與的攻關團隊對外披露,他們在約 1000 張昇騰 910C 組成的集群上,完整跑通了 DeepSeek V4-Pro 1.6 萬億參數模型的全參數後訓練,連續運行約一個月,迭代 1500 多步,全程「無跳步無NaN」,模型算力利用率穩定在 34.9%,每一步耗時 27 秒。
9 月 30 日,國慶節前一天,DeepSeek 正式宣布開源一整套面向昇騰平台的底層核心組件,從 TileLang 編譯工具、計算庫到分布式通信庫,與英偉達版本一一對應。
為了遷就國產芯片的內存訪問特性,DeepSeek 甚至主動修改了自己招牌的 FlashMLA 注意力實現裡的 KV cache 內存布局,把數值和縮放因子打包存在一起,只為了讓昇騰芯片少搬幾趟內存。
在過去的矽谷範式裡,永遠是模型公司順著英偉達定義好的硬件架構寫代碼;而在 2026 年的杭州,頂尖模型實驗室開始為了國產芯片的特性,主動重構自己的底層算子。
不僅如此,華為與 DeepSeek 還在聯合共建基於昇騰 950 的 128 卡超節點。
SemiAnalysis 的實驗室在今年點亮並實測了一張華為昇騰 950PR 測試芯片。功耗 203.3 瓦,核心溫度 56 攝氏度,板載 128GB HBM 高帶寬內存只用了 5GB 出頭;滿載運行時功耗約 600 瓦,在最考驗硬實力的計算密集型矩陣乘法上,它的實測利用率能跑到理論上限的 41.5%,作為對比,英偉達經典的 H100 是 46.8%。
除了 DeepSeek ,整支中國大模型艦隊都在完成底層代碼的換血。月之暗面的 Kimi K3 從監督微調階段起就引入了量化感知訓練;智譜的 GLM-5 在發布第一天,就同步完成了對華為昇騰、寒武紀、海光、崑崙芯等七家國產芯片的適配;在各大實驗室的代碼庫裡,純 CUDA 算子越來越少,TileLang 這類跨平台的寫法越來越多。
太平洋兩岸的兩棵科技樹,正在從最底層的精度格式和內存佈局上,長出各自獨立的根系。
烏蘭察布的冬天
2022 年 2 月 17 日,國家發改委等四部門聯合印發文件,在京津冀、長三角、粵港澳大灣區、成渝、內蒙古、貴州、甘肅、寧夏 8 個地區啟動建設國家算力樞紐節點,並規劃了 10 個國家數據中心集群,「東數西算」工程從那一天全面啟動。
歷史有時會有驚人的巧合。差不多整整五年後的同一天,2027 年 2 月 17 日前後,恰好是美國新規給海外存量數據中心畫下的 90 天大限。
五年前,當文件裡寫下和林格爾、慶陽、貴安、中衛這些西部與北方地名時,很多人以為那只是一項常規的能源調配工程,東部的土地和能源越來越緊,而西部和塞北有吹不完的風、曬不完的太陽。
五年後,當海外的機房大門關上,人們抬頭才發現,承接中國 AI 北歸的基地,已經在北方的草原、黃土塬和西南的山洞裡提前鋪開了。
在甘肅慶陽,昔日的黃土塬上立起了一座座智算中心,阿里千問、智譜和 Kimi 的訓練與推理任務在這裡晝夜吞吐。
在貴州貴安,騰訊把核心數據中心直接建進了山洞裡,厚重的岩體一年四季恆溫 15 攝氏度;華為雲新增的昇騰卡有八成以上運往了貴安,這裡也有華為最大規模的 CloudMatrix384 昇騰超節點部署。半個多世紀前,貴州的崇山峻嶺裡藏著轟鳴的三線工廠;半個多世紀後,同一片大山裡,裝進了一排排閃爍著指示燈的國產算力。
在內蒙古和林格爾,今年 10 月 14 日,全球首個昇騰 950DT 萬卡池正式宣布,當時正在系統聯調,單棟機樓就能裝下 3 萬卡的集群。
而在這場向北的大遷徙中,最繁忙的驛站,叫烏蘭察布。
烏蘭察布在蒙古語裡意為「紅色的山口」。它距離北京約 350 公里,坐高鐵不到兩個小時就能到。這裡海拔高,年平均氣溫只有 4.3 攝氏度,一年裡很長一段時間,可以直接用室外的冷空氣給機房降溫。
城南起伏的草原上,數據中心一座挨著一座。遠景科技集團在這裡建設的「星河」園區總規劃達 800MW ,首期 120MW 在一年內就完成了交付,建造成本只有美國同類項目的五分之一。
烏蘭察布過去出名的一種作物是土豆。遠景創始人張雷說,他想讓大模型的 token 變得「像土豆一樣便宜」。
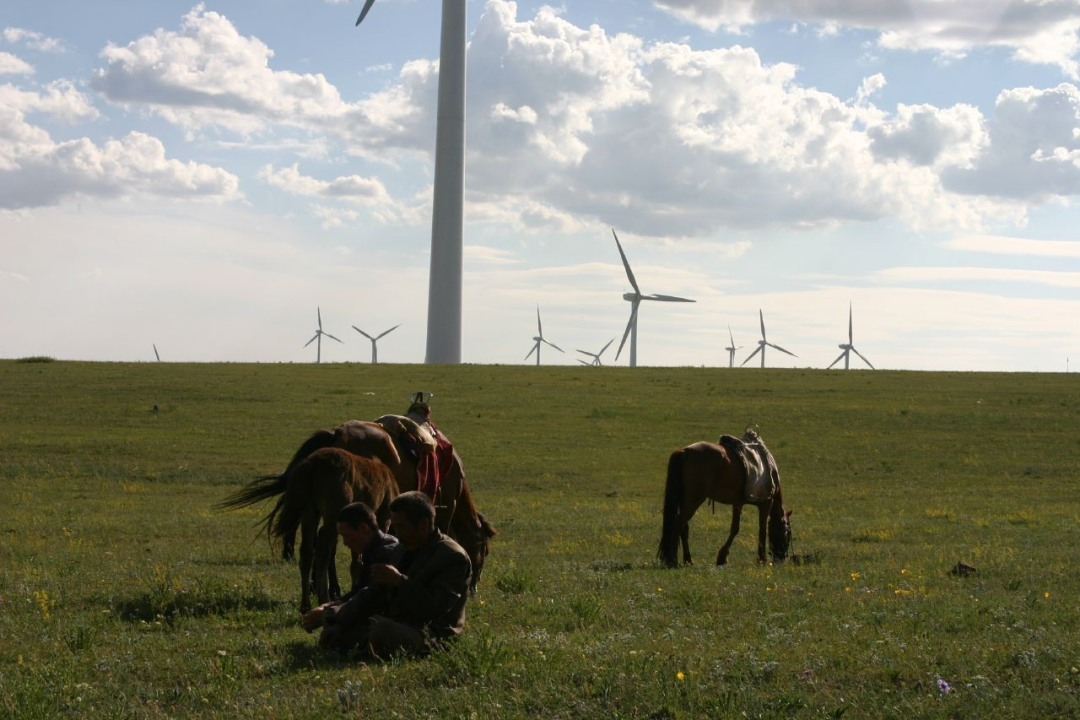
2007年夏季輝騰錫勒草原風電場|圖源:Steven Buss
11 月下旬的烏蘭察布,夜間氣溫常常下降到零下十度。塞北的風掠過城南的草原,推著上百米高的風機緩緩旋轉,電流順著輸電線路匯入恆溫恆濕的機房,點亮一排排剛剛上架的機櫃。
南方柔佛海峽濕熱的雨季還在繼續。
按照節令,候鳥要等到來年開春才會北歸;這一次,算力走在了它們前面。
-END-
原文連結
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章