融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


AI算力金融化:開源模型正在將算力推向資本市場(上)
本文为 OKX Ventures 出品的深度研究报告。由于篇幅较长,分为上下两篇发布:上篇聚焦算力资产化、风险敞口与衍生品定价逻辑;下篇将重点分析算力金融基础设施、推理资产化机会及行业趋势。本篇为上篇。
引言:算力的资产化与风险敞口
AI 基础设施正在进入资本密集型扩张阶段,算力的经济属性也随之改变。过去企业更多将算力视为按需采购的 IT 成本;现在,GPU、数据中心容量和多年期采购合同越来越多地进入资产负债表,算力开始具备资本资产的特征:前期投入大、资金回收需要几年,未来收入和设备价值又会持续受到供需和技术迭代影响。
GPU 采购和数据中心建设也越来越依赖债务资金。今天的 GPU 授信已经可以依靠设备抵押和长期客户合同完成融资,但市场仍缺少公开、标准化的 GPU-hour 远期价格和对冲工具。债务需要按既定节奏偿还,而几年后这批 GPU 能收多少租金、还能值多少钱,都取决于届时的市场。杠杆越高,这种价格不确定性对偿还债务和再融资的影响就越大。
一、背景:算力市场资本结构
1.1 算力扩张开始进入杠杆阶段
过去几年,AI 基础设施最值得关注的变化之一是资本支出开始快于企业内部现金流的扩张。2020–2023 年,前 5 云服务提供商的 AI 相关资本支出占经营现金流的比例大致仍在 20%–30%,到 2025 年已经接近 94%。进入 2026 年,前 5 家云服务提供商已确认的资本支出规模总计超过 7000 亿美元。
这些公司仍然拥有很强的现金创造能力,但当基础设施建设长期以数千亿美元规模扩张时,债务资本自然会承担更大的角色。算力资产开始形成一套独立的融资逻辑。
GPU、服务器和数据中心需要在收入发生之前投入资金,而 Neocloud 等算力运营商通常没有 Hyperscaler 那样成熟的主体信用。放贷方因此逐渐把融资判断落到项目本身:未来现金流是否足够稳定,能否覆盖债务本息,违约以后又能回收多少资产价值。
Take or Pay 長約是這套結構能夠成立的關鍵。客戶即使沒有完全使用已經預訂的容量,也需要按照合同支付約定費用。對於運營商,這相當於提前鎖定一部分未來收入;對於貸款人,它把高度不確定的 GPU 利用率,轉換成了一條更容易預測的合同現金流。
CoreWeave 是這套模式最典型的案例(其超過98%的收入來自Take or Pay條款合同)。隨著投資級客戶的多年期合同占比提高,其融資越來越依賴承購方信用和合同覆蓋率。Nebius、IREN 等擁有大型客戶長約的運營商隨後也開始採用類似結構。
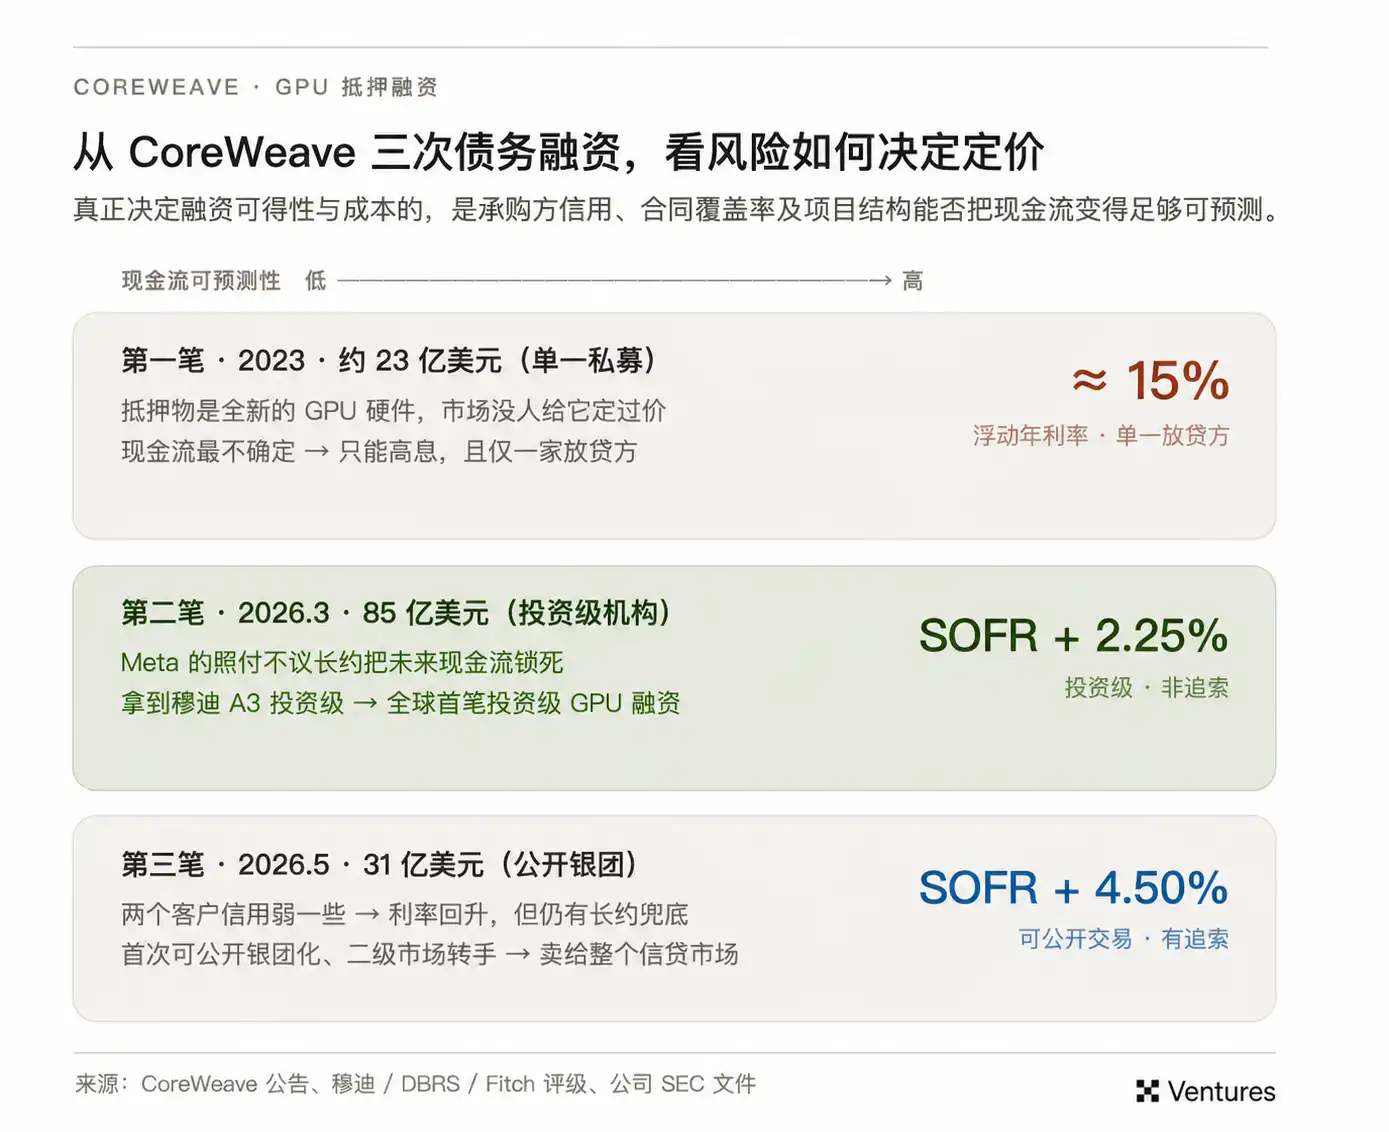
這改變了 GPU 信貸的風險排序。貸款人首先判斷看合同現金流能否覆蓋債務,最後評估違約以後 GPU 能回收多少。GPU 數量決定抵押物規模,長期訂單進一步決定這批資產能夠獲得什麼樣的融資條件。
1.2 現金流被鎖定後,剩下的是資產價格風險。
Take or Pay 提高了償債現金流的可見性,GPU 本身的經濟價值仍然會持續變化。幾年以後,這批設備還能產生多少收入、值多少錢,依然是留在資產負債表上的風險。
GPU 同時具有生產設備和技術產品兩種屬性。它能夠持續產生租金,卻又處於極快的技術迭代周期。新一代芯片推出以後,上一代設備受到的影響會逐漸反映在租金、利用率、續約價格和二手市場價值上。
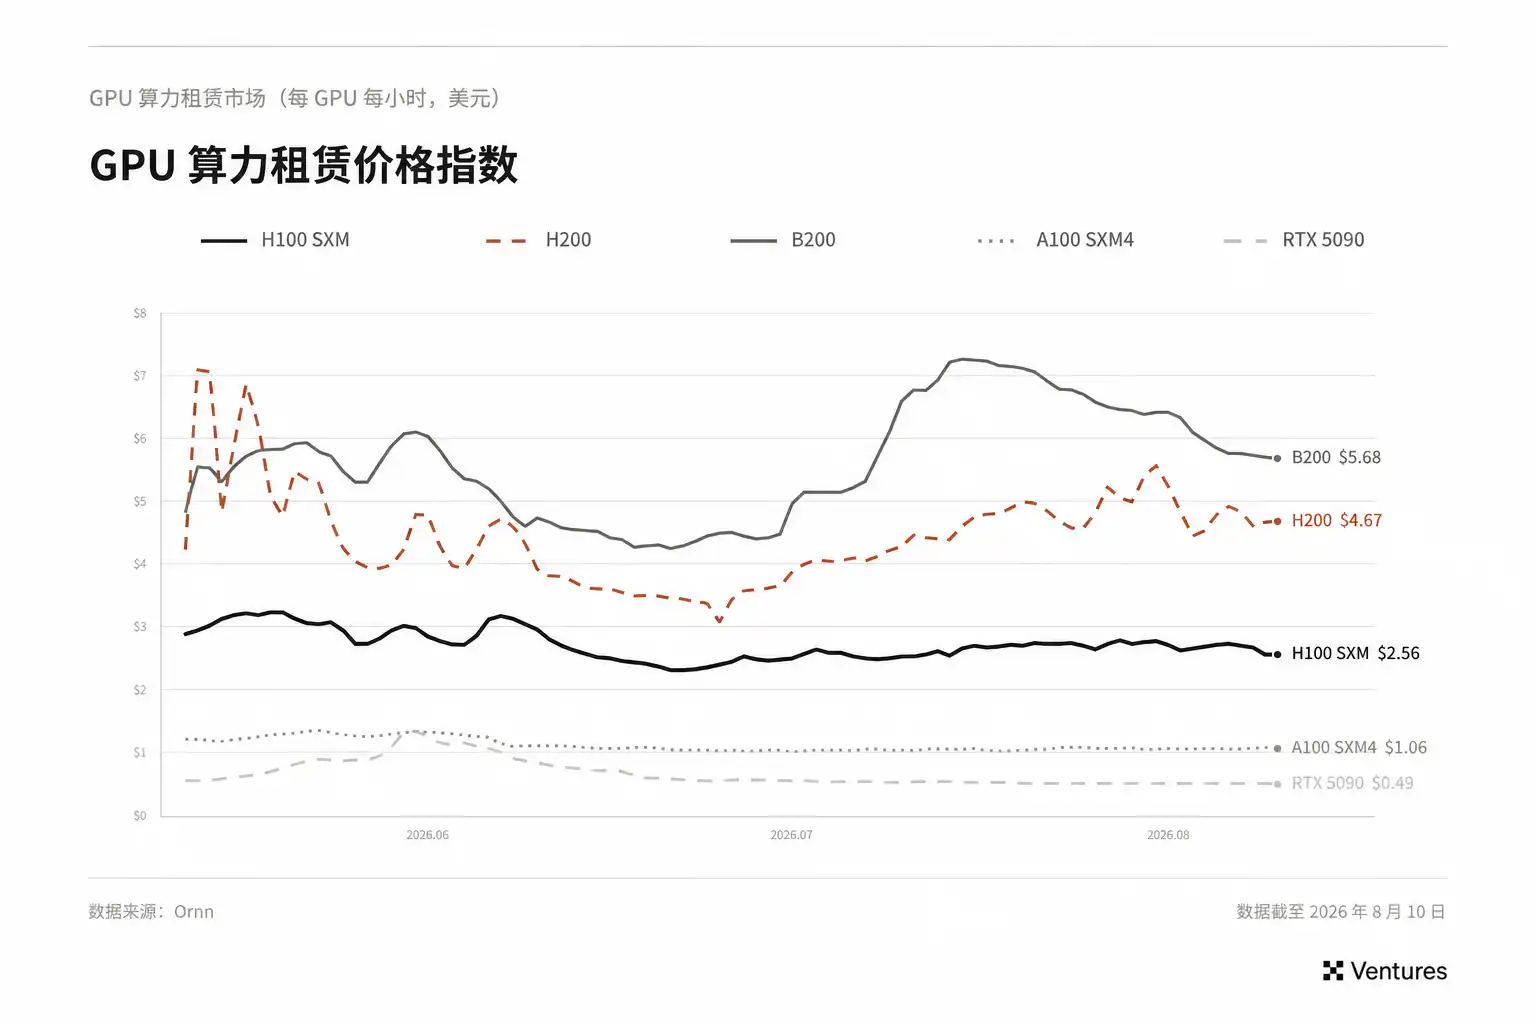
因此,GPU 的會計折舊和經濟折舊很難完全一致。會計可以按照固定年限攤銷設備成本,市場每天都在重新判斷一張 GPU 還能生產多少具有競爭力的算力。對於貸款人,核心變量最終會落到剩餘貸款期限內的現金流,以及違約時能夠回收多少價值。(圍繞大型雲廠商的數據中心資產折舊政策,市場已經出現質疑)
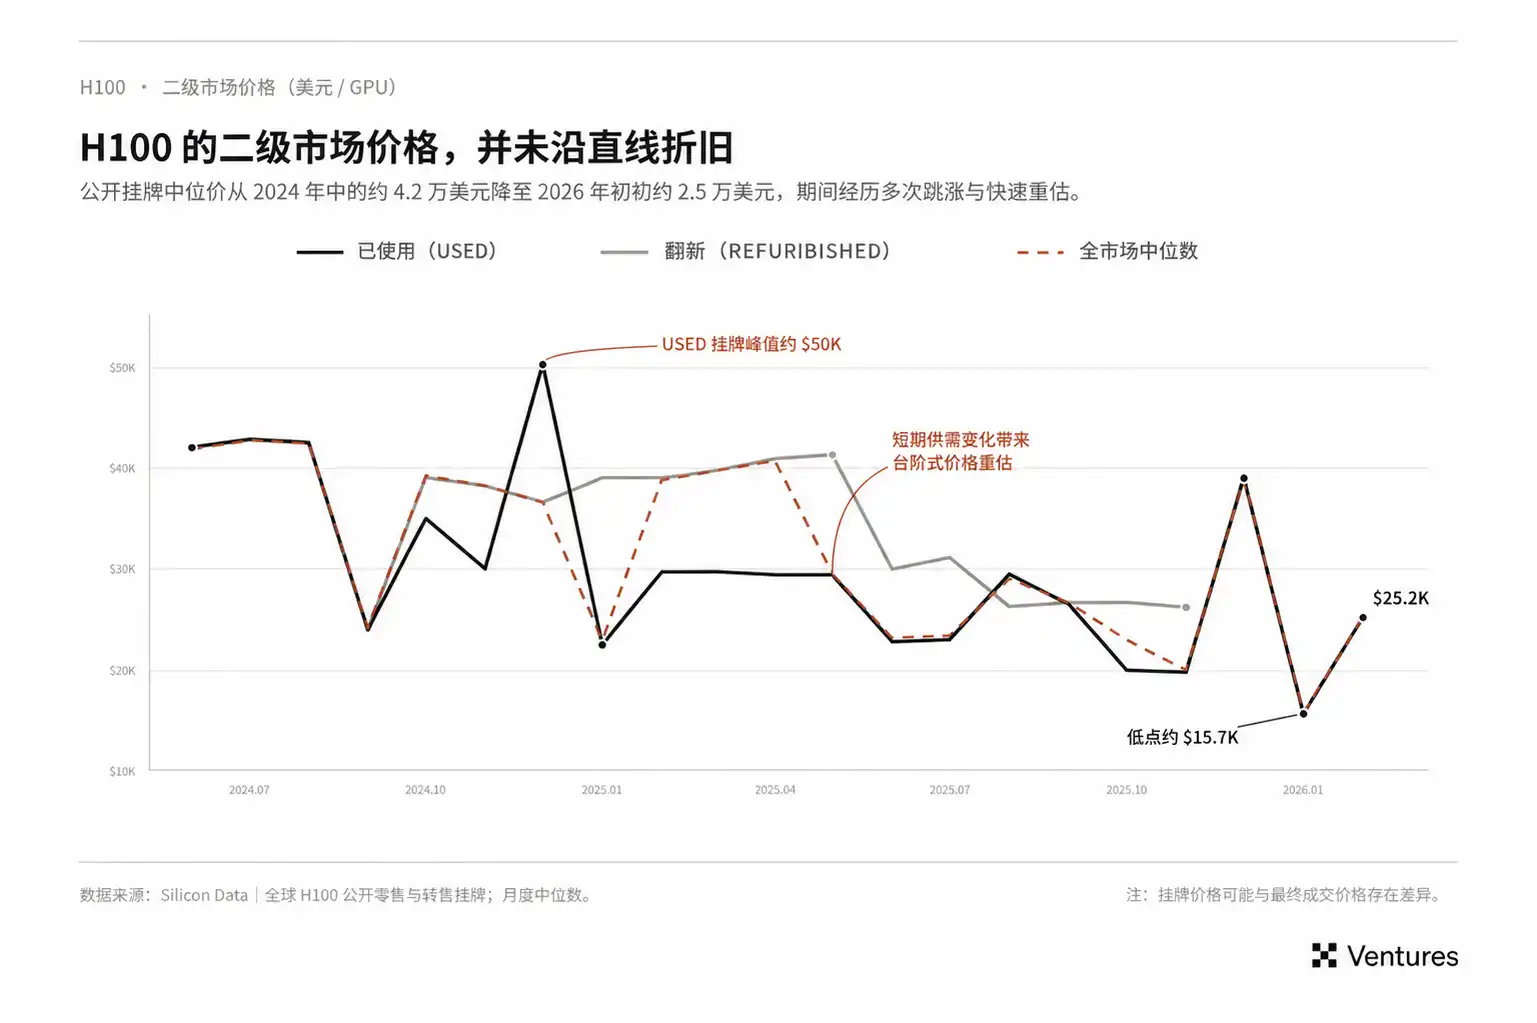
這也解釋了為什麼當前 GPU 信貸可以在租金下跌時暫時保持穩定。只要承購客戶繼續履約,現貨價格變化未必立刻影響當期償債;風險更多會集中在合同續約、再融資和違約處置幾個節點。到了這些時點,GPU 的市場租金和殘值會重新決定貸款的安全墊。
如果租金和設備價值下降得比貸款本金攤還更快,LTV 會重新上升,貸款的安全垫隨之收窄。長期合同可以把風險向後推,卻無法鎖定設備整個生命周期內的經濟價值。
當前算力信貸結構的缺口也因此很清楚:合同鎖住了部分客戶付款,GPU 的市場價格仍然浮動。
市場目前主要依靠多年期容量合同提前鎖價。早期 H100 一年期合同相對現貨存在明顯折價,而隨著現貨價格下行、遠期合同價格回升,兩者價差已經大幅收窄。供給改善和合同條款變化都會影響這一結果,但它同時反映出一個更基礎的問題:在缺少標準化遠期、期貨和掉期工具的情況下,產業參與者只能讓長期實體合同同時承擔採購和價格管理兩種功能。
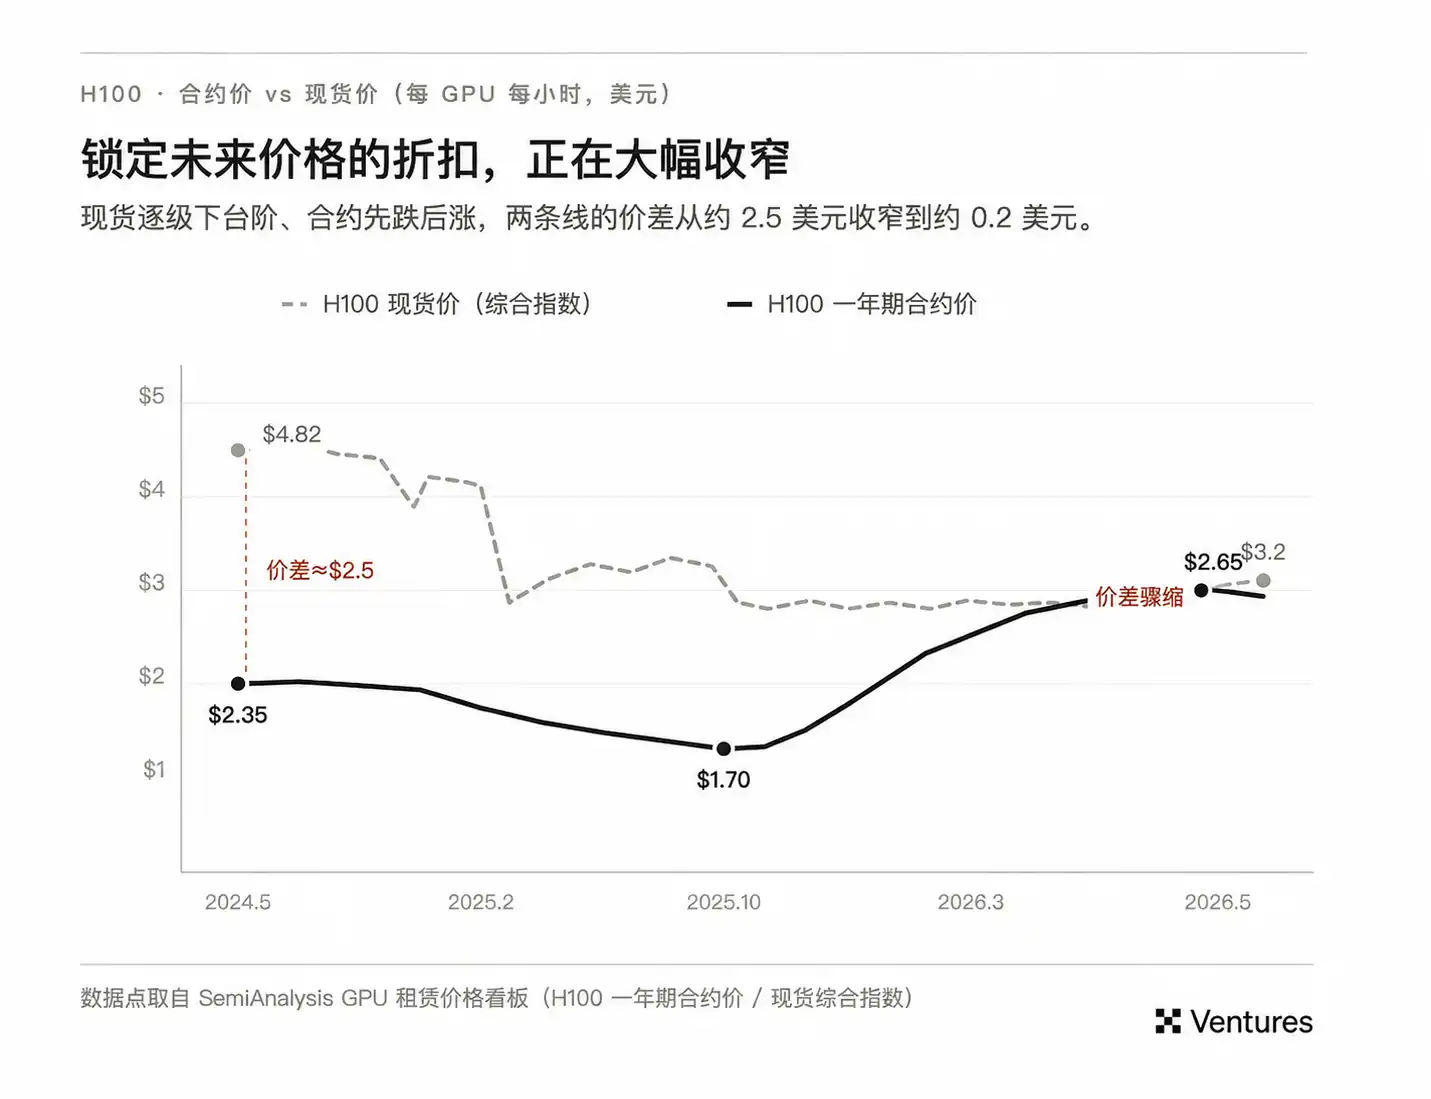
長約可以完成單個交易雙方之間的風險分配;當市場需要持續形成公開價格、跨機構轉移風險時,就需要進一步的標準化金融工具。 隨著越來越多 GPU 資產由債務資本支撐,這一需求會越來越明顯。
二、算力市場真正需要交易的是什麼?
算力一旦進入資本結構,價格波動就開始有了明確的承擔方。Neocloud 持有租金下跌風險,AI 公司持有採購成本上漲風險,債權人持有殘值和再融資風險。衍生品市場往往就是從這些資產負債表無法自行消化的風險開始真正形成。
2.1 三類參與者與風險敞口
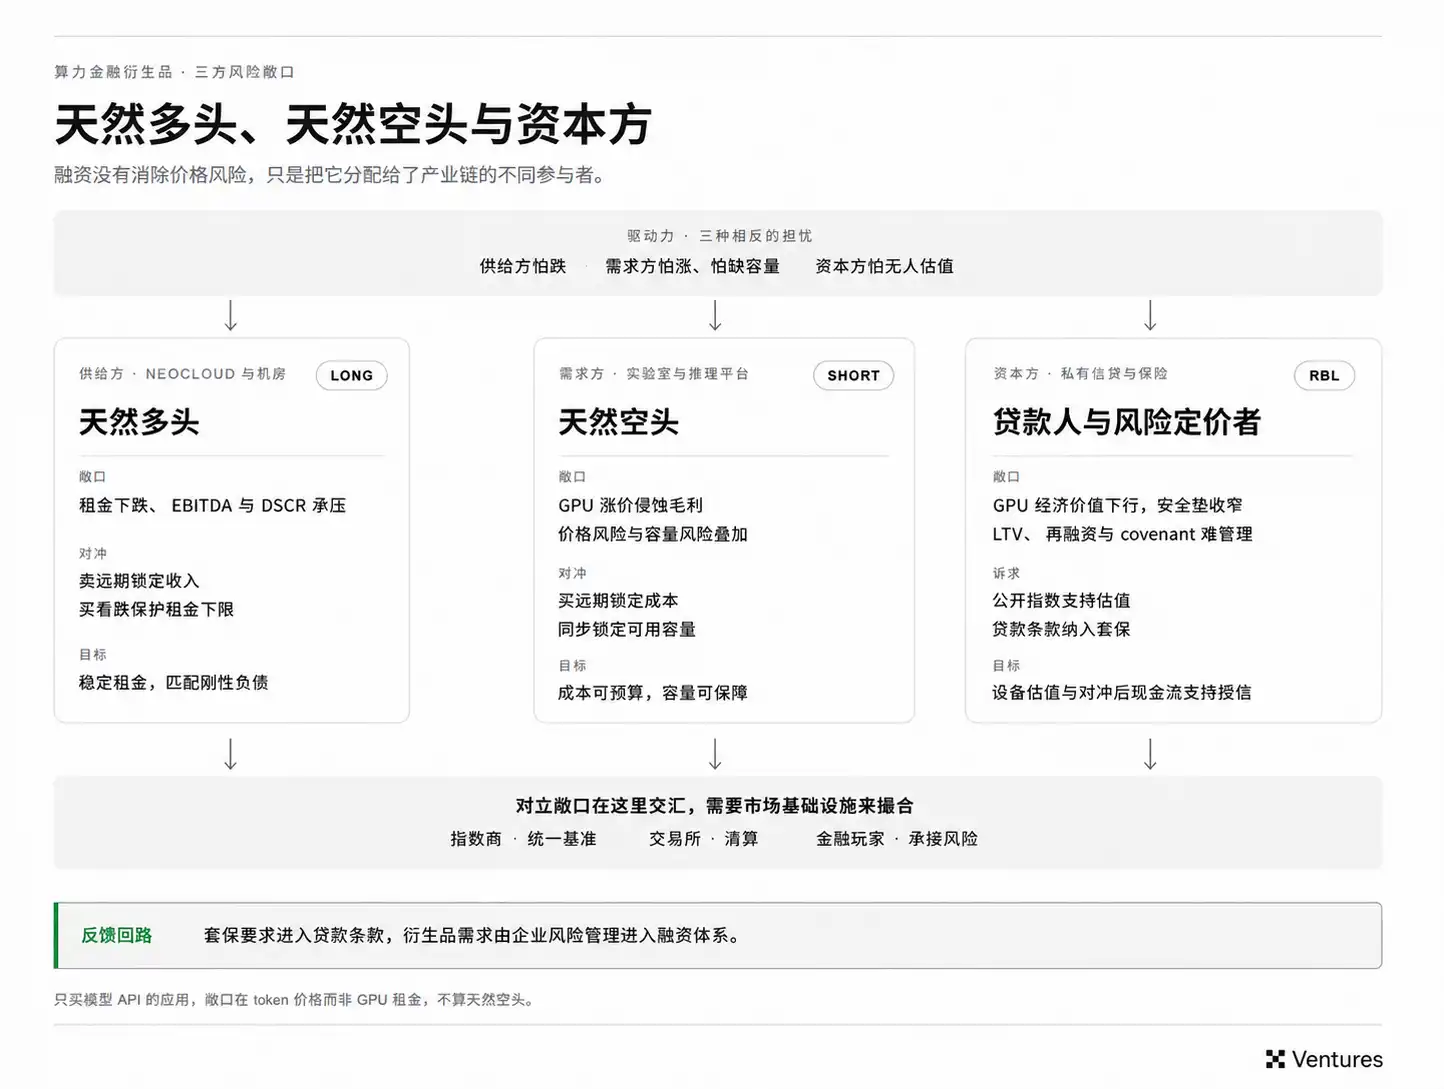
算力價格波動最終會落到三類資產負債表上。Neocloud 前期鎖定 GPU、機房和融資成本,未來租金仍會重新定價;長約覆蓋不足時,租金下跌會很快壓縮 EBITDA 和 DSCR,因此最有動力賣出遠期、提前鎖定收入。AI 實驗室和推理平台處在另一側,GPU 漲價會直接侵蝕毛利,而且市場緊缺時價格和容量風險往往同時出現,因此它們需要同時鎖定成本和可用容量。貸款人更關心貸款餘額與 GPU 經濟價值之間還剩多少安全垫,缺少公開指數和遠期曲線,LTV、再融資和 covenant 都很難動態管理。隨著套保要求逐漸進入貸款條款,算力衍生品的需求也會從企業主動管理風險,進一步進入融資體系。
2.2 潛在市場規模:哪些風險敞口會進入衍生產品市場
如果直接用全球 GPU 出貨量、數據中心 CapEx 或 AI 基礎設施規模估算算力衍生產品 TAM,結果很容易高出一個數量級。
真正能夠進入衍生產品市場的,是仍然暴露在市場價格下、又沒有被其他方式吸收掉的那部分風險。
Hyperscaler 自建並內部使用的 GPU,很大一部分風險留在自己的資產負債表裡;已經簽下多年固定價格合同的容量,價格風險也提前在雙邊合同中完成了分配。它們都有經濟風險,但未必需要每天進入市場交易。
因此,從全球算力需求到真正的衍生產品 TAM,中間至少要經過幾層過濾:
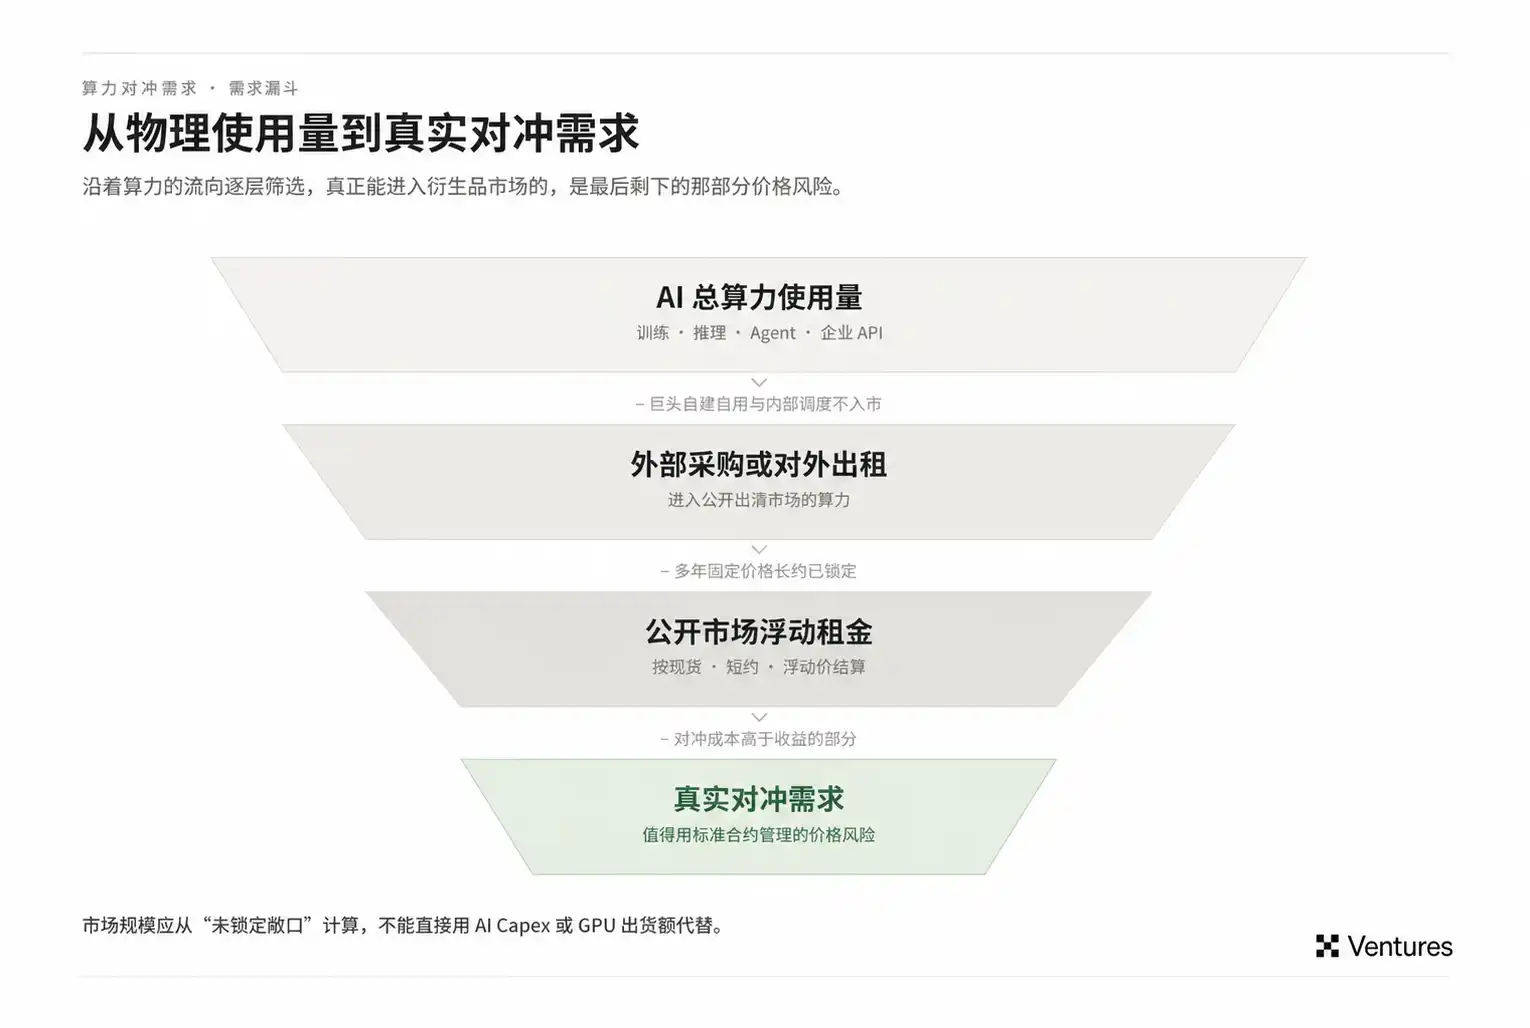
這也是為什麼未來算力衍生產品市場的大小,很可能和merchant compute 的佔比關係更大,而不是和全球 GPU 裝機量簡單線性增長。
過去大量先進模型運行在少數大型實驗室和 Hyperscaler 內部,算力採購同樣高度內部化。隨著開源模型性能提升,越來越多企業可以自行部署,或者把 workload 交給第三方 Neocloud 和推理平台。原本封閉在幾個大資產負債表裡的算力需求,會逐漸轉化成公開市場上的採購訂單。這也解釋了為什麼開源模型的發展值得關注:
第一,更多算力開始形成真實成交價格。 沒有足夠多的外部交易,指數很難形成,遠期曲線更無從談起。
第二,需求衝擊會更快傳導到現貨市場。 一個熱門模型發布以後,如果大量企業同時增加部署,新增需求會直接衝擊第三方 GPU 容量,價格和可用率會快速變化。公開市場承擔的邊際需求越多,租金波動越有可能成為企業真正需要管理的 P&L 風險。
所以開源模型對算力金融化真正重要的地方,在於它可能提高市場化採購的比例。算力只有經過足夠多的外部交易,才會逐漸形成一個值得被指數化、遠期化和金融化的價格。最終決定算力衍生產品市場規模的變量包括 1) 多少算力進入公開市場,2) 多少價格保持浮動,以及3) 其中多少風險無法繼續留在原來的資產負債表上。
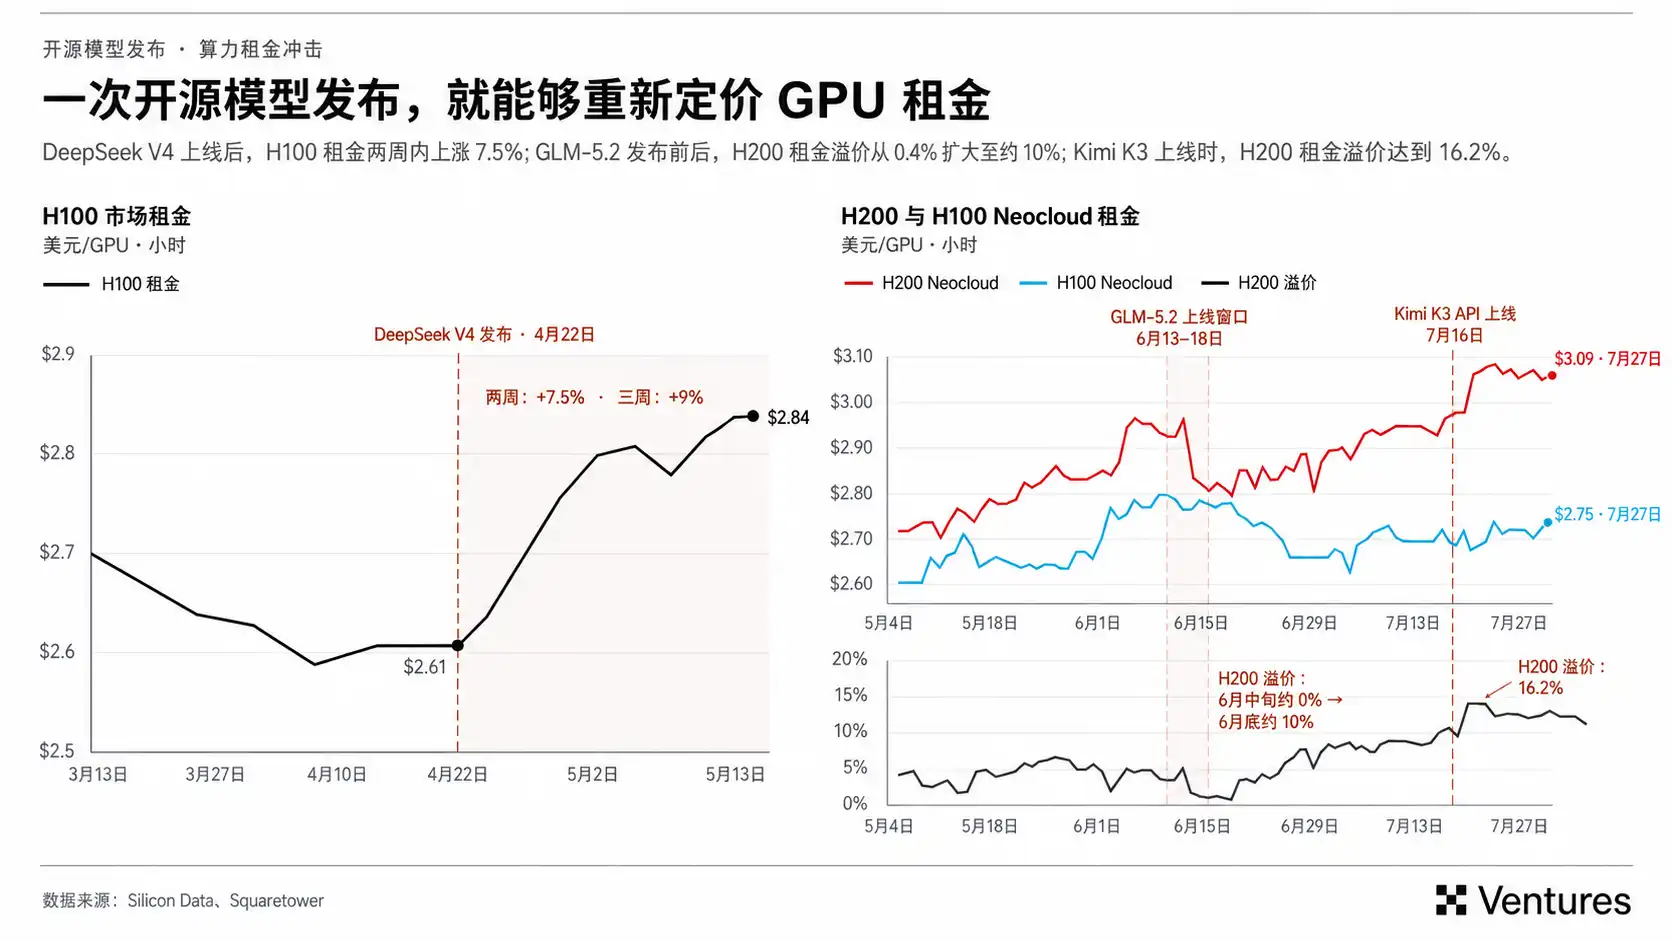
DeepSeek V4 發布後,H100 租金在兩週內上漲約 7.5%;Kimi K3 和 GLM 5.2 上線前後,H100、H200 租金也出現類似的走強趨勢。熱門開源模型會在短時間內帶來大量部署和推理需求,當這些新增負載主要由 Neocloud 和第三方推理平台承接時,市場往往先出現可用率下降、排隊和配額收緊,隨後反映到按需租金。
三、 產品與定價:如何給未來算力定價?
算力遠期的難點在於,市場還沒有形成一條足夠可信的期限價格曲線。
GPU-hour 無法儲存。今天閒置的一小時 H100,過了這個時間窗口就永久消失,也無法在現貨便宜時提前買入、留到半年以後交割。傳統商品依靠庫存套利建立起來的現貨—遠期約束,在算力市場裡天然弱很多。
這意味著六個月後的 GPU 應該以什麼價格成交,會更依賴屆時的晶片交付、機房和電力供應、模型效率以及真實訂單強度。硬體延期可以迅速收緊未來容量,軟體優化又可能在不增加 GPU 數量的情況下釋放大量有效算力。一條算力遠期曲線同時包含了市場對硬體供應、能源約束和演算法進步的判斷。
3.1 沒有庫存套利,遠期價格更依賴預期和訂單流
原油市場的期限結構有比較穩定的倉儲套利約束。當遠期價格明顯高於現貨價格加融資和倉儲成本時,交易者可以直接買入現貨、持有庫存並賣出遠期,價差因此很難長期脫離持有成本。
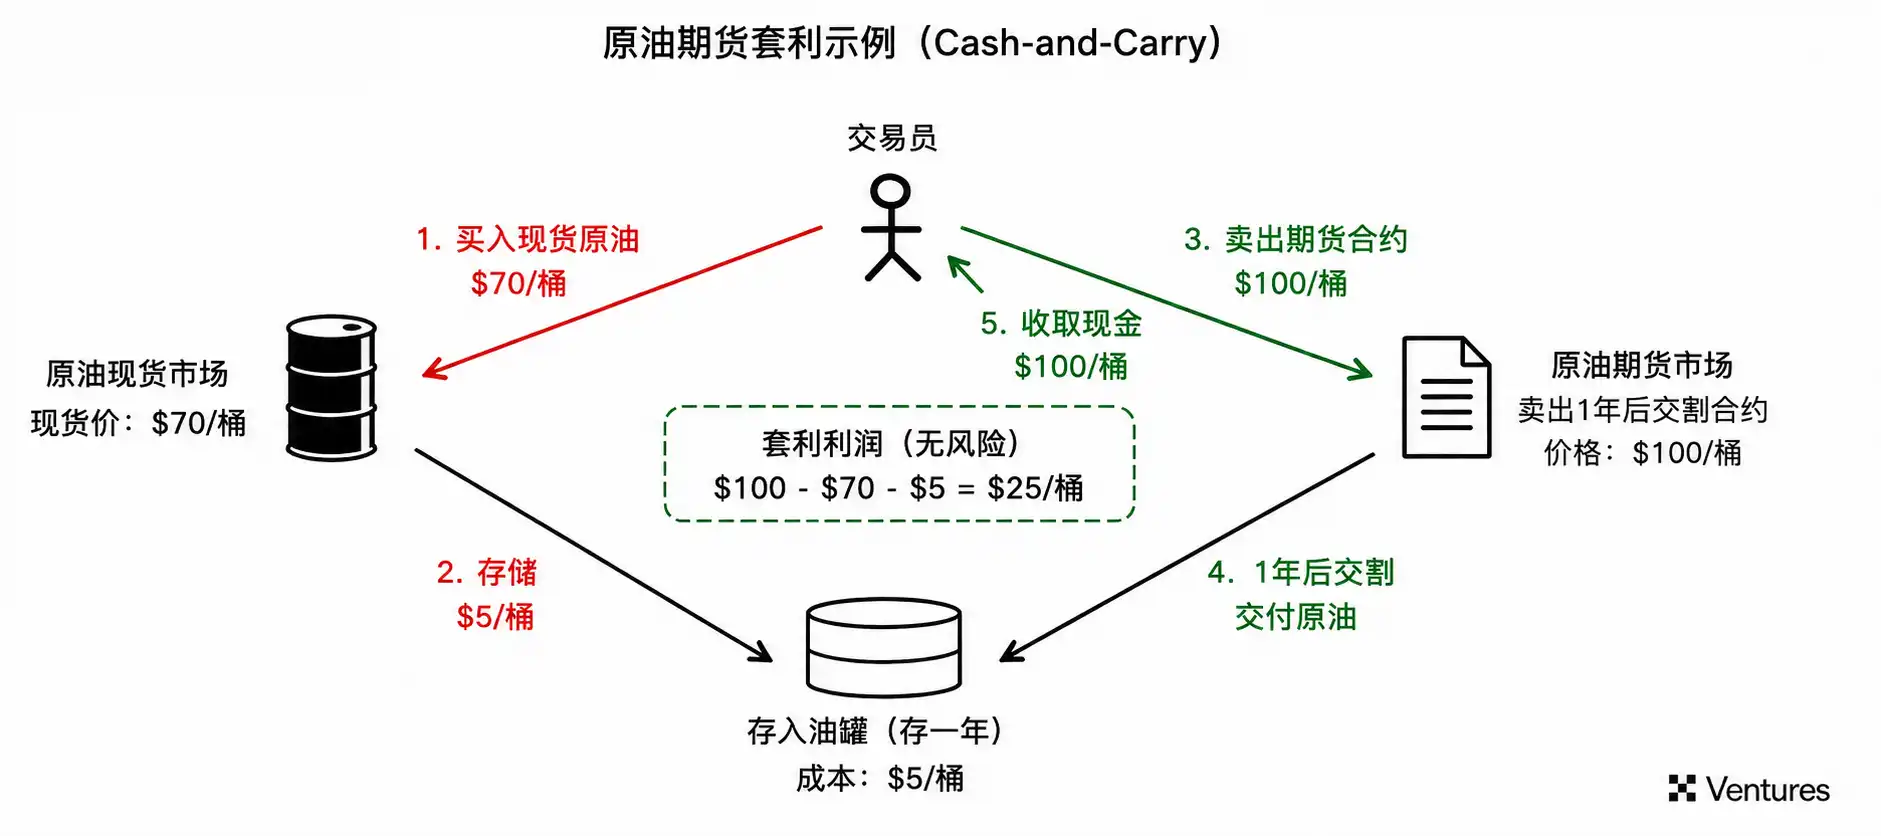
算力缺少 cash and carry 這層套利約束,現貨價格對遠期曲線的約束因此更弱。
未來價格因此會對邊際信息非常敏感。Blackwell 延遲交付、資料中心送電延遲,會減少預期供應;模型蒸餾、推理優化或者新一代晶片提高單位計算效率,又會增加全網有效算力。很多變化都可能在幾個月內重新改寫遠期供需。
這也提高了真實訂單流的價值。公開現貨報價只能告訴市場今天發生了什麼,長期容量訂單則能更早暴露未來供需。一家持續撮合 Neocloud 和 AI Lab 的 Broker 或 Dealer,能夠看到哪些機房開始出現空餘容量、哪些買家願意為半年後的 GPU 支付溢價。這類信息最終會直接進入遠期報價。
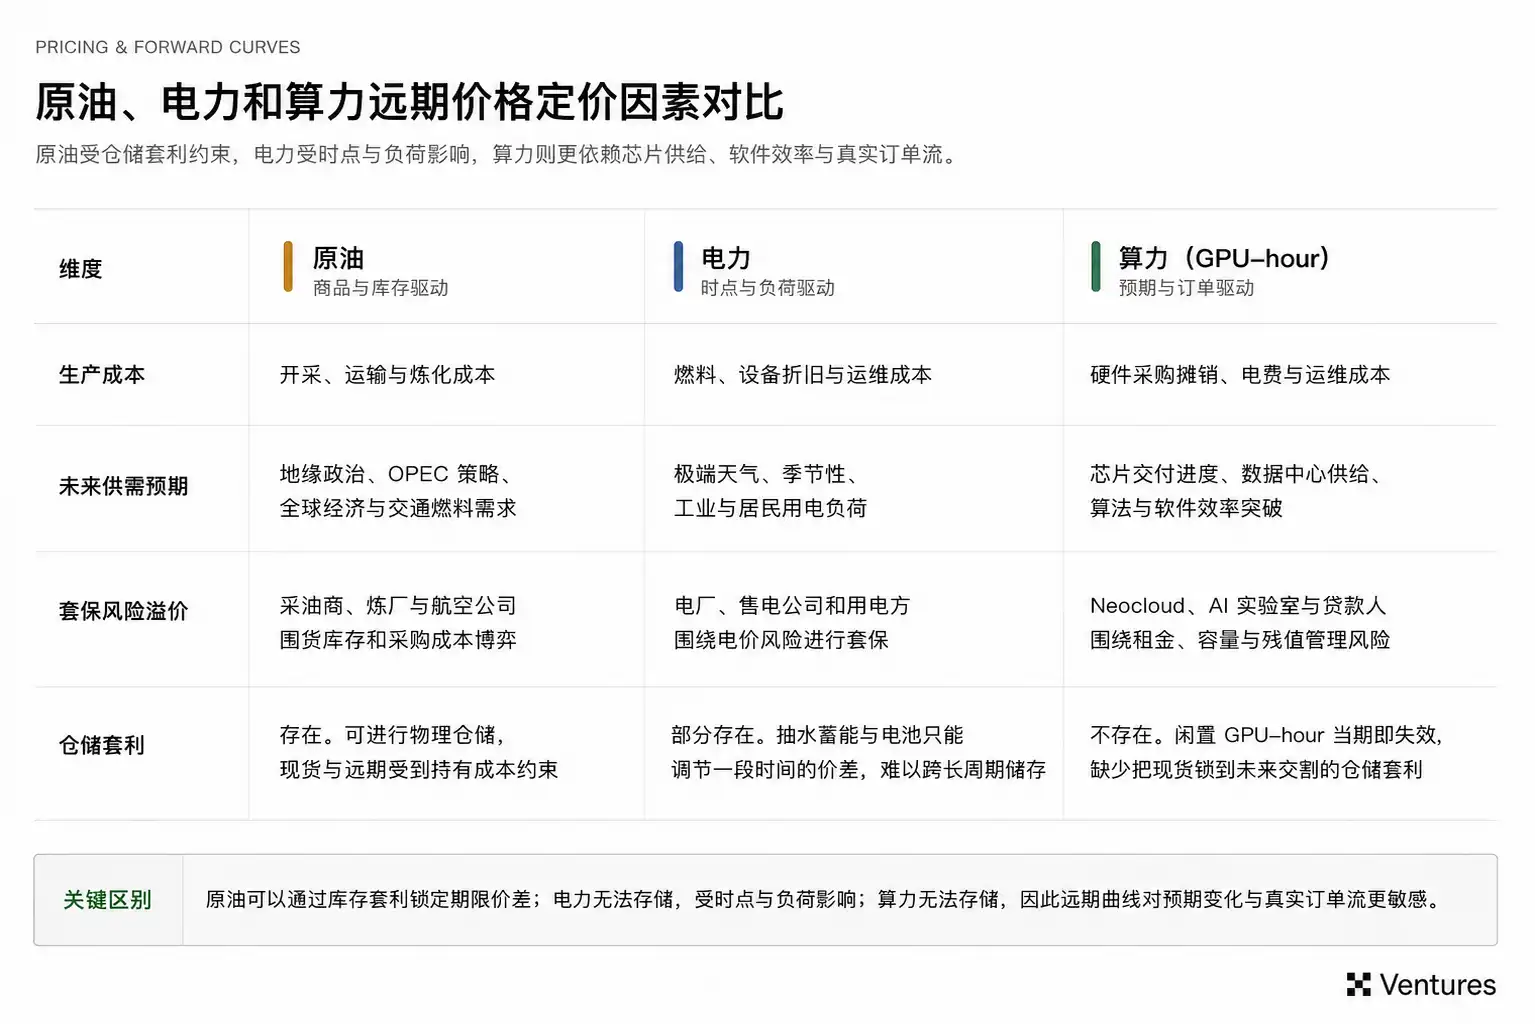
因此,算力指數的價值,在於將高度分散的非標報價壓縮成一套可以被合同、信貸和衍生品共同引用的價格基準。如果某套指數能夠持續進入長期容量合同、貸款估值、場外交易結算和期貨交割,它就會逐漸成為整個市場共同使用的定價錨。後面指數商和 Dealer 能否建立壁壘,很大程度上取決於它們離真實成交和未來訂單有多近。
3.2 GPU-hour 和 AI Token 的金融化節奏不會同步
AI 產業鏈裡實際存在兩層價格。上游賣 GPU capacity,中游推理平台把 GPU-hours 轉換成模型調用,再向下游出售 AI Token、API 或具體 workload。
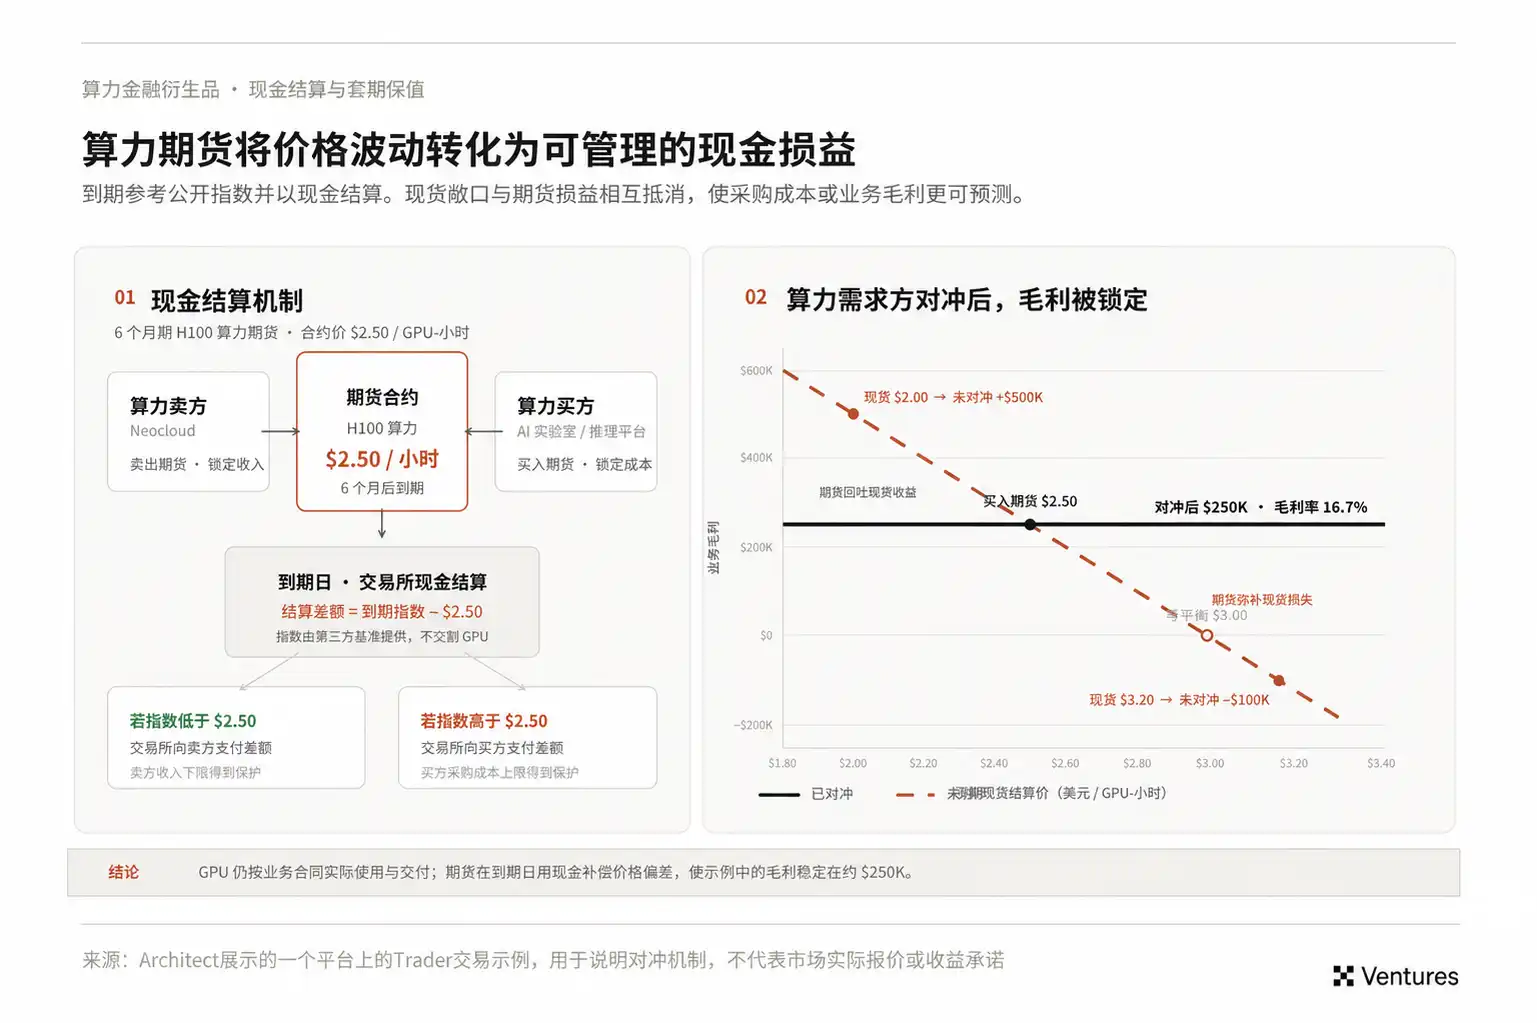
對推理平台而言,經營利潤同時依賴兩端。GPU 租金上漲會抬高輸入成本,AI Token 售價下降又會壓低收入。如果兩端都形成可交易價格,推理平台理論上可以鎖定一段 compute to intelligence spread,這和能源市場裡煉油商管理 crack spread 的邏輯很接近。
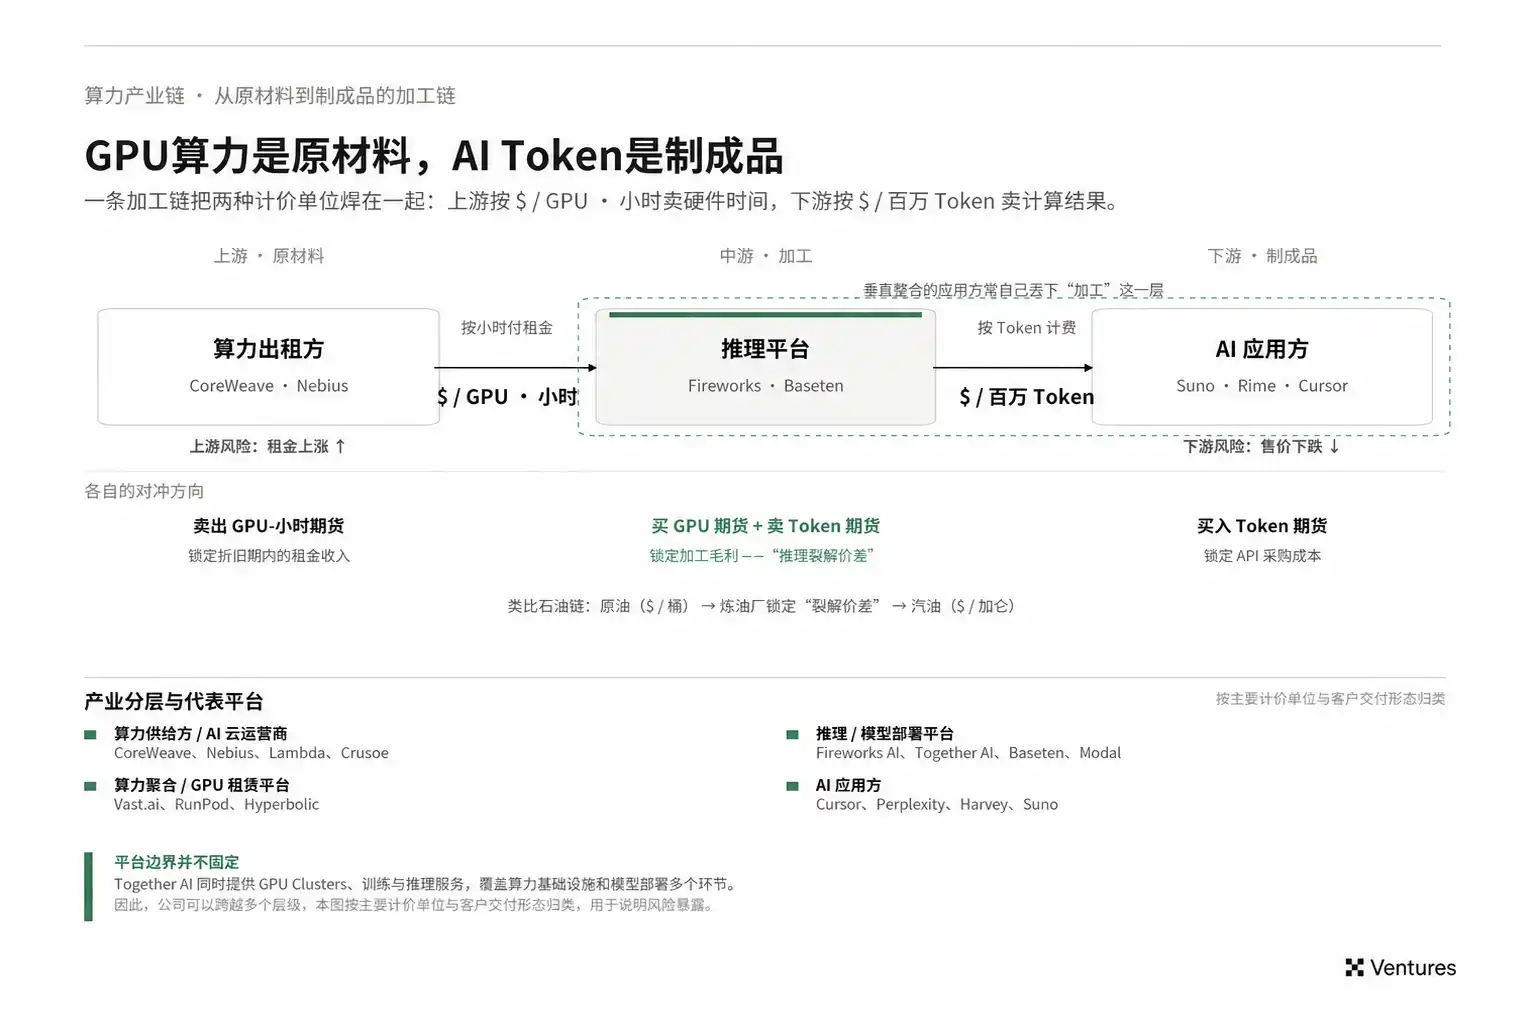
不過, GPU-hour 和 AI Token 目前距離標準化的程度差很多。
GPU 雖然也有型號、地區、互聯方式、集群規模和 SLA 的差異,至少可以圍繞某一代晶片、交付期限和區域逐步定義標準規格。一張 H100 或 H200 在技術屬性上仍然具有相對明確的邊界。
而 Token 更缺少穩定的經濟單位。單純按 Token 數量結算,很難把不同模型和不同服務質量放進同一份金融合約。同樣一百萬個 Token,可以來自完全不同能力的模型,也可能對應完全不同的延遲、吞吐和穩定性。企業大客戶的實際採購價格還經常低於公開 API 報價,因此掛牌價格本身也很難直接作為金融結算基準。
此外,技術通縮進一步放大了 AI Token 期限定價難度。模型架構、推理框架和硬件效率持續提高,同等質量任務所需的計算成本可能在很短時間裡明顯下降。期限一旦拉長,市場需要預測的已經不只是 Token 供需,還包括未來一單位“智能能力”究竟需要多少 Token 和多少 GPU。
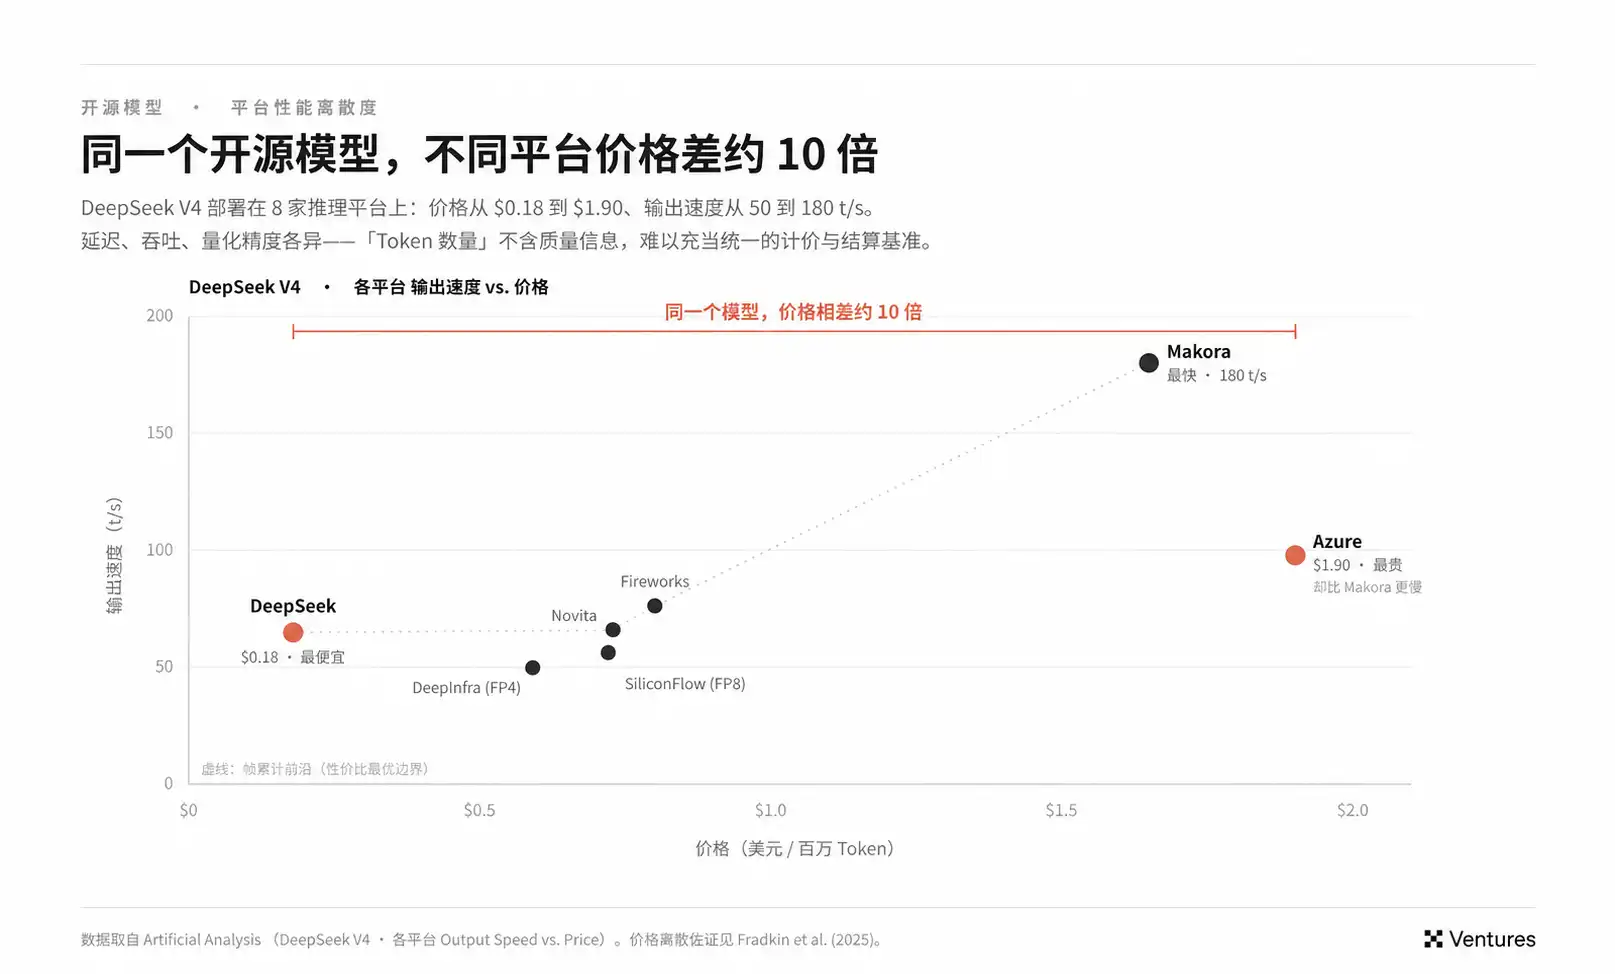
由此,需求側的標準化未必會直接從 Token futures 開始。更可能先出現的是模型籃子、Router 和 workload pricing:將一項 coding、search 或其他任務定義為相對穩定的服務單位,再由底層系統動態選擇模型和 Provider。等這類 workload 有了足夠多的真實成交,市場才有條件進一步形成指數和衍生品。
GPU-hour 更靠近基礎商品,workload 更靠近最終經濟需求。兩者之間的標準化過程,會決定算力金融市場最終交易標的。
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章