融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


Cysic:zkVM如何成為ZK產業的新典範?
原文標題:《New Paradigm in Designing ZK-ASICs, the zkVM way》
原文作者:Cysic 團隊
感謝Justin Drake 和Luke Pearson 的深刻討論。
TL;DR
即時零知識證明產生需要端對端的硬體加速。 zkVM 不僅簡化了 ZK ASIC 的設計,還使硬體效能更高,成本更低。
引言
零知識證明(ZKP )允許一方(證明者)向另一方(驗證者)證明某個聲明是真實的,且無需透露除聲明本身的有效性之外的任何資訊。
零知識證明的發明人之一Silvio Micali(他與Goldwasser 和Rackoff 共同發明)曾表示,正如加密會混淆數據一樣,零知識證明會混淆計算。更具體地說,加密演算法(如 AES 或 RSA)可以將資料轉換成相應的密文,而這種密文隱藏了底層資料。零知識證明則將計算性聲明轉換為證明,這種證明不僅隱藏了計算的細節,而且驗證了該聲明的正確性。
ZKP 有兩個良好的特性-零知識性和簡潔性。這也讓其成為了最廣泛使用的高階密碼學原語之一。
零知識性意味著證明本身不會洩露任何關於計算過程以及私有輸入的資訊。這一特性對於建立一些以隱私為導向的應用程式非常有用。例如 Aleo,它與比特幣、以太坊和其他公鏈不同,能夠隱藏交易細節。
簡潔性則指的是證明的小尺寸以及短驗證時間,這意味著複雜的計算過程可以轉換為一小塊資料(即「證明」,「proof」)。而且幾乎可以在弱運算設備(例如手機、甚至樹莓派)上即時驗證。這項特性在擴展以太坊時極為有用,我們可以將對應 1000 筆交易的 EVM 計算轉換為一個微小的證明,然後將此證明發佈在以太坊上。如果這樣一個小證明(可能只有 100 位元組)得到以太坊的驗證,那麼整個 1000 筆交易就得以最終確認。私有區塊鏈和擴展解決方案只是區塊鏈社群中 ZKP 熱潮的兩個例子。利用這兩個關鍵屬性還可建構許多 ZK 項目,如 ZK 協處理器、ZK 橋接器、ZK 機器學習(ZKML)。
ZK 硬體加速的現況
ZKP 廣泛部署的一個重大障礙是證明生成過程中對計算時間和資源的龐大需求。
通常,更複雜的計算需要更多的時間和資源。例如,在 Daniel Kang 及其團隊的 ZKML 專案中,使用強大的 64 執行緒 CPU 進行 GPT-2 推理的證明產生需要超過 9000 秒。另一方面,Scroll 中的 ZK-EVM 電路的證明產生需要超過 280GB 的 RAM。
由於這些令人望而卻步的資源需求,社群正在尋求更有效的、針對 ZK 計算(指證明產生)定制的硬體。硬體選項包括 CPU、GPU、FPGA 和 ASIC。這些選項從現已可用到不確定的等待期不盡相同。
CPU 通常被視為基線實現,用於與其他三個選項進行比較。硬體加速有兩個常見的指標,以下是一些直覺的解釋:
· 性價比(Performance per dollar):這意味著用戶需要支付多少錢來購買這種硬體。購買決策取決於許多因素,其中最重要的一點是同樣的開銷可獲得的最大效能。基本而言,這項指標衡量了硬體的成本效益。通常,如果使用更先進的製程來製造晶片,則我們可以獲得更高的性能,但它往往更昂貴。
· 能耗比(Performance per watt):這表示運行這種硬體需要多少能量。例如,比特大陸最新的比特幣礦機 T21 只使用 19 焦耳就能完成 1 TH 的計算,性能超過了競爭對手的產品。
產品的優勢主要取決於上述兩個因素,以及部分非技術因素(如保固和殘值)。通常,由於客製化的特性,基於 ASIC 的硬體在這兩個指標上超過了其他三種硬體。
我們想像一下,現在已經設計出了一款專門的ZK ASIC,其每美元和每瓦特的性能均遠超現有的GPU 和FPGA 。這款 ASIC 可以支援多種模組,例如多標量乘法(MSM)、數論變換(NTT)、梅克爾樹等,但我們如何將這款硬體與目前的技術堆疊整合呢?
最常見的方法是用加速部件取代 CPU 程式碼中對應的計算,而這種簡單的替代方法通常無法實現令人滿意的效能加速。我們在ethCC’23 上發布了有關這種方法的發現(更多細節在這條推文中)。
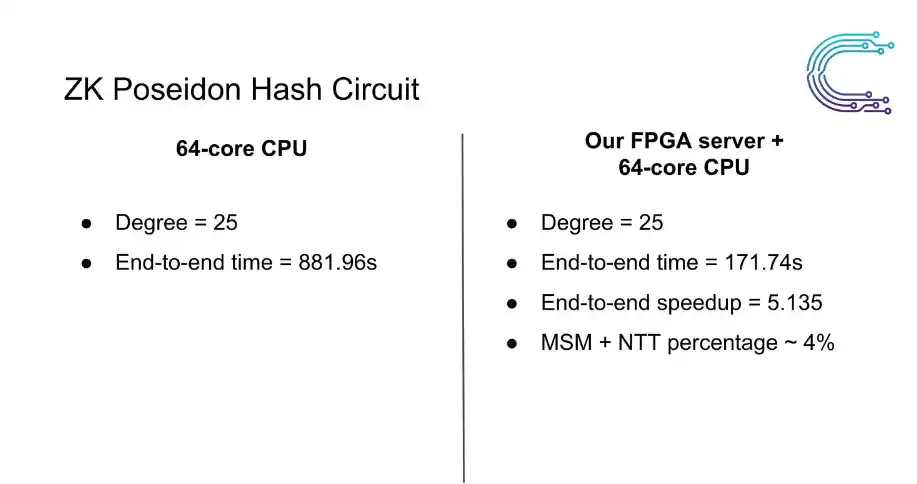
CPU 與FPGA/CPU 效能對比
與CPU 效能相比,我們透過結合CPU 和我們客製化的FPGA 機器取得了實質進展,但效能仍遠未達到最終目標——即時ZK 證明。
這種次優的表現是由於阿姆達爾定律和不同硬體組件之間的交互成本所致。阿姆達爾定律顯示,透過優化系統的單一部分所獲得的整體效能提升是有限的,而不同硬體模組之間的通訊成本則進一步惡化了這種情況(源自維基百科)。為了實現相對於 CPU 的顯著加速,需要在單一硬體上加速每一個可能的元件。
然而,由於ZK 演算法的多樣性(明確地說,ZK 演算法指的是ZK 證明生成中的計算操作),這似乎是不可能的。例如,上述推特截圖展示了三個ZK 電路,即Poseidon Hash、EVM 和GPT-2,儘管使用了相同的證明後端(Halo2-KZG),其中計算差異仍很大,尤其是在見證生成部分。截圖還沒有包括不同的證明後端(如 Plonky2/3 和 Gnark)。
我們在這裡想要表達的觀點是,硬體需要足夠通用,以適應 ZK 演算法的各種片上計算操作。這種通用性可以透過FPGA 和ASIC 的混合結構來實現,正如我們在2022 年的這條推文中所提議的:
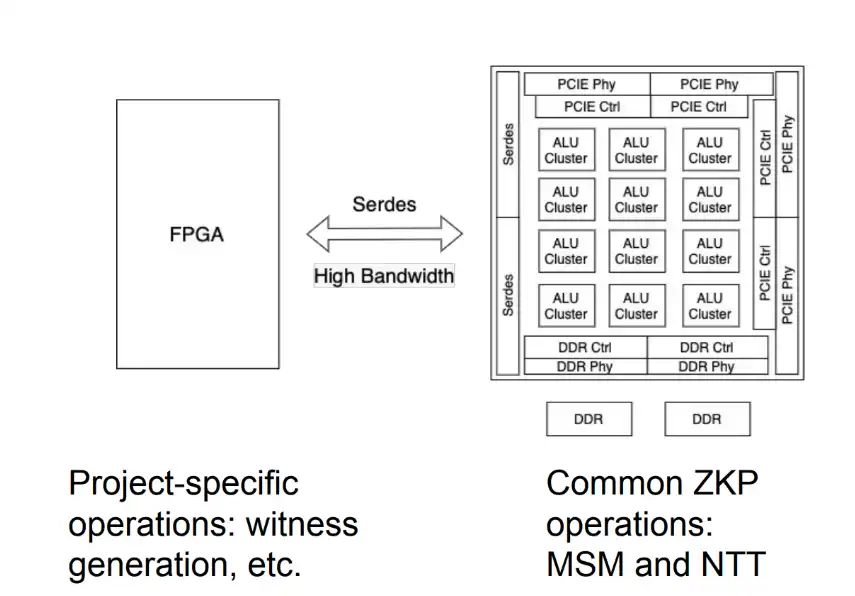
FGPA-ASIC 混合架構
在這種混合結構中,ASIC 執行常見操作,而 FPGA 進行特定電路的計算。這兩款硬體設備隨後被安裝在同一塊 PCB 板上,並透過高頻寬的 SerDes 通道連接。另外,像是基於 RISC-V 或基於 ARM 的片上 CPU 核心,也可用於類似目的。這些混合方法通常在成本和製造品質上有極高的要求。在過去的半年裡,我們一直在問自己:
「混合」是否是我們能想到的最佳結構?我們能否依靠 ZK 社群的技術進步來改進我們的設計?下面,我們對以上問題給了一個正面的答案。
Cysic 的解決之道,過去與現在
在深入技術細節之前,我們首先需要介紹一些關於零知識證明(ZKP)的基本知識。 Plonkish 證明系統的典型證明產生過程可以分為以下階段(有關證明生成的詳細解析,請閱讀Scroll 的這篇部落格):
1. 記錄見證:見證,也被成為trace。它指的是一些數據,這些數據與其他數據共同顯示了一個聲明為什麼是真實的。記錄透過一個稱為 trace 表的二維矩陣完成。該表中的每一個條目都是有限欄位的一個元素。填入 trace 資料表的過程稱為「見證產生」,這需要遍歷表中的每個儲存格並填入正確的值。這個過程需要在有限欄位上進行算術運算,並針對特定的 ZK 電路進行客製化。
2. 提交見證:見證生成之後,我們獲得了一個trace 表,表中的每一列都通過拉格朗日插值被解釋為一個多項式。然後可以使用不同的承諾機制來對這些多項式進行承諾,例如 KZG 和 FRI。這裡涉及的主要計算包括多項式乘法(MSM)、數論變換((I)NTT)、多項式拍平和默克爾樹。由於在大型有限欄位上進行複雜的計算,並且所需的資料量龐大,這成為了證明產生的瓶頸。
3. 證明見證為真: 現在 trace 表填寫完成,承諾也已經計算出來。剩下唯一要做的事情是展示 trace 是有效的。這意味著滿足了某些特定的限制。涉及的計算包括數論變換((I)NTT)、多項式乘法(MSM)和多項式拍平。
總結來說,證明生成中的計算包括幾個常見模組:如多項式乘法(MSM)、數論變換(NTT)、默克爾樹和多項式拍平,以及一些額外的模組。
在我們之前的部落格中, 我們展示了優化這些常見模組的一些高級策略。過去幾年,社區也提出了一些有望加速這些常見模組的技術(請參閱 Ulvetanna、Ingonyama 和其他團隊的作品)。我們在這裡不重複這些技術。
這些模組在性能方面已不再是瓶頸,但端到端的證明加速遠未達到令人滿意的程度。這種半成品加速器可以看作是具有一些效能提升的專用 GPU 版本。大致比較如下:
· 優點:除了傳統的 GPU 風格的 SIMD/SIMT 平行運算模型,也專門支援 ZK 運算。這使我們能夠在不依賴尖端 CUDA 程式設計技能(例如使用 CUDA 編寫大整數操作)的情況下,全效能實作 ZK 操作。
· 缺點:程式設計複雜性
· 對於加速器來說,我們提供了類似於AI 中PyTorch 風格的高級程式設計模型,目標是提供一種「彷彿直接從論文翻譯過來」的編碼體驗,當部分證明者被放置在加速器上。儘管我們在硬體層面提供靈活的調度和控制能力,這仍需要理解底層的硬體設計。
· 對於使用 CUDA 的 GPU 用戶,他們在直接使用時有相對完整的控制自由。他們可以進行任意優化。但這也意味著他們必須從零開始一切。
顯然,這種半成品加速器沒有實現最佳的端到端證明加速或用戶友好的編程介面。我們顯然需要在我們的方案中加入一些新元素。
這個新元素就是 zkVM!
zkVM 是什麼?
虛擬機器(VM)是電腦科學中的古老話題,這大體是一個可運行其他程式的程式。例如,以太坊虛擬機(EVM)就可運行以太坊智能合約,其支援的指令在這篇黃皮書中有所規定。我們知道,零知識證明系統涉及電路,因此,zkVM 就是一個可以運行一系列支援指令的電路。除了執行結果,zkVM 還輸出一個證明,顯示與指令序列相對應的 VM 執行軌跡是有效的。
簡而言之,zkVM 是一個可運行VM 的ZK 電路(總結自David Wong 的文章)。
在zkVM 設計中有兩個部分值得考慮:
· 支援的指令集:這意味著VM 能執行的操作。在這個領域有幾個既有的參與者,如 Risc0, Succinct, Starknet, Polygon, Metis 等,他們工作於不同的指令集,如 RISC-V、MIPS 或定制的指令集。
· ZK 架構:這部分涉及到與執行結果一起產生的 ZK 證明。 ZK 架構幾乎與底層 VM 設計無關,但仍需考慮一些微妙的平衡。
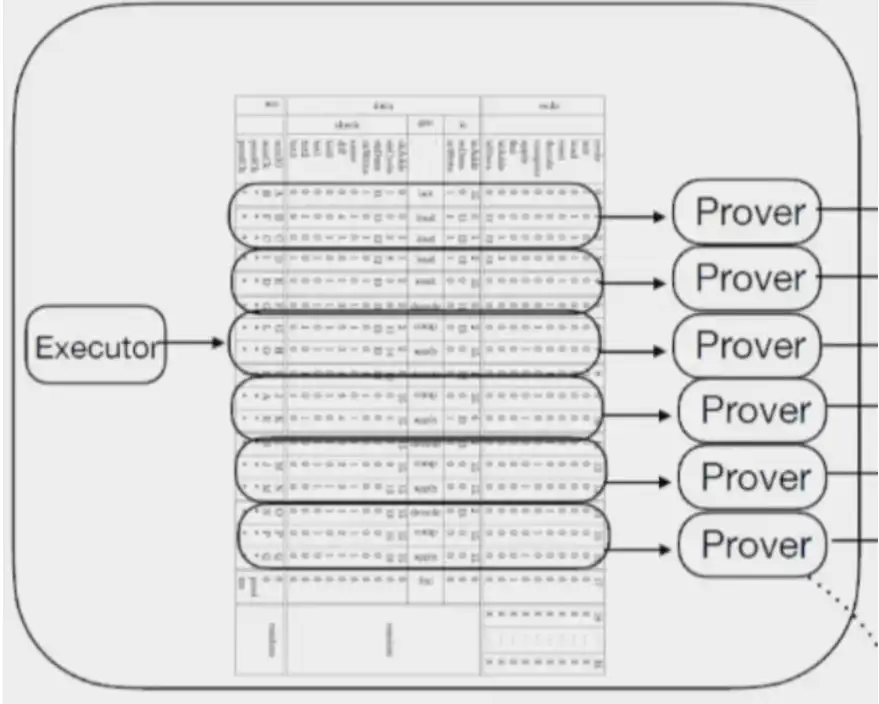
zkVM 設計中有一個很好的功能被稱為延續(continuation)(來自RISC0)。在zkVM 執行中,延續是一種機制,用於將大程式分割成幾個片段,這些片段可以獨立計算和證明,如下圖所示:
分段的過程(來源:Risc0)
這個功能之所以對硬體友好,原因如下:
· 並行性:由於這些切分後的片段之間互不依賴,它們可以分佈到多個硬體上同時產生相應的證明。
· 最小化 I/O 頻寬需求:zkVM 的證明產生遵循「小進小出」的模式。例如,在 Risc0 中,證明產生的片段大小約為 50MB,輸出是一個基於 FRI 的證明,大小約為 250KB。這種特殊模式大大減少了對 I/O 頻寬的需求。
· 可控制的記憶體需求:儘管每個證明產生核心的輸入和輸出都很小,但記憶體需求較大,範圍在數十GB。然而,所需記憶體的大小取決於片段的大小,這可以根據 zkVM 的設計進行調整。
基於這些對硬體友善的特性,我們在下文中描述了我們的硬體設計。
基於zkVM 的硬體設計
系統的架構相對簡單,由一個執行器負責執行程序,硬體負責控制並分配各個「片段(如前文所述)」,以及可配置數量的專用晶片,為每個部分的程序產生ZK 證明。
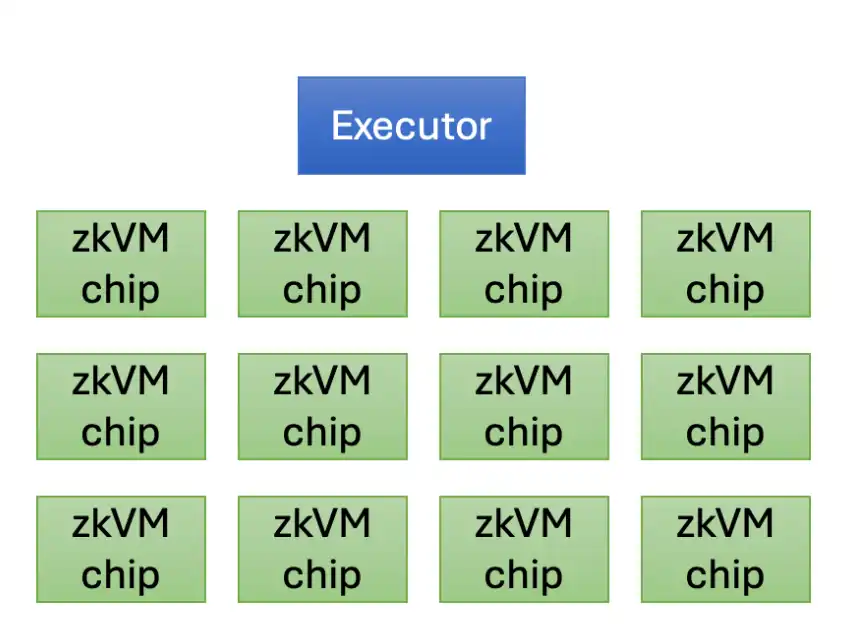
這個簡單的架構使我們的硬體能夠具有靈活的形式。我們可以將執行器(使用弱 CPU 或片上 CPU 核心)、一定數量的 zkVM 晶片以及其他必要的硬體組件(如記憶體)打包到一個機箱中。一個更簡單的情況是將多個晶片打包在一個便攜式機器中,就像 Macbook 充電器一樣。
zkVM 硬體包含幾個運算核心:
· 一台可程式化的向量機用於向量化操作。
· 專用的 NTT 模組,適用於 31 位元、64 位元和 256 位元欄位。
· 專用的 MSM 模組,支援 BN254、BLS12–377 和 BLS12–388 曲線。
· 可設定的雜湊函數單元,用於基於欄位操作的雜湊函數。
除了zkVM 帶來的優勢外,這種設計ZK-ASIC 的新範式也轉化為了眾多優秀的產品,可供個人或企業使用,如下所示:
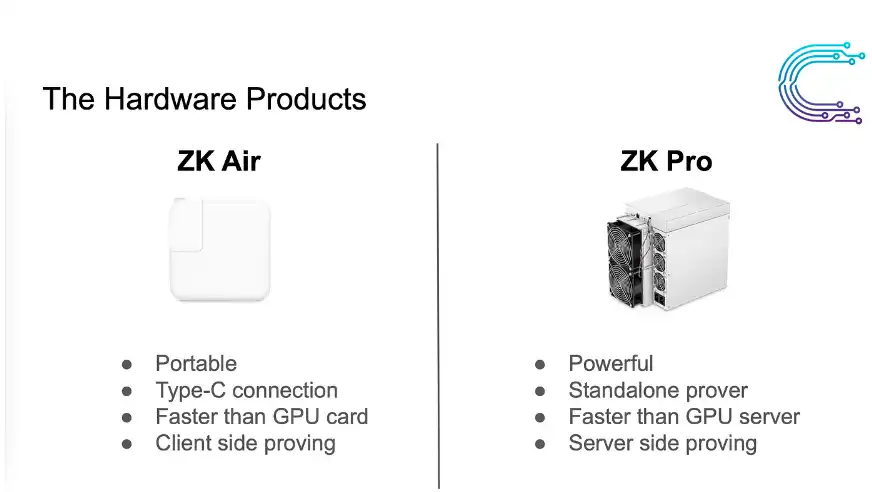
ZK ASIC 產品
誠摯歡迎合作
Cysic 這項zkVM 硬體專案旨在建立一個效能成本效益高效的硬件,適用於廣泛的用例、效能和開發生產力。我們尋求多樣化的視角、創新的想法以及堅定的投入,以改善和拓展我們的硬體設計。我們期待社區的參與和意見,並準備為有意參與的任何人提供指導和支持。
本文來自投稿,不代表 BlockBeats 觀點。
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章