融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


OpenAI正式推出多模態GPT-4:準確性提高,支持微軟新款必應
原文標題:《 重磅突發!OpenAI 正式推出多模態 GPT-4 》
原文作者:OpenAI&TheVerge&Techcrunch
原文編譯:阿法兔
*本文 6000 字左右
亮點
GPT-4 可以接受圖像和文本輸入,而 GPT-3.5 只接受文本。
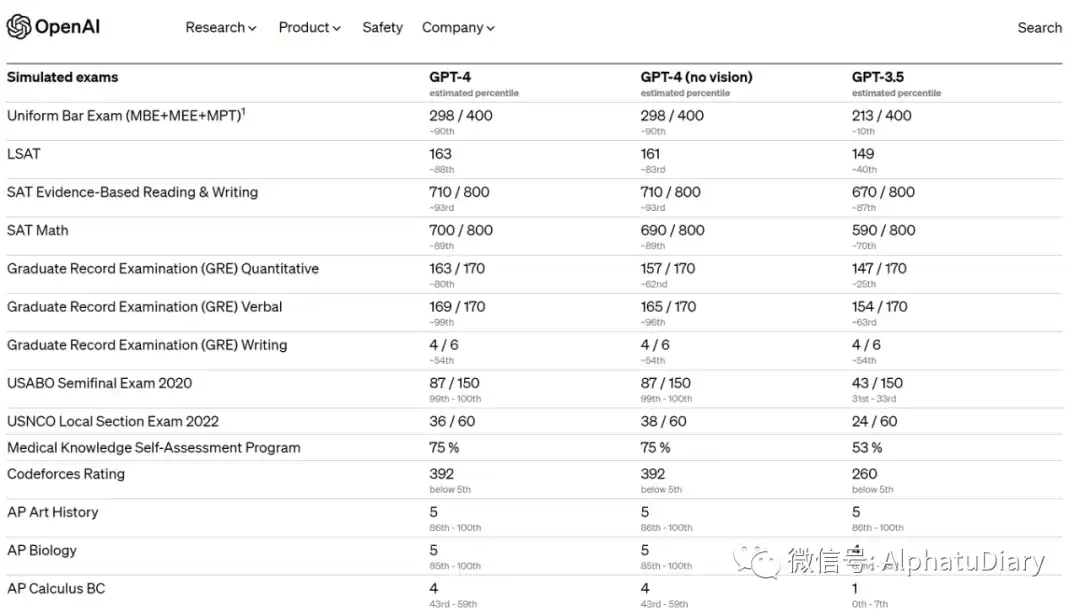
GPT-4 在各種專業和學術基準上的表現達到 "人類水平"。例如,它通過了模擬的律師考試,分數約爲應試者的前 10%。
OpenAI 花了 6 個月的時間,利用從對抗性測試項目以及 ChatGPT 中獲得的經驗,反覆調整 GPT-4,結果在事實性、可引導性和可控制方面取得了 "史上最佳結果"。
在簡單的聊天中,GPT-3.5 和 GPT-4 之間的區別可能微不足道,但是當任務的複雜性達到足夠的閾值時,區別就出來了,GPT-4 比 GPT-3.5 更可靠,更有創造力,能夠處理更細微的指令。
GPT-4 能對相對複雜的圖像進行說明和解釋,比如說,從插入 iPhone 的圖片中識別出一個 Lightning Cable 適配器(下文有圖片)。
圖像理解能力還沒有向所有 OpenAI 的客戶開發,OpenAI 正在與合作伙伴 Be My Eyes 進行測試。
OpenAI 承認,GPT-4 並不完美,仍然會對事實驗證的問題產生錯亂感,也會犯一些推理錯誤,偶爾過度自信。
開源 OpenAI Evals, 用於創建和運行評估 GPT-4 等模型的基準,同時逐個樣本檢查其性能。
官宣文檔
OpenAI 已經正式推出 GPT-4,這也是 OpenAI 在擴大深度學習方面的最新里程碑。GPT-4 是大型的多模態模型(能夠接受圖像和文本類型的輸入,給出文本輸出),儘管 GPT-4 在許多現實世界的場景中能力不如人類,但它可以在各種專業和學術基準上,表現出近似人類水平的性能。
例如:GPT-4 通過了模擬的律師考試,分數約爲全部應試者的前 10%。而相比之下,GPT-3.5 的分數大約是後 10%。我們團隊花了 6 個月的時間,利用我對抗性測試項目以及基於 ChatGPT 的相關經驗,反覆對 GPT-4 進行調整。結果是,GPT-4 在事實性(factuality)、可引導性(steerability)和拒絕超範圍解答(非合規)問題(refusing to go outside of guardrails.)方面取得了有史以來最好的結果(儘管它還不夠完美)
在過去兩年裏,我們重構了整個深度學習堆棧,並與 Azure 合作,爲工作負荷從頭開始,共同設計了一臺超級計算機。一年前,OpenAI 訓練了 GPT-3.5,作爲整個系統的首次 "試運行",具體來說,我們發現並修復了一些錯誤,並改進了之前的理論基礎。因此,我們的 GPT-4 訓練、運行(自信地說:至少對我們來說是這樣!)空前穩定,成爲我們首個訓練性能可以進行提前準確預測的大模型。隨着我們繼續專注於可靠擴展,中級目標是磨方法,以幫助 OpenAI 能夠持續提前預測未來,並且爲未來做好準備,我們認爲這一點,對安全至關重要。
我們正在通過 ChatGPT 和 API(您可以加入 WaitList)發佈 GPT-4 的文本輸入功能,爲了能夠更大範圍地提供圖像輸入功能,我們正在與合作伙伴緊密合作,以形成一個不錯的開端。我們計劃開源 OpenAI Evals,也是我們自動評估 AI 模型性能的框架,任何人都可以提出我們模型中的不足之處,以幫助它的進一步的改進。
能力
在簡單閒聊時,也許不太好發現 GPT-3.5 和 GPT-4 之間的區別。但是,當任務的複雜性達到足夠的閾值時,它們的區別就出來了。具體來說,GPT-4 比 GPT-3.5 更可靠,更有創造力,能夠處理更細微的指令。
爲了理解這兩個模型之間的差異,我們在各種不同的基準上進行了測試,包括模擬最開始那些爲人類設計的考試。通過使用最新的公開測試(就奧數和 AP 等等考試)還包括購買 2022-2023 年版的練習考試來進行,我們沒有爲這類考試給模型做專門的培訓,當然,考試中存在很少的問題是模型在訓練過程中存在的,但我們認爲下列結果是有代表性的。
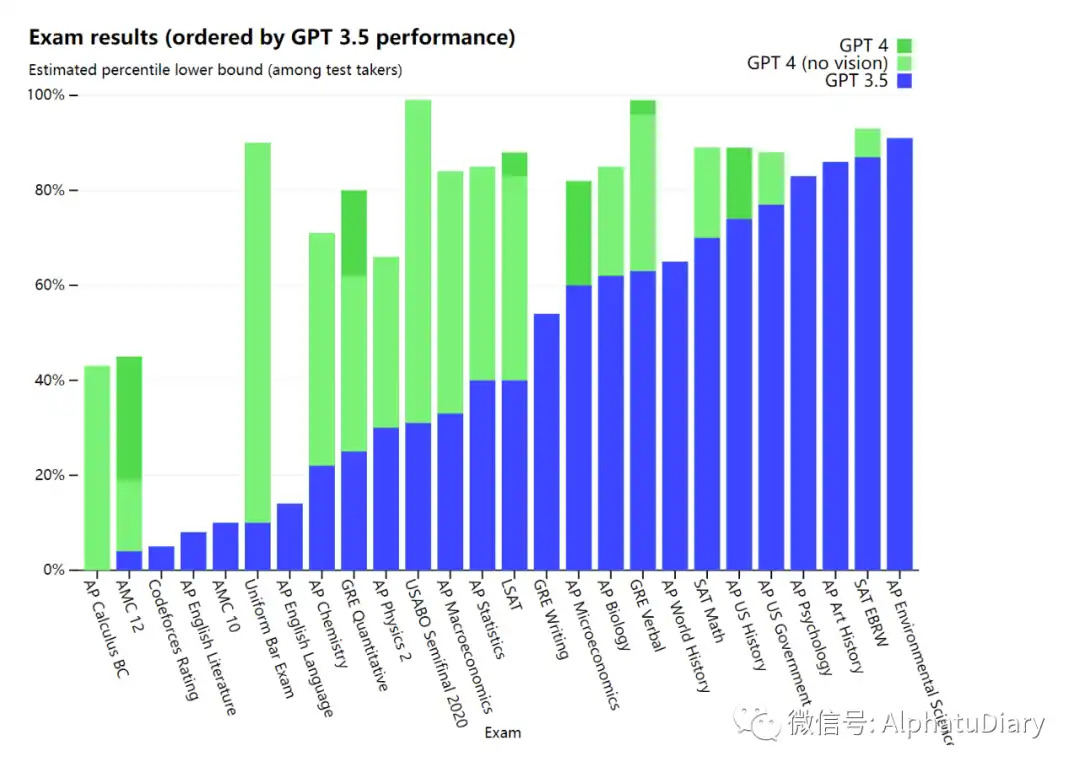
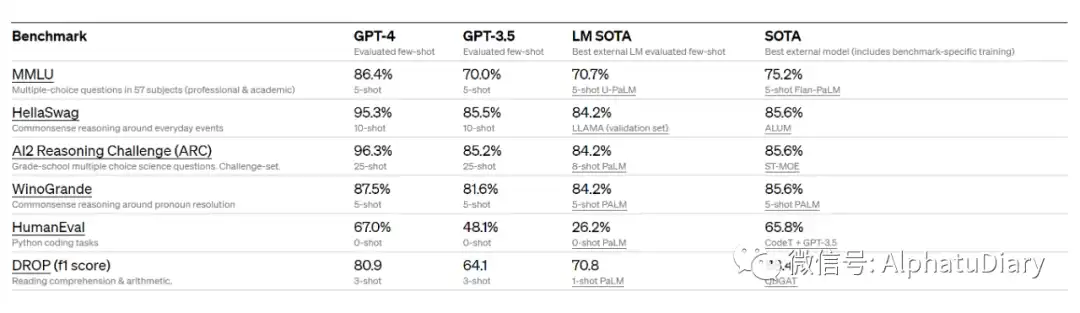
我們還在爲機器學習模型設計的傳統基準上,對 GPT-4 進行了評估。GPT-4 大大超過現有的大語言模型,與多數最先進的(SOTA)模型並駕齊驅,這些模型包括針對基準的製作或額外的訓練協議。
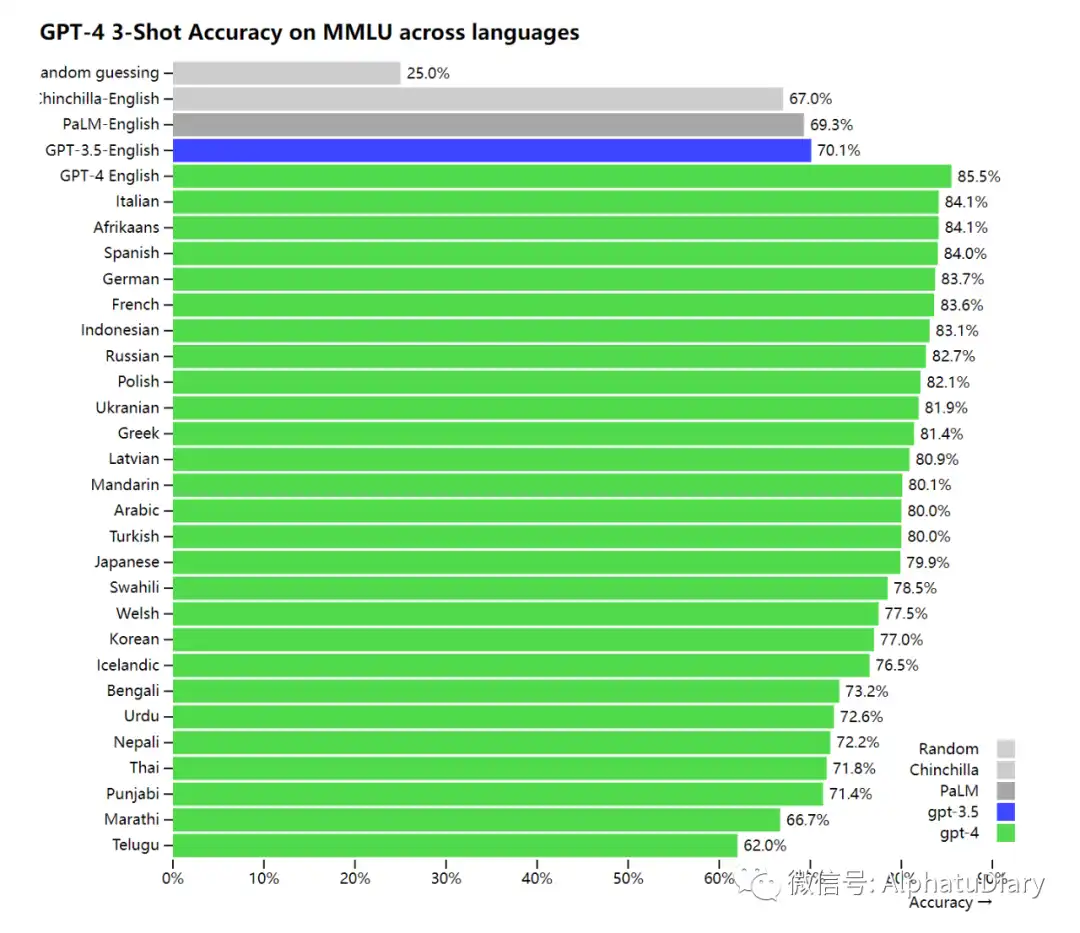
由於現有的大多數 ML 基準是用英語編寫的,爲了初步瞭解其他語言的能力,我們使用 Azure Translate 將 MMLU 基準:一套涵蓋 57 個主題的 14000 個選擇題,翻譯成了各種語言。在測試的 26 種語言中的 24 種語言中,GPT-4 的表現優於 GPT-3.5 和其他大模型(Chinchilla,PaLM)的英語表現,這種優秀表現還包括類似拉脫維亞語、威爾士語和斯瓦希里語等等。
我們一直在內部使用 GPT-4,發現它對支持、銷售、內容審覈和編程等功能會產生很大影響,我們還在用它來協助人類評估 AI 的輸出,這就是我們調整戰略的第二階段的開始。
視覺輸入
GPT-4 可以接受文本和圖像的提示語(prompt),這與純文本設置平行。比如說,可以讓用戶指定任何視覺或語言任務,它可以生成文本輸出(自然語言、代碼等),給定的輸入包括帶有文字和照片的文件、圖表或屏幕截圖,GPT-4 表現出與純文本輸入類似的能力。此外,還可以應用在爲純文本語言模型開發的測試時間技術,包括少數幾個鏡頭和 CoT 的 Prompting,不過目前圖像輸入仍然屬於研究方面預覽,沒有像 C 端公開產品。
下列圖片顯示了一個 "Lightning Cable "適配器的包裝,有三個面板。
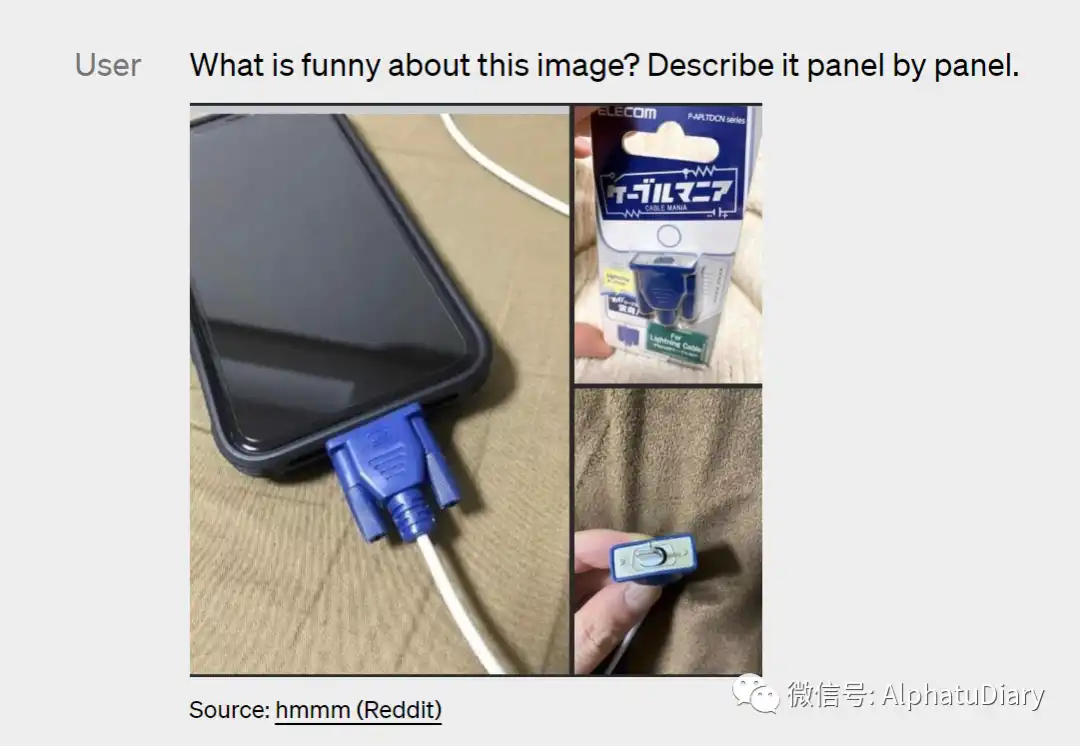
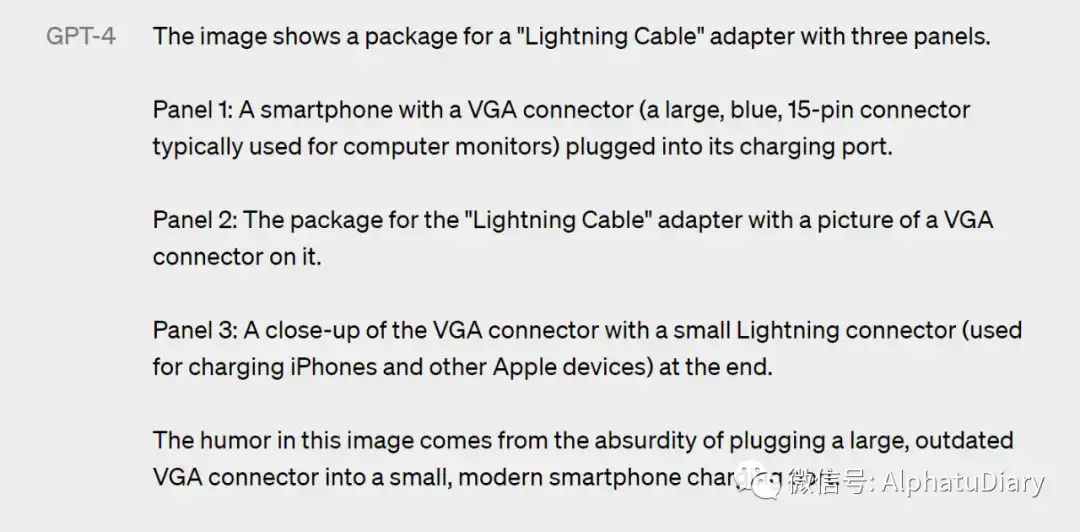
面板 1:一個帶有 VGA 接口(通常用於電腦顯示器的大型藍色 15 針接口)的智能手機插在其充電端口。
面板 2:"Lightning Cable "適配器的包裝上有一張 VGA 接口的圖片。
面板 3:VGA 連接器的特寫,末端是一個小的 Lightning 連接器(用於爲 iPhone 和其他蘋果設備充電)。
這張圖片的搞笑性質來自於將一個大的、過時的 VGA 連接器插入一個小的、現代的智能手機充電端口.. 因此看起來很荒謬
通過在一套狹窄的標準學術視覺基準上,對 GPT-4 的性能進行評估,並且對它進行預覽。然而,這些數字並不能代表其的能力範圍,因爲我們發現,這個模型能夠處理很多的新的和令人興奮的任務,OpenAI 計劃很快發佈進一步的分析和評估數字,以及對測試時間技術效果的徹底調查結果。
可控制的 AI
我們一直在努力實現關於定義 AI 行爲那篇文章中,所概述的計劃的每個方面,包括 AI 的可控制性。與經典的 ChatGPT 個性的固定言語、語氣和風格不同,開發者(很快就是所有的 ChatGPT 用戶)現在可以通過在 "系統 "消息中描述這些方向,來規定自己的 AI 的風格和任務。系統消息允許 API 用戶在範圍內,大幅對用戶體驗進行定製,我們將持續改進。
侷限性
儘管能力驚人,不過,GPT-4 仍存在與早期 GPT 模型類似的限制。最重要的是,它仍然不是完全可靠的(比如說,它會對事實產生 "幻覺",並出現推理錯誤)。在使用語言模型的輸出時,特別是在高風險的情況下,應該非常小心謹慎,比如說:需要人類審查,完全避免高風險的使用)以及需要與特定的使用案例的需求相匹配。
儘管各類情況仍然存在,但相較於以前的模型(這些模型本身也在不斷改進),GPT-4 大大減少了 hallucinations(意思是網絡錯覺,這裏指的是一本正經的胡說八道)。在我們內部的對抗性事實性評估中,GPT-4 的得分比我們最新推出的 GPT-3.5 高 40%。

可控制的 AI
GPT-4 的基礎模型在這項任務中只比 GPT-3.5 略勝一籌;然而,在經過 RLHF 的後期訓練後(應用我們對 GPT-3.5 使用的相同過程),卻有很大差距。該模型在其輸出中會有各種偏差,我們在這些方面已經取得了進展,但仍有更多工作要做。根據我們最近的博文,我們的目標是使我們建立的人工智能系統具有合理的默認行爲,以反映廣泛的用戶價值觀,允許這些系統在廣泛的範圍內被定製,並獲得公衆對這些範圍的意見。
GPT-4 通常缺乏對其絕大部分數據截止後(2021 年 9 月)發生的事件的瞭解,也不會從其經驗中學習。它有時會犯一些簡單的推理錯誤,這似乎與這麼多領域的能力不相符,或者過於輕信用戶的明顯虛假陳述。有時它也會像人類一樣在困難的問題上失敗,例如在它產生的代碼中引入安全漏洞。GPT-4 也可能在預測中自信地犯錯。
風險和緩解措施
我們一直在對 GPT-4 進行迭代,使其從訓練開始就更加安全,保持一致性,我們所做的努力包括預訓練數據的選擇和過濾、評估,邀請專家參與,對模型安全改進、監測,以及執行。
GPT-4 與過去的模型會存在類似風險,如生產有害的建議、錯誤代碼或不準確的信息。然而,GPT-4 的額外能力還導致了新的風險面。爲了明確這些風險的具體情況,我們聘請了 50 多位來自人工智能對接風險、網絡安全、生物風險、信任和安全以及國際安全等領域的專家對該模型進行對抗性測試。他們的參與,使我們能夠測試模型在高風險領域的行爲,這些領域需要專業知識來評估。來自這些領域專家的反饋和數據,爲我們緩解和改進模型提供了依據。比如說,我們已經收集了額外的數據,以提高 GPT-4 拒絕有關如何合成危險化學品的請求的能力。
GPT-4 在 RLHF 訓練中加入了一個額外的安全獎勵信號,通過訓練模型來拒絕對此類內容的請求,從而減少有害產出(由我們的使用指南定義)。獎勵是由 GPT-4 的分類器提供的,它能夠判斷安全邊界和安全相關提示的完成方式。爲了防止模型拒絕有效的請求,我們從不同的來源(例如,標記的生產數據,人類的紅隊,模型生成的提示)收集多樣化的數據集,並在允許和不允許的類別上應用安全獎勵信號(存在正值或負值)。
與 GPT-3.5 相比,我們的緩解措施大大改善了 GPT-4 的許多安全性能。與 GPT-3.5 相比,我們將模型對非法內容的請求的響應傾向,降低了 82%,而 GPT-4 對敏感請求(如醫療建議和自我傷害)的響應符合我們的政策的頻率提高了 29%
總的來說,我們的模型級干預措施增加了誘發不良行爲的難度,但仍然存在 "越獄 "的情況,以產生違反我們使用指南的內容。隨着人工智能系統的 風險的增加,在這些干預措施中實現極高的可靠性將變得至關重要。目前重要的是,用部署時間的安全技術來補充這些限制,如想辦法監測。
GPT-4 和後續模型,很有可能對社會產生正面或者負面的影響,我們正在與外部研究人員合作,以改善我們對潛在影響的理解和評估,以及建立對未來系統中可能出現的危險能力的評估。我們將很快分享我們對 GPT-4 和其他人工智能系統的潛在社會和經濟影響的更多思考。
訓練過程
和之前的 GPT 模型一樣,GPT-4 基礎模型的訓練是爲了預測文檔中的下一個單詞,並使用公開的數據(如互聯網數據)以及我們授權的數據進行訓練。這些數據是來自於極大規模的語料庫,包括數學問題的正確和錯誤的解決方案,弱的和強的推理,自相矛盾的和一致的聲明,以及種類繁多的意識形態和想法。
因此,當被提示有一個問題時,基礎模型可以以各種各樣的方式作出反應,而這些反應可能與用戶的意圖相去甚遠。爲了使其與用戶的意圖保持一致,我們使用人類反饋的強化學習(RLHF)對模型的行爲進行微調。
注意,模型的能力似乎主要來自於預訓練過程,RLHF 並不能提高考試成績(如果不主動努力,它實際上會降低考試成績)。但是對模型的引導來自於訓練後的過程--基礎模型需要及時的工程,甚至知道它應該回答問題。
可預測的擴展
GPT-4 項目的一大重點是建立一個可預測擴展的深度學習棧。主要原因是,對於像 GPT-4 這樣非常大的訓練運行,做大量的特定模型調整是不可行的。我們對基礎設施進行了開發和優化,在多種規模下都有非常可預測的行爲。爲了驗證這種可擴展性,我們提前準確地預測了 GPT-4 在我們內部代碼庫(不屬於訓練集)中的最終損失,方法是通過使用相同的方法訓練的模型進行推斷,但使用的計算量要少 10000 倍。
我們認爲,準確預測未來的機器學習能力是安全的一個重要部分,相對於其潛在的影響,它沒有得到足夠的重視(儘管我們已經被幾個機構的努力所鼓舞)。我們正在擴大我們的努力,開發一些方法,爲社會提供更好的指導,讓人們瞭解對未來系統的期望,我們希望這成爲該領域的一個共同目標。
開放式人工智能評估
我們正在開源 OpenAI Evals,這是我們的軟件框架,用於創建和運行評估 GPT-4 等模型的基準,同時逐個樣本檢查其性能。我們使用 Evals 來指導我們模型的開發(包括識別缺點和防止退步),我們的用戶可以應用它來跟蹤不同模型版本(現在將定期推出)和不斷髮展的產品集成的性能。例如,Stripe 已經使用 Evals 來補充他們的人工評估,以衡量他們的 GPT 驅動的文檔工具的準確性。
因爲代碼都是開源的,Evals 支持編寫新的類來實現自定義的評估邏輯。然而,根據我們自己的經驗,許多基準都遵循一些 "模板 "中的一個,所以我們也包括了內部最有用的模板(包括一個 "模型分級 Evals "的模板--我們發現 GPT-4 有令人驚訝的能力來檢查自己的工作)。一般來說,建立一個新的評估的最有效方法是將這些模板中的一個實例化,並提供數據。我們很高興看到其他人能用這些模板和 Evals 更廣泛地建立什麼。
我們希望 Evals 成爲一個分享和衆包基準的工具,最大限度地代表廣泛的故障模式和困難任務。作爲後續的例子,我們已經創建了一個邏輯謎題評估,其中包含 GPT-4 失敗的十個提示。Evals 也與實現現有的基準兼容;我們已經包括了幾個實現學術基準的筆記本和一些整合 CoQA(小的子集)的變化作爲例子。
我們邀請大家使用 Evals 來測試我們的模型,並提交最有趣的例子。我們相信 Evals 將成爲使用和建立在我們的模型之上的過程中不可或缺的一部分,我們歡迎直接貢獻、問題和反饋。
ChatGPT Plus
ChatGPT Plus 用戶將在 chat.openai.com 上獲得有使用上限的 GPT-4 權限。我們將根據實際需求和系統性能調整確切的使用上限,但我們預計容量將受到嚴重限制(儘管我們將在接下來的幾個月裏擴大和優化)。
根據我們看到的流量模式,我們可能會爲更高的 GPT-4 使用量引入一個新的訂閱級別,我們也希望在某個時候提供一定數量的免費 GPT-4 查詢,這樣那些沒有訂閱的用戶也可以嘗試。
API
要獲得 GPT-4 的 API(使用與 gpt-3.5-turbo 相同的 ChatCompletions API),請可以去 OpenAI 的官方 Waitlist 上註冊。
結論
我們期待着 GPT-4 成爲一個有價值的工具,通過爲許多應用提供動力來改善人們的生活。還有很多工作要做,我們期待着通過社區的集體努力,在這個模型的基礎上進行建設、探索和貢獻,共同對模型進行改進。
參考文獻:
1.https://openai.com/research/gpt-4
2.https://techcrunch.com/2023/03/14/openai-releases-gpt-4-ai-that-it-claims-is-state-of-the-art/
3.https://www.theverge.com/2023/3/14/23638033/openai-gpt-4-chatgpt-multimodal-deep-learning
原文鏈接
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia

 相關文章