融資信息
 專題
 鏈上生態
 詞條
 播客
 活動
 OPRR


a16z:視覺AI的未來不是圖片,而是程式碼
原文標題:The Next Frontier of Visual AI Is Code
原文作者:@stuffyokodraws,a16z
編譯:Peggy
編者按:過去幾年,視覺 AI 的競爭幾乎都圍繞一個問題展開:誰生成的圖片更真實,誰生成的影片更流暢。擴散模型把文字提示詞變成圖像、影片和逼真場景,也讓外界習慣於用「像不像」「美不美」來評判模型能力。
但這篇來自 a16z 的文章指出,視覺 AI 的下一階段,可能並不只是生成更漂亮的像素,而是生成像素背後的程式碼製品(code artifact,可繼續編輯、測試和交付的結構化文件)。
這一區別看似技術,實則決定了 AI 能否真正進入生產工作流。設計師需要的不只是一張 UI 截圖,而是 HTML/CSS、React 組件、圖層和可交付文件;動畫師需要的不只是一段影片,而是關鍵幀、時間曲線和可修改的運動參數;3D 藝術家需要的不只是一張渲染圖,而是幾何結構、材質、燈光、相機和場景層級。
因此,文章將視覺生成分為兩條路徑:像素原生生成(直接生成圖片或影片)適合真實感、氛圍和探索;程式碼原生生成(生成 SVG、Lottie、Blender 腳本、USD 場景等)則更適合編輯、迭代和生產。後者真正重要的地方在於,它可以形成「程式碼 → 渲染 → 檢查 → 修改」的閉環。模型不再只是一次次重新抽樣,而是在調試一個可驗證的視覺程序。
這也是為什麼作者尤其看好 3D。因為一張椅子的渲染圖並不是椅子,只是椅子的圖片。真正可用於遊戲、模擬器或 3D 工具的資產,必須具備穩定的幾何結構、部件層級、材質和功能約束:門要能開啟,抽屜要能滑動,輪子要能轉動。換句話說,未來視覺 AI 的價值,不在於「看起來像」,而在於「能不能被繼續使用」。
這篇文章提供了一個很好的判斷框架:第一波視覺 AI 解決的是生成問題,下一波要解決的是生產問題。當視覺 AI 從最終輸出走向源代碼,真正被改變的就不只是設計工具,而是整個視覺內容生產鏈條。
以下為原文:
過去幾年,視覺 AI 大多是按「像素」來評判的。最終生成的圖像或視頻看起來越好,模型似乎就越強。
這並不奇怪。擴散模型先是把文本提示詞變成精美圖片,隨後擴展到視頻,再到越來越逼真的世界。人們自然會把它和 Photoshop 或相機放在一起比較。
但對於許多視覺相關任務來說,比如平面設計、UI 設計或 3D 建模,用戶真正需要的最終表示,並不只是最終呈現出來的像素。他們需要的是一種可以根據反饋和新想法不斷迭代的產品。設計師不只是需要一張 mockup(設計稿),還需要圖層、元件和交付文件;動畫師不只是需要一段視頻,還需要時間曲線、關鍵幀和可編輯的運動軌跡;3D 藝術家不只是需要一張渲染圖,還需要幾何結構、材質、燈光、相機和場景結構。
今天最有趣的視覺 AI 工具,已經不再試圖直接生成最終輸出。它們開始生成最終輸出背後的源代碼。這一變化正在釋放可編輯性、迭代能力和反饋迴圈,而這些是像素原生模型難以匹敵的。
視覺生成的兩套技術棧
我們可以用兩種主要方式來理解視覺生成。
第一種是像素原生生成。這類系統通常直接生成圖像或視頻,往往是在潛空間中完成。它們擅長紋理、氛圍、光照和真實感。如果目標是生成一段電影感鏡頭、一組漂亮的 moodboard(情緒板),或一張照片級真實圖像,擴散模型仍然是主流方法。
第二種是代碼原生生成。這類系統生成的是一種表示形式,再由另一個引擎執行或渲染。模型並不直接生成最終像素,而是生成一段能夠生成像素的程序。
這段程序可以是一個 SVG 檔案、一套 HTML/CSS 佈局、一個 React 元件、一個 Lottie JSON 檔案、一段 Blender 腳本、一個 USD 場景圖、一個 shader(著色器),或者一個遊戲引擎場景。最終的視覺輸出依然是像素,但真正的「事實來源」是一套結構化表示。
這個區別很重要,因為生產工作流非常關心「生成之後會發生什麼」。一張生成圖片可以作為輸出使用,但一個生成出來的視覺程序,則可以作為產品使用:它能被編輯、複用、改進、版本管理;它可以被整合進軟體技術棧,並根據約束進行驗證;它可以在不同條件下反覆渲染,也可以在設計師、工程師和 Agent 之間交接。
我認為,一個重要轉變已經在發生:對於一部分視覺問題,我們將學會將視覺生成任勞再定義為編碼任務,並通過解決一個邊界清晰、可驗證的編碼問題,獲得高度高效的改進。
程式碼是解決視覺問題的好載具
理解視覺程式碼生成價值的最簡單方式,是看第一版草稿之後會發生什麼。
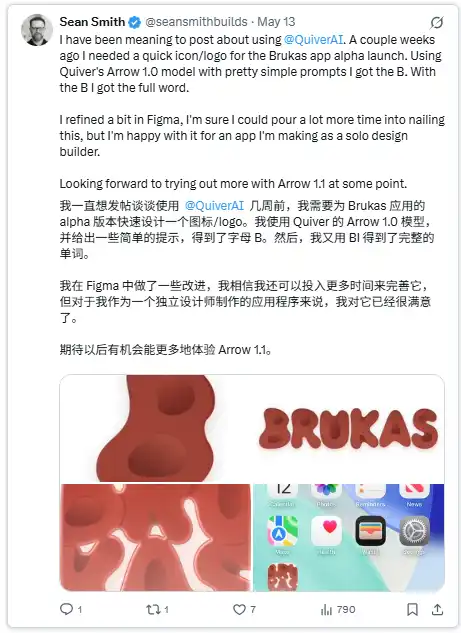
假設一個模型生成了一個 logo。如果輸出是一張點陣圖像,而其中一條曲線不對,使用者就必須遮罩、局部重繪、重新生成,或者手動重畫。但如果輸出是 SVG,使用者就可以直接編輯路徑、基礎圖形、漸變、描邊或文字元素。這已經是設計師在 Quiver 上設計 logo 的方式。
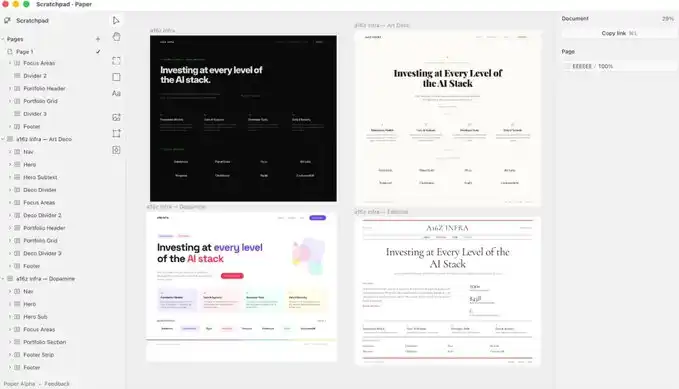
在 UI 設計領域,如果輸出是一張截圖,它更多只是靈感參考。但如果輸出是 HTML/CSS 或 React,設計師就可以檢查 DOM、替換真實元件、測試響應式狀態、檢查無障礙可訪問性,並把它接入應用程式。
這也是為什麼視覺程式碼生成尤其適合 test-time compute(測試時計算)。在像素原生生成中,增加推理計算通常意味著採樣更多輸出:生成 20 張圖,挑出最好的一張,也許再試一次。這當然有用,但每次嘗試本質上更像是重新擲骰子。模型可以響應反饋,但這種反饋通常是整體性的,也不夠精確。
從技術上說,擴散模型也可以從 test-time compute 中受益。例如,《Inference-time Scaling of Diffusion Models through Classical Search》表明,推理階段的搜索可以改善擴散模型在規劃、強化學習和圖像生成中的表現。但這裡的循環機制不同。在擴散模型中,系統通常是在潛在軌跡或最終樣本之間搜索。獎勵信號可以告訴模型某個輸出比另一個更好,但它無法把反饋清晰地映射到某個源碼級別的具體修改上。
程式碼原生生成創造了一種更精確的循環:程式碼 → 渲染 → 檢查 → 修改。
模型生成製品,將其渲染出來,觀察哪裡出了問題,然後修補源文件。如果間距不對,就修改 CSS;如果 logo 曲線有偏差,就編輯 SVG 路徑;如果動畫節奏太慢,就調整時間參數。關鍵在於,每一次迭代改善的都是底層製品,而不只是渲染後的輸出。這也是為什麼視覺程式碼生成天然能夠受益於更多 token 生成和 test-time compute。模型是在一個閉環、可驗證的環境中調試視覺程序,而不只是採樣更多圖片。
以程式碼為核心的視覺生成技術棧
上述範例背後,是這樣一套技術棧:編碼模型 + 符號表示 + 渲染器或引擎。
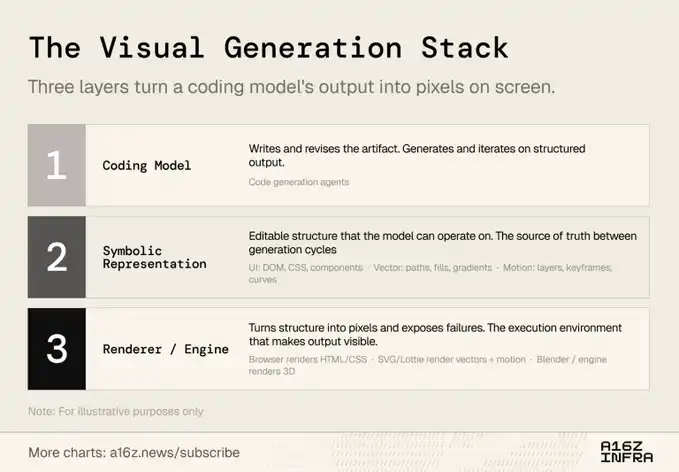
編碼模型是製品的作者和編輯者。它負責編寫 HTML、SVG、Lottie JSON、Blender 腳本、USD 場景,或定製的 3D 資產程序。
符號表示是事實來源。這正是製品具備可編輯性的原因。一個 UI 有 DOM 節點、版面規則和元件;一個 Lottie 動畫有圖層、向量形狀、時間曲線、關鍵幀和運動參數;一個 3D 資產有幾何結構、材質、關節、約束和層級關係。
渲染器或引擎則把這些結構轉化為像素。瀏覽器渲染 HTML/CSS,SVG 渲染器渲染向量圖,Lottie 播放器渲染動畫,Blender 或遊戲引擎渲染 3D 場景,模擬器則驗證一個帶有關節的資產是否真的能夠運動或互動。
OmniLottie 是一個很好的範例,說明了符號表示為什麼重要。Lottie 是一種輕量級、基於 JSON 的動畫格式,它不是把動畫表示為一段扁平視頻,而是用可編輯的向量形狀、圖層、關鍵幀和時間參數來表示運動。OmniLottie 提出將原始 Lottie JSON 轉換成更適合模型理解的命令序列,使模型能夠更可靠地生成和編輯 Lottie 動畫。這篇論文的重點並不是構建一個完整的 Agent 迴路,而是讓 Lottie 更適合模型生成:它把原始 Lottie JSON 轉換成一組緊湊的命令和參數序列。這個動作很關鍵,因為 Lottie 本身已經是一種可編輯的動畫格式。一旦運動被表示為形狀、圖層、時間和動畫參數,反饋就可以映射到源文件級別的修改上。如果物體移動得太慢,就調整時間;如果路徑不對,就修改向量;如果變形有偏差,就更新形狀序列。
這套技術棧對應的,正是編碼 Agent 可以用來提升輸出質量的 test-time compute 迴路:在每一次「程式碼 → 渲染 → 檢查 → 修改」的迴路中,模型並不是又生成了一個新樣本,而是在利用渲染器提供的反饋,改善底層製品。它可以修改 CSS 規則、調整 SVG 路徑、修正動畫時間,或更新 3D 約束,然後再次渲染,並繼續改進。
這讓循環具備了收斂的可能。在像素原生生成中,每次重試往往都會產生一個新的輸出。而在程式碼原生生成中,每次重試都可以改善源製品本身。模型不只是採樣更多圖像或視訊,而是在一個閉環、可渲染的環境中調試視覺程式。
市場地圖:圍繞執行時形成切入口
視覺程式碼生成市場正在圍繞「執行時」組織起來,也就是製品被渲染或執行的地方。在程式碼原生視覺生成中,模型生成的是一種符號製品,而這個製品會在某個環境裡被執行:瀏覽器、SVG 渲染器、Lottie 播放器、Blender、遊戲引擎或模擬器。
每一種執行時都會形成不同的切入口,因為每一種執行時都有自己的源表示、反饋循環和生產工作流。
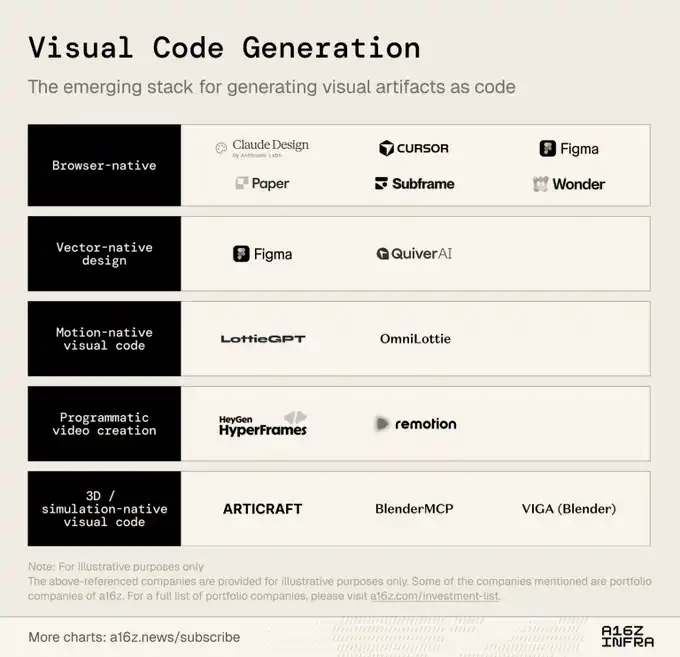
今天最明顯的應用是在 2D 設計領域,尤其是 UI 設計和平面設計。但視覺程式碼生成並不局限於設計工具。只要視覺製品背後存在一種可以被生成、渲染、檢查和優化的底層表示,它就可能出現。
為什麼 3D 是下一個重要前線
雖然產品設計和 2D 設計是今天最直觀的用例,但 3D 製品可能最能受益於這種「把一致性問題重新定義為編碼問題」的方式。
一個 2D 設計有時只要看起來正確,就已經有用。但 3D 資產不行。一張椅子的渲染圖並不是椅子,它只是椅子的圖片。若要讓這個資產在遊戲、模擬器或 3D 編輯工具中真正可用,它必須擁有一致的底層 3D 表示,包括正確的幾何結構、材質、部件層級和場景上下文。
這就是為什麼 3D 天然適合視覺程式碼生成。它的價值不只是生成一個從某個角度看起來像 3D 的東西,而是生成一個在不同視角、編輯和互動中都能成立的一致 3D 結構。這需要一個迭代循環:提出物件,渲染它,檢查幾何結構和部件是否合理,然後修改底層表示。但這個循環只有在 Agent 擁有正確工具和上下文時才有效。只是不斷運行 Blender,直到某個東西看起來更好,並不夠。Agent 需要能夠切換相機視角、查詢場景狀態、隔離物件、與目標進行比較、記住之前的嘗試,並把視覺差異轉化為源檔案級別的修改。正是這些能力,讓 test-time compute 有機會走向收斂。
對於許多資產來說,視覺一致性只是底線。物件還需要正確的部件語義和功能約束:門應該能夠打開,鉸鏈應該能夠旋轉,抽屜應該能夠滑動,輪子應該能夠轉動。換句話說,輸出不能只是一個看起來合理的形狀,它還必須像它所代表的東西一樣運作。
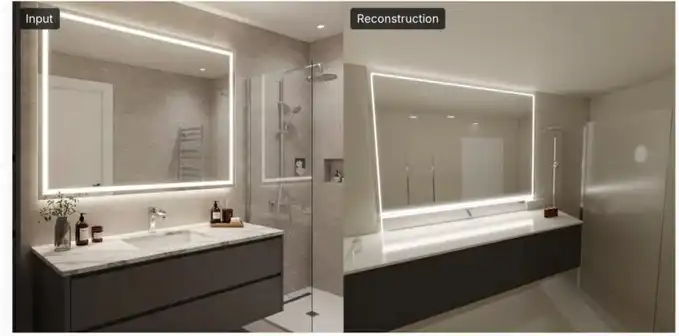
這正是 VIGA 和 Articraft3D 這類項目引人注目的地方。我們預計今年還會看到更多相關工作出現,包括商業化項目和開源項目。VIGA 使用 Blender 作為渲染和反饋環境,把視覺重建轉化為「碼—渲染—檢查」的循環;但 VIGA 並不是簡單地把原始 Blender 暴露給 Agent 循環。它為 Agent 提供了用於觀察和修改的語義工具,並保留對過往嘗試的記憶,使其能夠從更好的視角檢查物件、診斷問題,並進行有針對性的修改。Articraft3D 則更直接地處理資產結構:它把有關節的 3D 生成定義為編寫程序,這些程序負責定義部件、幾何結構、節和測試。
未來影響與未解問題
如果視覺碼生成真的成立,最終勝出的產品不會只是生成更漂亮的輸出。它們會掌握整個循環:生成製品、渲染製品、檢查哪裡出了問題,並修改源文件。
這會帶來幾個影響。
首先,渲染器會成為反饋環境。瀏覽器、SVG 渲染器、Lottie 播放器、Blender、遊戲引擎和模擬器,將成為 Agent 測試並改進作品的環境,就像今天編碼 Agent 正在利用沙盒和虛擬機一樣。
其次,迭代上下文的質量會變得比以往更加重要。要讓 Agent 進入視覺碼版本的「Ralph loop」,中間表示必須足夠精確,能夠指導下一步操作。模型需要知道的不只是「某個東西看起來不對」,還要知道應該修改源文件中的哪一部分,以及為什麼要這樣改。結構、渲染或反饋中的小錯誤,可能在多輪迭代中迅速累積。
第三,未來很可能是混合式的。像素原生模型仍然最擅長真實感、紋理和探索;碼原生系統則更適合結構、迭代和生產。最有用的工作流將會把二者結合起來。
當然,還有很多開放問題。每個領域最終會採用哪一種表示方式?我們是否需要重新打造引擎和渲染器,而不是繼續使用上一代工具?視覺品味在多大程度上能夠被約束、測試和反饋循環捕捉?
但方向已經很清楚:視覺 AI 正在從輸出走向程式碼產物。第一波浪潮讓生成圖像變得更容易;下一波浪潮將讓生成那些可編輯、可測試、可交付、可改進的視覺產物變得更容易。
[原文連結]
歡迎加入律動 BlockBeats 官方社群:
Telegram 訂閱群:https://t.me/theblockbeats
Telegram 交流群:https://t.me/BlockBeats_App
Twitter 官方帳號:https://twitter.com/BlockBeatsAsia
 相關文章